معالجة اللغات الطبيعية: كيف تعالج الحواسيب اللغة البشرية؟
من تحليل النصوص والترجمة الآلية إلى الذكاء الاصطناعي التوليدي والنماذج اللغوية الكبيرة.

معالجة اللغات الطبيعية (Natural Language Processing – NLP) مجال من علوم الحاسوب والذكاء الاصطناعي يطوّر أساليب تمكّن الحواسيب من تحليل اللغة البشرية ومعالجتها وتوليدها. اللغة المقصودة هنا هي اللغة الطبيعية، أي اللغة التي ينشأ عليها الناس ويتكلمونها ويكتبونها، لا لغات البرمجة ولا اللغات الصورية التي تُصمم بحيث يكون لكل عبارة بنية محددة ومعنى محسوب سلفًا.
أن يعالج الحاسوب اللغة لا يعني أنه يتلقاها بوصفها خبرة بشرية. الحاسوب يتلقى رموزًا: حروفًا وكلمات ونصوصًا، أو تمثيلات رقمية مشتقة منها. ثم يطبّق قواعد كتبها مختصون، أو يقدّر احتمالات استُخرجت من مدونات نصية، أو يمرر هذه التمثيلات عبر نموذج تعلّم أنماطًا من بيانات كثيرة. المخرج قد يكون وسمًا، أو اسمًا مستخرجًا، أو ترجمة، أو ملخصًا، أو ردًا مولَّدًا. النجاح في إخراج نص متماسك دليل على أن النظام أجاد مهمة محددة، وليس دليلًا على أنه يفهم المقصد والسياق والمعرفة السابقة بالطريقة التي يفهم بها الإنسان.
تزداد أهمية هذا التمييز كلما أصبحت الأنظمة أقدر على الكتابة. الطلاقة اللغوية والصحة الواقعية ليستا الشيء نفسه، وتحليل نص موجود غير توليد نص جديد، والنموذج اللغوي الكبير مرحلة متقدمة داخل المجال لا اسمًا آخر له. وفي العربية تظهر هذه الفروق بصورة عملية: الكلمة قد تحمل لواصق عدة، والتشكيل غالبًا غائب، والفصحى واللهجات تتقاطع في الاستعمال اليومي، فلا يكفي نقل الأدوات المصممة للإنجليزية نقلًا مباشرًا.
- حوّل النص إلى وحدات ثم أرقام: التقسيم والتمثيل الرقمي أساس كل نظام لغوي.
- افهم الانتباه: تمنح المحولات (Transformers، 2017) كل كلمة وزنًا بحسب صلتها بغيرها.
- اربط النموذج بمصادر: التوليد المعزز بالاسترجاع (RAG) يقلل الأخطاء بجلب وثائق موثوقة.
- استخدمها في الترجمة الآلية وتلخيص النصوص والإجابة عن الأسئلة.
- قِس الجودة بأكثر من مقياس: F1 وBLEU وROUGE وBERTScore.
- اختبر النموذج على العربية ولهجاتها قبل الاعتماد عليه.
- فصل اللواصق في مدونة تضم 600,000,000 كلمة خفّض الأشكال الفريدة من 2,207,637 إلى 1,665,899، أي -24.54%.
- الطلاقة لا تعني الصحة: راجع المصادر، ولا تكتفِ بنتيجة اختبار واحد.
معالجة اللغات الطبيعية باختصار
تعمل معالجة اللغات الطبيعية، في صورتها الأعم، بتحويل النص إلى تمثيل يستطيع النظام حسابه، ثم باستخدام هذا التمثيل لاستخراج معلومة أو اتخاذ قرار أو إنتاج لغة. قد يكون التمثيل بسيطًا، كعدّ مرات ظهور الكلمات، وقد يكون متجهات تتغير بحسب السياق داخل شبكة عصبية عميقة.
المهام كثيرة وليست مراحل لنظام واحد. من بينها ترجمة النصوص، وتلخيصها، والتعرف على المشاعر، وتصنيف المستندات، واستخراج الأسماء والعلاقات، والإجابة عن الأسئلة، وإكمال الجمل، وإدارة حوار. يظهر ذلك في محركات البحث، والمساعدات الصوتية والنصية، وأنظمة الترجمة، ومدققات الكتابة، وأدوات خدمة العملاء، وتحليل التعليقات، وفرز الوثائق.
استندت الأنظمة المبكرة إلى قواميس وقواعد صرفية ونحوية. ثم اتسع الاعتماد على الإحصاء ومدونات النص. وبعد ذلك صار تعلم الآلة، ثم التعلم العميق، ثم بنية المحولات، الأساس العملي لكثير من التطبيقات. النماذج اللغوية الكبيرة حلقة متأخرة في هذا المسار: نماذج دُربت على كميات واسعة من النص، وصار بعضها قادرًا على أداء مهام عدة بصياغة تعليمات باللغة الطبيعية. هي جزء من معالجة اللغات الطبيعية، لا الميدان كله.
تبقى اللغة صعبة لأن المعنى لا يلتصق بالكلمة التصاقًا واحدًا. الكلمة تتعدد معانيها، والجملة تحتمل أكثر من إعراب، والسخرية تنقلب بالمقام، واللهجة تتغير بين مدينة وأخرى. لذلك فإن إنتاج نص مقنع لا يساوي فهمًا بشريًا للغة.
نقاط يجدر أن تبقى في الذهن
- المجال أوسع من المحادثة الآلية: معالجة اللغات الطبيعية تتيح للحاسوب التعامل مع اللغة البشرية تحليلًا وتصنيفًا وترجمة وتوليدًا واسترجاعًا، لا عبر روبوتات الدردشة وحدها.
- الفهم والتوليد مهمتان مختلفتان: استخراج المعنى أو المقصد من نص ليس كإنتاج نص جديد، وإن اجتمعا في نظام واحد.
- التقنيات تراكمت ولا ألغى آخرها أولها: المسار امتد من القواعد إلى الإحصاء وتعلم الآلة والتعلم العميق والمحولات، وما زالت بعض القواعد والأدوات اللغوية ضرورية في مهام دقيقة.
- النماذج الكبيرة مرحلة لا تعريف: النماذج اللغوية الكبيرة تطور مهم داخل المجال، لكنها لا تختزل تحليل الصرف ولا تصميم البيانات ولا مقاييس التقييم.
- العربية ليست «إنجليزية بحروف أخرى»: الغنى الصرفي، وغياب التشكيل في أغلب النصوص، وتعدد اللهجات، واختلاف الإملاء، تغيّر تصميم التقطيع والبحث والترجمة والتقييم.
- لا مقياس واحد لكل الأنظمة: دقة التصنيف، وBLEU للترجمة، وROUGE للتلخيص، والحيرة لنموذج اللغة، لكل منها ما يقيسه وما يتركه خارج القياس.
- سلاسة النص ليست فهمًا ولا صدقًا: قد ينتج النظام جملة سليمة ومعلومة خاطئة، لأن الاحتمال اللغوي غير مطابقة الواقع.
ما المقصود بمعالجة اللغات الطبيعية؟
تعريف معالجة اللغات الطبيعية
التعريف العملي الذي تستقر عليه المراجع الجامعية، وفي مقدمتها كتاب Speech and Language Processing لدان جورفسكي وجيمس مارتن، هو أن المجال يعنى بالمناهج الحاسوبية التي تتعامل مع الكلام والكتابة البشريين من أجل التحليل والتفسير والتوليد. بعض التعريفات تميل إلى الجانب الهندسي: بناء أنظمة مفيدة. وبعضها يفتح على الجانب العلمي: اختبار أفكار عن اللغة عبر نماذج قابلة للتشغيل. الاسمان يتجاوران، لكن مركز الثقل ليس واحدًا، كما سيظهر عند الحديث عن اللسانيات الحاسوبية.
اللغة الطبيعية مكتسبة اجتماعيًا، تحتمل اللبس، ويتغير معناها بالسياق وبمعرفة المتكلمين بعضهما ببعض. لغة البرمجة، في المقابل، مصممة ليكون تركيبها قابلًا للتحليل الآلي بمعنًى يحدده توصيف اللغة. حين يقرأ المترجم البرمجي تعليمة، فالمطلوب سلوك محدد. وحين يقرأ الإنسان جملة «تمام»، فقد تكون موافقة أو تهربًا أو سخرية. الحاسوب لا يرث هذا التمييز. إن لم يُبنَ له مسار يحول الرموز إلى تمثيل، ثم يربط التمثيل بمهمة، فالنص عنده سلسلة محارف لا غير.
تحويل الكلمات إلى بيانات يمر عادة بتفكيك النص إلى وحدات، ثم بتمثيل هذه الوحدات بأعداد. الأعداد قد تكون معرفات في معجم، أو أوزانًا لتكرار الكلمة، أو متجهات كثيفة تتعلم من السياقات التي ظهرت فيها الكلمة. ما يُحسب بعد ذلك هو علاقة بين تمثيلات: هل هذا النص أقرب إلى الشكوى أم إلى الاستفسار؟ ما الترجمة الأرجح لهذه الجملة؟ ما الرمز الأرجح بعد هذه المقدمة؟ هذا حساب على رموز وعلاقات، وليس اطلاعًا مباشرًا على «المعنى» كما يعيشه المتكلم.
من هنا يأتي فرق دقيق يكثر تجاهله. التعامل مع الرموز اللغوية ممكن حتى حين يكون الفهم ناقصًا. نظام قد يرتب وثائق بحث ترتيبًا نافعًا لأنه تعلم قربًا دلاليًا بين عبارات، ويخفق في الوقت نفسه في تمييز تلميح ساخر أو إحالة ثقافية. التمثيل اللغوي النافع ليس مرادفًا للفهم البشري. هذه النتيجة تعود بقوة في نقاش النماذج الكبيرة، وقد صاغها بندر وكولر صياغة مؤثرة عام 2020 حين ميزا بين إتقان الشكل اللغوي والوصول إلى المعنى بمعناه التداولي.
لماذا تُعد اللغة البشرية صعبة المعالجة حاسوبيًا؟
الصعوبة الأولى تعدد المعنى. كلمة «عين» قد تكون عضو البصر، أو نبع الماء، أو الجاسوس، والسياق وحده هو الذي يرجح. والصعوبة الثانية تركيبية. في جملة «شاهدتُ الرجل بالمنظار» قد يكون المنظار أداة الرؤية، وقد يكون صفة للرجل الذي يحمل منظارًا. التحليلان النحويان مقبولان قبل أن يحسمهما المقام.
ثم يأتي الفرق بين المعنى الحرفي والمعنى المقصود. «إذا سمحت» قد تكون إذنًا حقيقيًا أو مجاملة تمهّد للرفض. التعابير الاصطلاحية لا تُجمع من أجزائها جمعًا حرًا: «رجع بخفي حنين» لا تُفهم من الخف والحنين بمعناهما المعجمي المباشر. السخرية أشد مراوغة، لأن الكلمات قد تكون إيجابية والمعنى سلبيًا: «ما أروع هذا التأخير!» قد تكون مدحًا نادرًا أو تذمرًا بحسب الموقف.
المعنى يعتمد أيضًا على معرفة لا توجد داخل الجملة. فهم «وصل قبل الآذان بدقيقة» يحتاج معرفة بأن الآذان موعد، لا مجرد كلمة. والمتكلمون لا يصوغون الفكرة الواحدة صياغة واحدة: الشكوى من تأخر شحنة قد تُكتب بالفصحى في رسالة رسمية، وبالدارجة في محادثة، وبخليط عربي–إنجليزي في تطبيق دردشة. النظام الذي رأى نمطًا واحدًا من هذه الأنماط لم يرَ الظاهرة كاملة.
هذه ليست استثناءات أدبية تُضاف إلى لغة منتظمة في الأصل. اللبس خاصية دائمة في اللغات البشرية، وأنظمة المعالجة تتعامل معه بتقريبه: إما بحفظ قراءة واحدة يرجحها السياق، وإما بإبقاء أكثر من تحليل إلى أن تأتي مهمة لاحقة فتحسم.
العلاقة بين معالجة اللغات الطبيعية والتخصصات الأخرى
الذكاء الاصطناعي هو الإطار الأوسع: بناء أنظمة تنجز مهام تحتاج من الإنسان إلى إدراك أو استدلال أو قرار. تحت هذا الإطار تقع الرؤية الحاسوبية، والتخطيط، وتعلم الآلة، ومعالجة اللغة، وغيرها. معالجة اللغات الطبيعية فرع تطبيقي داخل هذا الإطار، ليست مرادفًا للذكاء الاصطناعي. نظام يتعرف على صور الأشعة، ولا يمس نصًا، نظام ذكاء اصطناعي خارج هذا المجال.
تعلم الآلة مجموعة أساليب تستخرج أنماطًا من البيانات وتستخدمها في التوقع. هو أداة تستخدم داخل معالجة اللغة وفي الطب والتمويل والرؤية أيضًا. التعلم العميق فرع منه يعتمد شبكات عصبية متعددة الطبقات تتعلم تمثيلاتها الداخلية، بدل الاعتماد الكامل على خصائص يصممها المهندس يدويًا.
اللسانيات الحاسوبية تتداخل مع معالجة اللغات الطبيعية تداخلًا واسعًا، وليست اسمًا ثانيًا لها. اللسانيات الحاسوبية أشد عناية بسؤال اللغة نفسها: هل يطابق هذا التحليل النظرية الصرفية؟ ماذا يكشف خطأ الإعراب الآلي عن تركيب الجملة؟ معالجة اللغات الطبيعية أشد عناية بإنجاز المهمة: هل ارتفعت جودة الترجمة؟ هل قَلّ زمن البحث؟ الباحث الواحد قد يعمل في المنطقتين، لكن تقييم ورقة نظرية في الصرف غير تقييم نظام خدمة عملاء.
داخل المجال نفسه يُفصل غالبًا بين فهم اللغة الطبيعية (Natural Language Understanding – NLU) وتوليد اللغة الطبيعية (Natural Language Generation – NLG). الفهم، بمعناه الهندسي لا بمعناه الفلسفي الكامل، يشمل استخراج الوسم والكيان والمقصد والعلاقة والإجابة من نص موجود. التوليد إنتاج نص من بيانات منظمة أو من نص آخر أو من تعليمات: ترجمة، تلخيص، إعادة صياغة، رد حواري. كثير من الأنظمة المعاصرة يفعل الأمرين، لكن فشل أحدهما لا يُقاس بمقياس الآخر.
| المفهوم | ما الذي يميزه؟ |
|---|---|
| معالجة اللغات الطبيعية | بناء أنظمة تحلل اللغة أو تنتجها لأداء مهمة |
| اللسانيات الحاسوبية | دراسة اللغة بنماذج حاسوبية، مع ثقل للسؤال اللغوي |
| فهم اللغة الطبيعية | استخراج معلومة أو قصد أو بنية من نص |
| توليد اللغة الطبيعية | إنتاج نص من تمثيل أو نص أو تعليمات |
| تعلم الآلة | أساليب تتعلم أنماطًا من أمثلة، وتُستخدم هنا أداةً لا ميدانًا لغويًا بديلًا |
اقرأ أيضاً:
- التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
- علم البيانات: الركيزة العلمية لقيادة الذكاء الاصطناعي وصناعة القرار
ما المهام التي تستطيع معالجة اللغات الطبيعية تنفيذها؟
المهام التالية قدرات يمكن تركيبها بحسب التطبيق. ليست سلمًا يمر به كل نص، ولا يشترط نظام الترجمة أن يحتوي مُصنّف مشاعر.
تحليل النصوص واستخراج المعلومات منها
تبدأ كثير من الأنظمة بالتعرف على لغة النص، لأن الأدوات والمعاجم تختلف بين اللغات. ثم يُقسم النص إلى جمل ووحدات أصغر. في اللغات ذات الحدود الإملائية الواضحة يبدو التقسيم يسيرًا، وفي العربية تتصل واو العطف وأداة التعريف والضمائر بالكلمة، فيصير قرار «ما حدود الوحدة؟» جزءًا من التحليل لا تمهيدًا شكليًا له.
التحليل الصرفي يفكك الكلمة إلى جذر أو جذع ولواصق وسمات مثل الجنس والعدد والشخص. وسم أقسام الكلام (Part-of-Speech Tagging) يضع لكل وحدة وسمًا: فعل، اسم، حرف جر. التحليل التركيبي (Syntactic Parsing) يبني بنية للجملة، إما شجرة مكوّنات وإما علاقات تبعية بين الكلمات، كعلاقة الفاعل بالفعل.
التعرف على الكيانات المسماة (Named Entity Recognition) يحدد أسماء الأشخاص والأماكن والمؤسسات والمنتجات والمبالغ والتواريخ. في الإنجليزية يستفيد كثير من الأنظمة من الحرف الكبير في أول الاسم. العربية لا تملك هذا الدليل الإملائي، فتمييز «رام الله» بوصفها مكانًا، أو تمييز اسم شخص يطابق كلمة عامة، يعتمد على السياق والمعجم لا على شكل الحرف.
بعد الكيانات يمكن استخراج العلاقات: أي مؤسسة تدير أي مشروع، وأي شخص يعمل في أي جهة. حل الإحالة (Coreference Resolution) يربط الضمائر والعبارات بما تشير إليه. في «التقت سعاد بليلى وقالت لها إن البحث جاهز» لا تكفي القواعد المحلية لمعرفة القائلة على وجه اليقين. هذه المهام هي قوام استخراج المعلومات من العقود والأخبار والسجلات.
تحديد المعنى والموضوع والمقصد
تحليل المشاعر يقدّر الاتجاه الوجداني للنص، إيجابًا أو سلبًا أو حيادًا، وأحيانًا بدرجات أدق كالغضب أو الرضا. التصنيف الموضوعي يضع النص في باب: رياضة، شكوى فواتير، سؤال تقني. التعرف على القصد يحدد ما يريده المستخدم من النظام: الاستعلام عن الرصيد غير الاعتراض على الرصيد، وإن تشابهت الكلمات.
رفع اللبس الدلالي يختار معنى الكلمة المناسبة لسياقها. الإجابة عن الأسئلة تبحث عن مقطع يدعم الجواب، أو تولّد جوابًا، وهذان تصميمان مختلفان. اكتشاف العلاقة الدلالية بين جملتين يسأل: هل تستلزم الأولى الثانية، أم تناقضها، أم لا علاقة بينهما؟ هذه المهام أقرب إلى «الفهم» بالمعنى الهندسي، لأنها تتجاوز شكل الكلمة إلى قرار عن المحتوى.
تحويل النصوص وإنتاج نصوص جديدة
الترجمة الآلية تحوّل نصًا من لغة إلى أخرى. التلخيص يضغط نصًا طويلًا، إما باقتطاع جمل منه (تلخيص استخلاصي) وإما بصياغة جديدة (تلخيص تجريدي). إعادة الصياغة تغيّر المبنى وتطلب حفظ المعنى، وهو مطلب أصعب مما يوحي به شيوع الأداة. التدقيق الإملائي والنحوي يقارن النص بتوقعات لغوية أو بقواعد. الإكمال التلقائي يرجّح تتمة الجملة. توليد النص من تعليمات ينتج مسودة أو وصفًا أو حوارًا. تحويل جدول إلى جملة مفيدة نوع من التوليد المقيد بالبيانات، لا من الكتابة الحرة.
في كل هذه المهام، المدخل والمخرج نصان أو نص وتمثيل، لكن معيار النجاح يختلف. ترجمة تنقل المعنى بجملة غير مألوفة قد تتفوق على ترجمة تطابق كلمات المرجع تطابقًا حرفيًا وتضيّع المقصود.
البحث عن المعلومات واسترجاعها
البحث التقليدي يطابق كلمات الاستعلام بكلمات الوثائق، مع تعديلات مثل إزالة الكلمات الشائعة ووزن ندرة الكلمة. البحث الدلالي يحاول مطابقة المعنى حتى لو اختلفت الألفاظ: من يبحث عن «تأخير الطلب» قد يحتاج وثائق تتحدث عن «الشحنة لم تصل». أنظمة الاسترجاع الحديثة قد تمثل الاستعلام والوثيقة في فضاء متجهات واحد، فتقارن القرب لا التطابق الحرفي.
ترتيب النتائج مهمة مستقلة: ليس كل وثيقة تحتوي كلمات الاستعلام مفيدة بالدرجة نفسها. واستخراج المقطع المناسب من وثيقة طويلة يختلف عن إرجاع الوثيقة كلها. محركات البحث التجارية تجمع اليوم بين المطابقة اللفظية والإشارات الدلالية وسلوك المستخدمين، فلا تُختزل في خوارزمية واحدة ظاهرة للمستخدم.
كيف تعمل معالجة اللغات الطبيعية؟
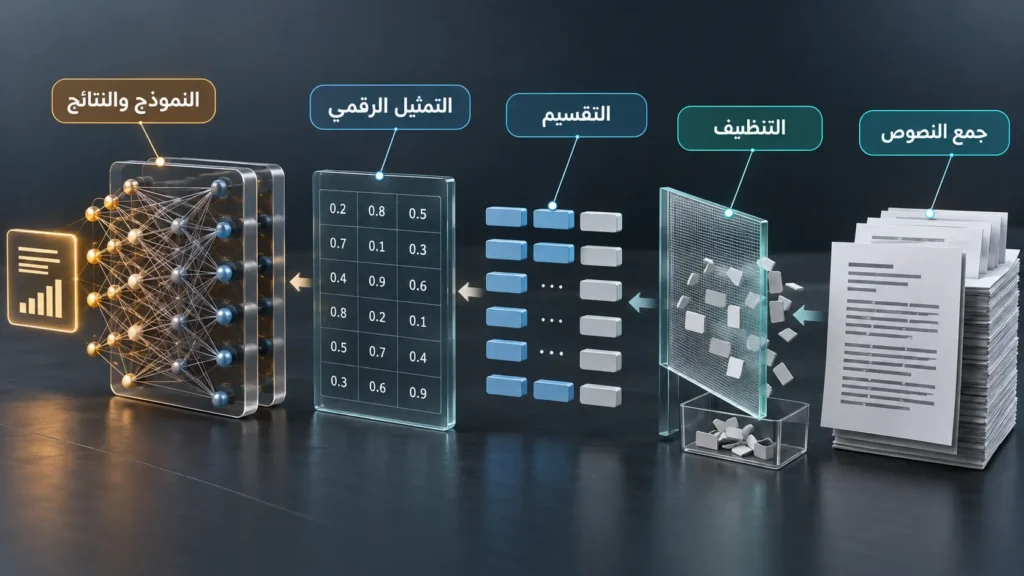
المسار التالي يفكك المشكلة إلى خطوات يمكن فهمها. ليس خط إنتاج إلزاميًا. الأنظمة القواعدية تتوقف عند القواعد. والنماذج العميقة تتعلم تمثيلات داخلية قد تستغني عن التجذيع اليدوي وعن كثير من الهندسة التقليدية. مع ذلك، تبقى الخطوات الست خريطة ذهنية صالحة، لأن كل نظام ما زال يواجه الأسئلة نفسها: من أين يأتي النص؟ ما الوحدة؟ كيف يصير عددًا؟ ماذا يُتعلم؟ وماذا يحدث عند الاستخدام؟
المثال الإيضاحي الذي سيمر عبر الخطوات جملة خدمة عملاء ليست سجلًا حقيقيًا لشركة، بل مثالًا مصطنعًا للشرح: «تأخر وصول الشحنة إلى عمّان والعلبة مكسورة».
الخطوة الأولى: جمع النصوص والبيانات اللغوية
المدونة اللغوية (Text Corpus) مجموعة نصوص تُجمع لغرض الدراسة أو التدريب. قد تأتي من كتب، أو مواقع، أو صحف، أو موسوعات، أو محادثات بعد إذن أصحابها، أو من نصوص أُنتجت خصيصًا للبحث كالترجمات المتوازية. البيانات غير المصنفة تكفي لبعض أساليب التعلم التي تصنع سؤالها من النص نفسه، كالتنبؤ بالكلمة الناقصة. البيانات المصنفة تحمل حكمًا بشريًا: هذه شكوى، وهذا اسم مكان، وهذه الترجمة مقبولة.
جودة المدونة ليست حجمها فقط. المطلوب أن تمثل اللغة والمهمة. مدونة أخبار فصيحة لا تعلّم نظامًا سيقرأ شكاوى باللهجة. والتعليق اللغوي (Data Annotation) نفسه قياس بشري له حدود: إذا اختلف المعلقون في وسم السخرية، فسقف أداء النظام محدود بجودة الوسم لا بقوة الخوارزمية وحدها.
في المثال، تحتاج مهمة تصنيف الشكاوى إلى آلاف الرسائل الموسومة، لا إلى الجملة الواحدة. والجملة التي تذكر «عمّان» لا تكفي ليتعلم نظام الكيانات أسماء المدن.
الخطوة الثانية: تنظيف النصوص ومعالجتها الأولية
التنظيف إزالة ما يضر المهمة أو توحيد ما يُعد اختلافًا شكليًا. قد تُحذف وسوم HTML من صفحة منتزعة من الويب، أو تُوحَّد الأرقام، أو تُعالج علامات الترقيم. التطبيع (Text Normalization) يجعل أشكالًا متكافئة تُعامل معاملة واحدة: توحيد بعض صور الألف، أو إزالة التطويل، أو توحيد المسافات.
التجذير (Stemming) يقص الزوائد بقواعد تقريبية ليرد الكلمات إلى جذع مشترك، حتى لو لم يكن الجذع كلمة معجمية سليمة. الرد إلى المفردة المعجمية، أو التجريد (Lemmatization)، يستخدم معرفة لغوية ليرد الكلمة إلى مدخل المعجم: أشكال الفعل المختلفة إلى صورته الأساسية، مع تمييز ما يجب ألا يُدمج. التجذير أسرع وأخشن. التجريد أدق وأغلى لأنه يحتاج تحليلًا.
النماذج العميقة لا تمر كلها بهذه الخطوات كما كانت أنظمة التسعينيات تفعل. كثير منها يتعلم من النص الخام نسبيًا عبر تقطيع وحدات فرعية. هذا لا يلغي التنظيف، لكنه يغيّر موضعه: القرار الخاطئ في التطبيع قد يحذف معلومة كان النموذج قادرًا على استخدامها. في المثال، الإبقاء على «عمّان» بهمزة أو بغيرها قرار تطبيع، وفصله عن تحليل اسم المدينة قرار مهم لمرحلة الكيانات.
الخطوة الثالثة: تقسيم النص إلى وحدات لغوية
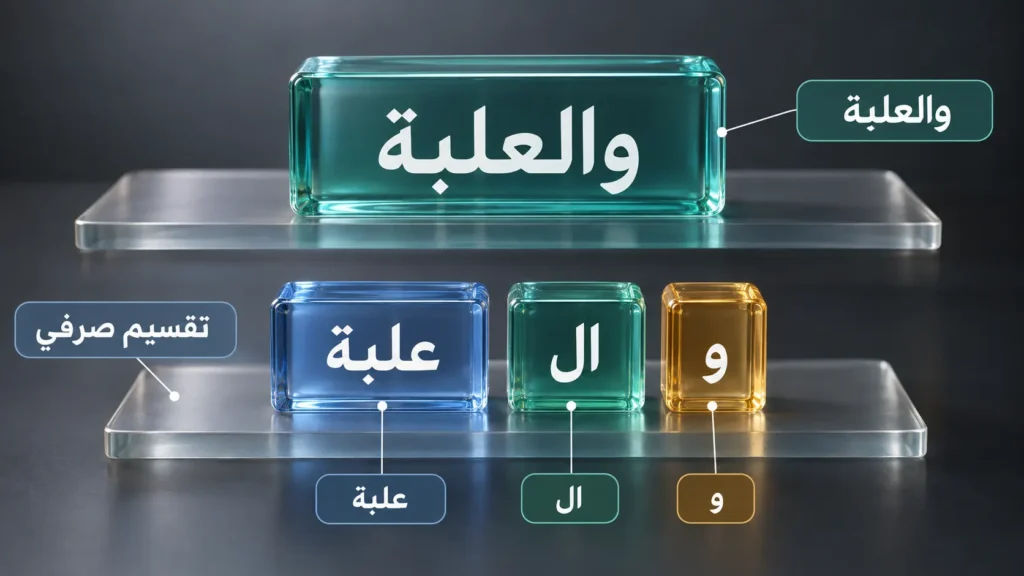
الرمز الحاسوبي (Token) وحدة دخل النموذج، وليس بالضرورة كلمة بالمعنى الذي يعرفه القارئ. قد يكون كلمة، أو جزء كلمة، أو حرفًا، أو علامة ترقيم. التقسيم المعتمد على المسافات يعدّ «والعلبة» كلمة واحدة. والتقسيم الصرفي قد يفصل واو العطف وأداة التعريف عن الاسم. والتقسيم إلى وحدات فرعية، كما في خوارزمية ترميز أزواج البايتات (Byte Pair Encoding – BPE) التي أشاعها في الترجمة العصبية سينريش وهادو وبيرش عام 2016، يبدأ من حروف أو وحدات صغيرة ويدمج الأزواج الأكثر تكرارًا حتى يبلغ حجم معجم محدد. أسلوب WordPiece قريب من هذه الفكرة واشتهر مع نماذج الترجمة من جوجل ثم مع BERT.
لذلك قد تتحول كلمة واحدة نادرة، أو اسم علم، أو كلمة طويلة اتصلت بها اللواصق، إلى عدة رموز داخل النموذج. الفائدة أن النظام لا ينهار أمام كلمة لم يرها كاملة: يعيد تركيبها من أجزاء مألوفة. والثمن أن «الكلمة» لم تعد الوحدة التي تُحسب عليها القرارات دائمًا. في اللغات الغنية صرفيًا، ومنها العربية، تصميم هذا التقسيم يؤثر في التعامل مع النادر والمتصل والمكتوب بأكثر من شكل. أي تقسيم أذكره لجملة الشحنة هنا تقسيم إيضاحي، لا مخرجًا لنموذج بعينه: «والعلبة» قد تبقى كتلة واحدة، أو تُقسم إلى «و» و«ال» و«علبة»، أو إلى أجزاء لا تطابق الحدود الصرفية.
الخطوة الرابعة: تحويل اللغة إلى تمثيلات رقمية
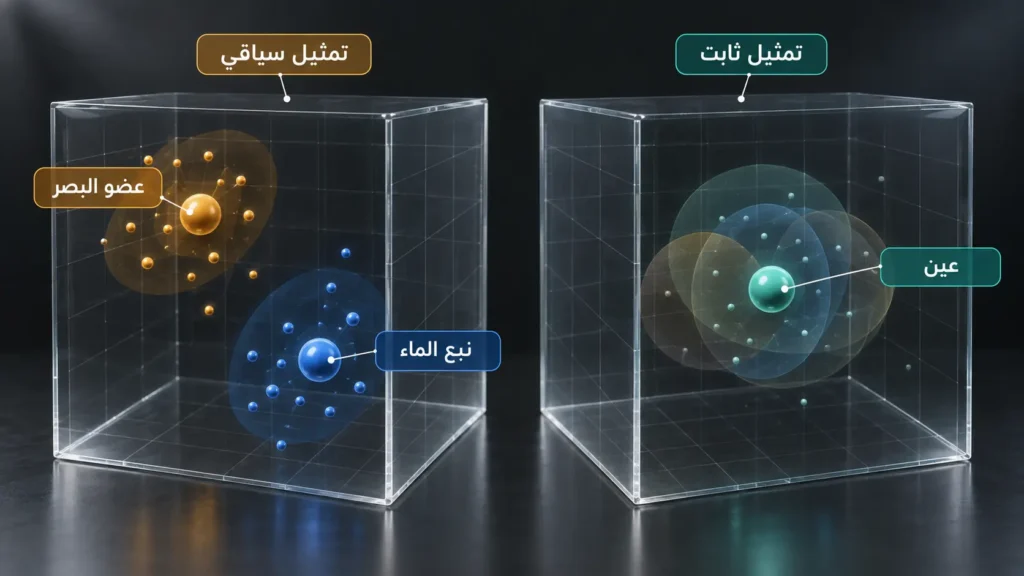
الخوارزمية لا تستقبل «معنى التأخر» استقبالًا مجردًا. تستقبل أعدادًا. أبسط التمثيلات نموذج حقيبة الكلمات (Bag of Words): إحصاء حضور الكلمات مع إهمال الترتيب. عندئذٍ تتطابق «العلبة كسرت الشحنة» مع «الشحنة كسرت العلبة» إن حوت الكلمات نفسها، وهذا عيب جوهري حين يكون الترتيب هو المعنى.
وزن TF-IDF يعدّل التكرار داخل الوثيقة بمدى شيوع الكلمة في المدونة كلها. الكلمات التي تظهر في كل الوثائق، مثل بعض حروف الجر، تنخفض أهميتها، والكلمات المميزة للوثيقة ترتفع. هذا تمثيل قوي للبحث والتصنيف الكلاسي، لكنه ما زال فقيرًا دلاليًا: «متأخرة» و«لم تصل في موعدها» قد لا تتقاربان.
التمثيلات المتجهية (Word Embeddings) تضع كل كلمة في متجه كثيف، بحيث تتقارب الكلمات التي تظهر في سياقات متشابهة. هذه فكرة توزيعية قديمة في اللسانيات، صارت عملية على نطاق واسع مع Word2Vec الذي طرحه ميكولوف وزملاؤه عام 2013، ومع GloVe الذي طرحه بنينغتون وسوتشر ومانينغ عام 2014. المسافة بين المتجهات تُستخدم تقريبًا للتشابه. غير أن هذا التمثيل ثابت: لكل مفردة معجمية متجه واحد. كلمة «عين» تُضغط في نقطة واحدة تمزج معانيها.
التمثيلات السياقية (Contextual Embeddings) تعطي حدوث الكلمة متجهًا يعتمد على الجملة المحيطة. ELMo، الذي قُدم عام 2018، كان خطوة واسعة في هذا الاتجاه، ثم جاءت المحولات فجعلت التمثيل السياقي وضعًا افتراضيًا في كثير من الأنظمة. عندها يمكن لـ«عمّان» في سياق الشحنة أن تقترب من المدن، لا من مجرد سلسلة حروف تشبه كلمات أخرى.
الخطوة الخامسة: تحليل البيانات باستخدام نموذج حاسوبي
بعد أن يصير النص أعدادًا، يستقبلها النموذج ويقدّر علاقات بين الوحدات. المخرج يتبع المهمة. في تصنيف الشكوى، المخرج توزيع احتمالات على أبواب. في التعرف على الكيانات، المخرج وسم لكل وحدة: «عمّان» مكان، وبقية الكلمات خارج الكيانات. في الترجمة أو التوليد، المخرج توزيع على الرمز التالي، يُعاد استخدامه لبناء الجملة.
النموذج لا «يعرف» أن التأخر حدث مزعج بمعرفته للعالم إلا بقدر ما انعكس ذلك في البيانات. إن كانت رسائل التدريب تربط «متأخرة» و«مكسورة» بباب الشكاوى، فالقرار نمط إحصائي مفيد، قابل للكسر إن تغير الأسلوب أو سخر العميل مدحًا ظاهريًا.
الخطوة السادسة: تدريب النموذج وإنتاج النتائج
التدريب (Training) تعديل معاملات النموذج اعتمادًا على أمثلة. في التعلم الخاضع للإشراف، تُقارن نتيجة النموذج بالوسم الصحيح ويُقاس الخطأ، ثم تُحدَّث المعاملات بما يقلل هذا الخطأ. في تعلم نموذج اللغة، الخطأ غالبًا فرق بين التوزيع المتوقع والرمز الذي ظهر فعلًا في النص. الاستدلال (Inference) استخدام النموذج بعد تثبيت معاملاته على مدخل جديد، من دون هذا التحديث.
النتائج تتغير بتغير الصياغة لأن التمثيل تغير. «العلبة مكسورة» و«فيه كسر بالصندوق» قد تحملان القصد نفسه، فإن لم يكن التدريب قد رأى ما يكفي من هذا التنوع فسيختلف احتمال تصنيف الشكوى. وهذا متوقع في نظام يعتمد على الأنماط، لا نقصًا عرضيًا يمكن تجاهله.
النماذج العميقة الحديثة تطوي كثيرًا من هذه الخطوات داخل تدريب واحد: تتعلم التقسيم عبر معجم وحدات فرعية، وتتعلم التمثيل السياقي، وتتعلم القرار، من غير أن يمر المهندس بكل مرحلة كبرنامج مستقل. فهم المراحل يظل ضروريًا لتشخيص الخطأ: هل الخطأ من البيانات، أم من حذف التشكيل، أم من مقياس لا يناسب المهمة؟
اقرأ أيضاً:
- تحليل البيانات: المنهجية العملية لتحويل الأرقام إلى قرارات إستراتيجية
- تنقيب البيانات: الفن العلمي لاكتشاف الأنماط الخفية في الكتل الرقمية
- هندسة البيانات: الشريان المعماري لبناء منظومات الذكاء الاصطناعي
ما الأساليب والخوارزميات المستخدمة في معالجة اللغات الطبيعية؟
الأنظمة القائمة على القواعد اللغوية
المعالجة المعتمدة على القواعد تستخدم قواميس ومعرفة صرفية ونحوية يكتبها مختصون، أو أنماطًا تُصاغ باليد: إذا بدأت العبارة بكذا وكانت الكلمة التالية اسم مدينة، فصنّفها مكانًا. هذه الأنظمة شفافة، ويمكن تصحيح قاعدة معروفة، وتجيد المهام الضيقة المستقرة، كاستخراج تاريخ بصيغة محددة أو تطبيق قيد لغوي صارم.
هشاشتها تظهر حين تتنوع اللغة. لا قاعدة يدوية تستوعب كل مجاز وكل خطأ إملائي وكل لهجة. تكلفة الإضافة ترتفع، والتداخل بين القواعد يصير عبئًا. القواعد لم تمت في الأنظمة الحديثة؛ ما زالت تُستخدم في التطبيع، والمرشحات، وقيود السلامة، وأدوات التحليل التي تحتاج تفسيرًا لغويًا صريحًا. الذي تراجع هو الاكتفاء بها لمهام مفتوحة كالحوار والترجمة العامة.
المعالجة الإحصائية للغات الطبيعية
الإحصاء يسأل عن التكرار لا عن القاعدة المكتوبة. نموذج N-grams يقدّر احتمال الكلمة بالنظر إلى عدد محدود من الكلمات السابقة. نافذة الثلاثيات، مثلًا، ترى تاريخًا قصيرًا فقط. هذا التقريب صنع مدققات إملائية ونماذج ترجمة إحصائية قوية في تسعينيات القرن العشرين وبداية الألفية، ومن أصوله النظرية ما صاغه براون وزملاؤه في رياضيات الترجمة الإحصائية عام 1993.
نماذج ماركوف المخفية (Hidden Markov Models) تتعامل مع سلسلة ملاحظات ظاهرة، كالكلمات، وسلسلة حالات خفية، كأقسام الكلام، وتقدير الانتقال بين الحالات. الحقول العشوائية الشرطية (Conditional Random Fields)، التي قدمها لافرتي وماكالوم وبيريرا عام 2001، تتيح وسم السلاسل مع النظر إلى سمات مترابطة، وصارت أداة قياسية في وسم الكيانات قبل الشبكات العميقة.
الفرق عن القواعد أن الاحتمال يُستخرج من البيانات. النظام قد ينجح في نمط لم يكتبه أحد صراحة، ويخفق حيث البيانات صامتة أو منحازة. وهو لا «يفهم» الاستثناء اللغوي؛ يرجّح ما كان أشيع في المدونة.
تعلم الآلة التقليدي في معالجة اللغة
حين تتوفر أمثلة موسومة، تتعلم خوارزميات التصنيف حدًا فاصلًا بين الأبواب. مُصنّف بايز الساذج (Naive Bayes) يقدّر احتمال الباب بالنظر إلى الكلمات مع افتراض تبسيطي هو استقلالها عند تثبيت الباب، وهو افتراض خاطئ لغويًا ومفيد عمليًا في تصنيف النصوص. آلات المتجهات الداعمة (Support Vector Machines) تبحث عن فاصل بهوامش واسعة في فضاء الخصائص، وارتبطت بتصنيف النصوص منذ أواخر التسعينيات. أشجار القرار تقسم البيانات بأسئلة متتابعة، وتُقرأ بسهولة نسبية، وإن كانت غير مستقرة أمام تغيرات صغيرة ما لم تُجمَّع في غابات عشوائية.
هذه الأساليب تعتمد عادة على خصائص يصممها الإنسان: وجود كلمات معينة، أوزان TF-IDF، سمات صرفية، طول الجملة. قوتها في البيانات المتوسطة والحاجة إلى تفسير. حدها أن جودة النظام مرهونة بجودة الخصائص، وأن التقاط التركيب البعيد والسياق الدقيق يصير عملًا يدويًا شاقًا. النماذج العميقة نقلت جزءًا من هذا العبء إلى التمثيل المتعلم، من غير أن تجعل الخصائص اللغوية عديمة القيمة في كل مهمة.
الشبكات العصبية والتعلم العميق
الشبكة العصبية، في هذا السياق، تركيب من دوال رياضية ذات معاملات تتعلم من الأمثلة. لا حاجة إلى تشبيهها بالدماغ لفهم وظيفتها: طبقات تحول المتجهات، وتدريب يعدل الأوزان. الشبكات الالتفافية (CNNs) تبحث عن أنماط محلية، واستُخدمت في تصنيف الجمل لأن بعض المؤشرات الدلالية قصير المدى. الشبكات المتكررة (RNNs) تقرأ السلسلة خطوة فخطوة وتحمل حالة مخفية، فتناسب النص من حيث المبدأ.
مشكلة التلاشي في التدرج تجعل تعلم الاعتماد على كلمات بعيدة صعبًا في الشبكة المتكررة البسيطة. شبكات الذاكرة طويلة وقصيرة المدى (LSTM)، التي تعود إلى هوخرايتر وشميدهوبر عام 1997، أدخلت بوابات تنظم ما يُحفظ وما يُنسى. الوحدات المتكررة البوابية (GRU) تؤدي فكرة قريبة بعدد أقل من البوابات. هذه النماذج نقلت الترجمة والتلخيص نقلة واسعة، لكنها تعالج السلسلة تسلسلًا، فتصعب موازاة التدريب، ويطول مسار المعلومة بين أول الجملة وآخرها.
المكسب المشترك للتعلم العميق أن الخصائص لم تعد كلها مصممة باليد. النموذج يكوّن تمثيلات وسطى مفيدة، ويصير أصعب تفسيرًا في المقابل.
آلية الانتباه
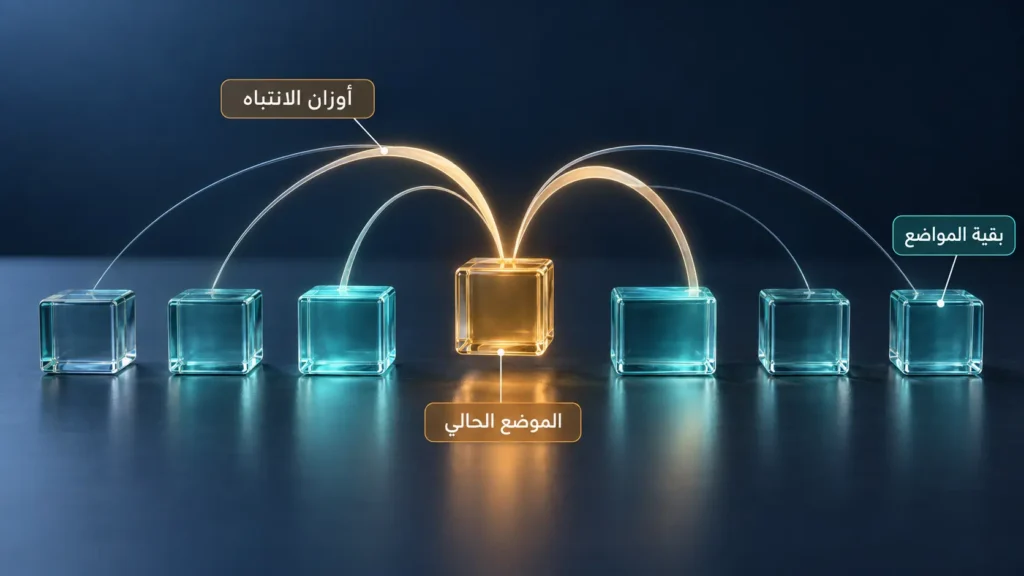
حين تترجم جملة طويلة، ليست كل كلمات المصدر مهمة بالدرجة نفسها في لحظة إنتاج الكلمة الحالية. آلية الانتباه، كما استُعملت في الترجمة العصبية مع بهاداناو وتشو وبنجيو عام 2014، تتيح للنموذج أن يوزع وزنًا على مواضع الجملة المصدر وهو يولّد كل كلمة. الوزن يتغير مع السياق: التركيز عند إنتاج اسم المدينة غير التركيز عند إنتاج فعل التأخير.
الانتباه الذاتي (Self-Attention) يطبّق الفكرة داخل السلسلة الواحدة. كل موضع ينظر إلى المواضع الأخرى في المدخل نفسه، فيُعاد بناؤه كخليط موزون منها. الفرق عن الانتباه التقليدي في الترجمة أن العلاقة لم تعد بين جملتين، مصدر وترجمة، بل داخل التمثيل الواحد. بهذا يمكن لعلامة بعيدة، كضمير أو أداة نفي، أن تؤثر في تمثيل كلمة من غير أن تنتقل عبر عشرات الخطوات المتكررة. هذه الآلية هي قلب المحولات.
بنية المحولات
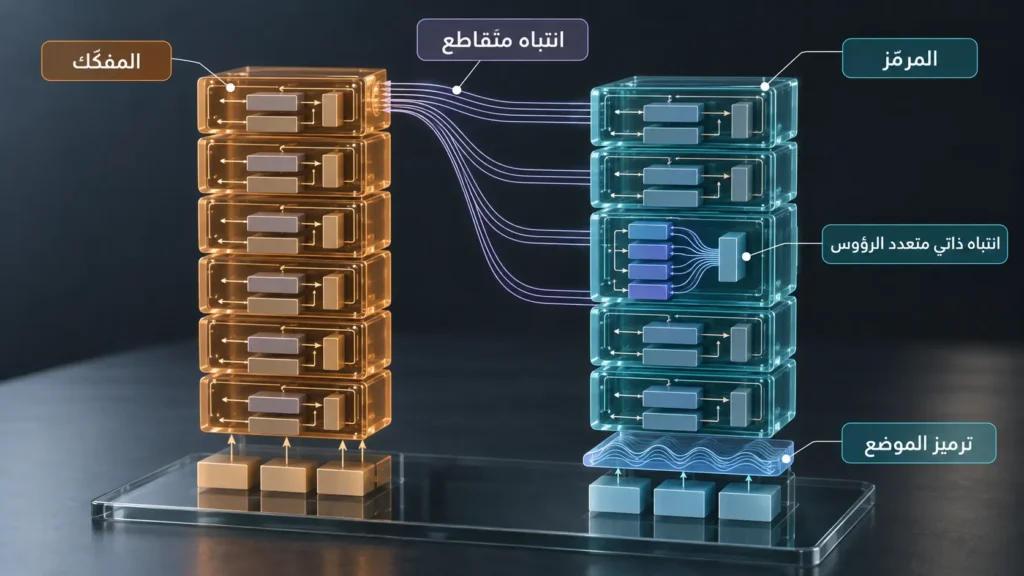
المحولات (Transformers) بنية قدمها واسواني وزملاؤه عام 2017 في ورقة Attention Is All You Need، المنشورة في مؤتمر NeurIPS. الورقة ليست بداية تاريخ معالجة اللغة، بل نقطة استبدال عملية: الاستغناء عن التكرار والالتفاف في نموذج تحويل السلاسل، والاكتفاء بالانتباه. نموذجهم الأساسي مكوّن من مرمّز ومفكّك، كل منهما بست طبقات، مع انتباه ذاتي متعدد الرؤوس.
الفكرة الحسابية للانتباه بضرب نقطي مُقاس يمكن كتابتها كما صاغها أصحاب الورقة:
Attention(Q, K, V) = softmax(QKT / √dk) V
هنا Q استعلام الموضع الحالي، وK مفاتيح المواضع المتاحة، وV قيمها، وdₖ بعد المتجه. القسمة على الجذر تمنع قيم الضرب من التضخم قبل دالة softmax. الانتباه متعدد الرؤوس (Multi-Head Attention) يكرر هذا الحساب عدة مرات في فضاءات جزئية، ثم يدمج النتائج. التحليلات اللاحقة لرؤوس الانتباه، ومنها دراسة كلارك وزملائه عام 2019 على BERT، أظهرت أن بعض الرؤوس يميل إلى تتبع علاقات تركيبية أو إحالية. هذا ميل إحصائي، لا دليل على أن كل رأس «متخصص» تخصصًا لغويًا نظيفًا.
الانتباه وحده لا يعرف ترتيب الكلمات، لأن خليطًا موزونًا من المواضع لا يميز تقديم كلمة على أخرى. لذلك تُضاف معلومات موضع (Positional Encoding). الورقة الأصلية استخدمت ترميزًا جيبيًا ثابتًا، واستخدمت نماذج لاحقة مواضع متعلمة أو ترميزًا دورانيًا.
للمعمار ثلاثة استعمالات شائعة. المرمّز (Encoder) يبني تمثيلًا ثنائي الاتجاه للجملة، وهو مناسب للتصنيف ووسم الكيانات، كما في BERT. المفكّك (Decoder) يولّد الرمز التالي من السابق فقط، وهو مناسب لنماذج اللغة التوليدية كما في سلسة GPT. المرمّز والمفكّك معًا (Encoder–Decoder) يناسبان التحويل من تسلسل إلى تسلسل، كترجمة الجملة أو تلخيصها، وهو شكل النموذج الأصلي وشكل نماذج مثل T5. في هذا الشكل ينظر المفكك إلى ما ولّده سابقًا عبر انتباه ذاتي، وينظر إلى تمثيل المصدر عبر انتباه متقاطع.
ميزة التدريب أن حساب الانتباه على مواضع السلسلة يمكن موازاته، بخلاف الخطوة المتكررة التي تنتظر الحالة السابقة. أما التوليد كلمة بكلمة فيبقى تسلسليًا وقت الاستدلال. على الترجمة، بلغ نموذج الورقة 28.4 على مقياس BLEU في الاتجاه من الإنجليزية إلى الألمانية ضمن مهمة WMT 2014، و41.8 في الاتجاه من الإنجليزية إلى الفرنسية، بعد تدريب استغرق 3.5 يوم على ثماني وحدات معالجة رسومية للنموذج الفرنسي. هذه أرقام مهمة تاريخية على اختبارات تلك السنة، لا معيارًا خالدًا لجودة الترجمة.
رقم يستحق الانتباه: بنية المحولات، كما قُدمت عام 2017، لم تبدأ من الصفر. الانتباه كان مستخدمًا في الترجمة العصبية منذ 2014. الجديد كان جعل الانتباه البنية كلها، بحيث صار تدريب السلاسل أشد موازاة وأقل اعتمادًا على الحالة المتكررة.
اقرأ أيضاً:
- شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
- الجبر الخطي المتقدم: المفهوم، الفروع، والتطبيقات
- الصفر: كيف حوّل العرب “اللاشيء” إلى أعظم اختراع غيّر مسار البشرية؟
كيف تطورت معالجة اللغات الطبيعية حتى ظهور النماذج اللغوية الكبيرة؟
البدايات: الاعتماد على القواعد والترجمة الآلية
التجربة التي أطلقت شهرة الترجمة الآلية المبكرة كانت عرض جورج تاون–IBM عام 1954: جمل روسية محدودة تُرجمت إلى الإنجليزية بقواعد ومعجم صغير، فصُورت في الصحافة كأن الحاجز اللغوي أوشك على السقوط. الواقع الهندسي كان أضيق من الصورة العامة. تقرير ALPAC عام 1966 خلص إلى أن الترجمة الآلية التشغيلية، في ذلك الوقت، أبطأ وأغلى وأقل دقة من الترجمة البشرية، فأُعيد توجيه التمويل في الولايات المتحدة نحو البحث الأساسي لا نحو نشر أنظمة كاملة.
في تلك المرحلة كانت القواميس والقواعد النحوية مسارًا مفهومًا: اللغة تُوصف، ثم تُبرمج. ظهرت أيضًا برامج حوار بالنمط، وأشهرها ELIZA التي صممها فاينباوم في الستينيات، وكانت تعيد صياغة كلام المستخدم بقواعد سطحية. كثير من الناس نسبوا إليها فهمًا لم يكن فيها. هذا الدرس قديم قدم المجال: الاستجابة اللغوية المقنعة تُغري بنسبة الفهم إلى الآلة.
التحول إلى الأساليب الإحصائية
من الثمانينيات فصاعدًا، صار تقدير الاحتمالات من المدونات منافسًا جديًا للقواعد اليدوية، ثم متفوقًا عليها في الترجمة والتعرف على الكلام ووسم أقسام الكلام. بدل كتابة كل حالة، يُحصى ما فعله المترجمون وما فعله الكتاب. تحسنت الأنظمة حيث توفرت نصوص متوازية ضخمة، وظهرت حدود جديدة: اللغات والنطاقات الفقيرة بالبيانات، والجمل التي يفوق طولها ذاكرة N-gram، والمعنى الذي لا يُلتقط بعدّ التجاور.
الانتقال لم يكن استبدالًا فلسفيًا تامًا. المعرفة اللغوية بقيت في تصميم المدونة، ووحدة الكلمة، وقرار ما يُحسب خطأً في التقييم.
ظهور التعلم العميق والتمثيلات المتجهية
في العقد الثاني من هذا القرن انتقلت الترجمة والتصنيف إلى الشبكات العصبية، وصارت المتجهات الموزعة بديلًا عمليًا عن المتجهات الشديدة التبعثر. Word2Vec وGloVe جعلا تشابه الكلمات عملية حسابية رخيصة. ثم أظهرت LSTM أن بعض الاعتماد البعيد قابل للتعلم. بقي القيد البنيوي: التمثيل الثابت لا يفصل معاني الكلمة، والمعالجة المتكررة لا توازي بسهولة.
ELMo أضاف أن التمثيل ينبغي أن يتغير مع الجملة. كانت تلك إجابة مباشرة عن لبس من نوع «عين» و«بنك»، ومقدمة تجريبية لفكرة أعم: درّب نموذج لغة كبيرًا نسبيًا، ثم أعد استخدامه في مهام عدة.
عصر المحولات والنماذج اللغوية المدربة مسبقًا
بعد 2017 صارت المحولات البنية الافتراضية للأبحاث الجديدة. BERT، الذي قدمه ديفلين وزملاؤه عام 2018 ونُشر في NAACL عام 2019، مرمّز يُدرَّب على التنبؤ بكلمات محجوبة داخل الجملة، فيقرأ السياق من الجهتين. النسخة الأساسية نحو 110 ملايين معامل، والكبيرة نحو 340 مليونًا. GPT، التي طورها رادفورد وزملاؤه، مفكك يتنبأ بالرمز التالي من اليسار إلى اليمين، ومناسب للتوليد.
التدريب المسبق (Pretraining) يعني أن النموذج يتعلم أولًا من نص خام ضخم بهدوء إشرافي ذاتي، ثم يُعاد استخدامه. الضبط الدقيق (Fine-Tuning) يكمل التدريب على بيانات مهمة أصغر وموسومة. هذا الفصل وفر على الباحثين بناء شبكة جديدة من الصفر لكل باب: سؤال، كيانات، تصنيف، ترجمة.
ما الذي تغير بعد النماذج اللغوية الكبيرة؟
النماذج اللغوية الكبيرة دفعت الاتجاه نفسه إلى مقاييس بيانات ومعاملات أعلى، وخصوصًا النماذج التوليدية القادرة على أداء مهام متنوعة بصياغة الطلب لغةً عادية. GPT-3، في ورقة براون وزملائه عام 2020، بلغ 175 مليار معامل، وأظهر أن تكبير النموذج والبيانات يتيح أنماطًا من التعميم لم تكن عملية في النماذج الصغيرة.
الذي تغير في الاستخدام اليومي هو واجهة المهمة. بدل تدريب مصنّف لكل باب، صار ممكنًا أحيانًا صياغة تعليمات والحصول على مسودة أو تصنيف أو شرح. واتسعت النماذج متعددة اللغات، فدخلت لغات لم يكن لها نظام مخصص بالحجم نفسه. وفي الوقت نفسه ظهرت مشكلات تقييم وتحيز وموثوقية أشد ظهورًا، لأن النص المقنع يخفي الخطأ. هذه التحولات لا تلغي أدوات التصنيف الكلاسية، ولا محلّلات الصرف، ولا محركات البحث. تغيّر مركز الثقل، لا حدود الخريطة.
| المرحلة الزمنية | المرحلة العلمية | الحدث / الاكتشاف | الأدوات المستخدمة | التحديات | الأثر العلمي |
|---|---|---|---|---|---|
| 1954 | قواعد وقواميس | عرض جورج تاون–IBM: جمل روسية محدودة تُترجم إلى الإنجليزية | قواعد ومعجم صغير | الواقع الهندسي أضيق من صورته الصحفية | أطلق شهرة الترجمة الآلية المبكرة |
| الستينيات | قواعد وقواميس | برنامج الحوار ELIZA لفاينباوم | قواعد سطحية لإعادة صياغة كلام المستخدم | نسبة الناس إليه فهمًا لم يكن فيه | درس مبكر: الاستجابة المقنعة ليست فهمًا |
| 1966 | قواعد وقواميس | تقرير ALPAC عن الترجمة الآلية التشغيلية | قواميس وقواعد نحوية | أبطأ وأغلى وأقل دقة من الترجمة البشرية | إعادة توجيه التمويل الأمريكي نحو البحث الأساسي |
| من الثمانينيات | إحصاء ومدونات | تقدير الاحتمالات من المدونات ينافس القواعد اليدوية ثم يتفوق عليها | N-grams وHMM وCRF | اللغات الفقيرة بالبيانات وجمل أطول من ذاكرة N-gram | مدققات إملائية وترجمة إحصائية قوية |
| 2013 – 2014 | تعلم عميق | Word2Vec وGloVe، ودخول الانتباه إلى الترجمة العصبية | متجهات كثيفة وLSTM وGRU | تمثيل ثابت لا يفصل المعاني، ومعالجة متكررة صعبة الموازاة | صار تشابه الكلمات عملية حسابية رخيصة |
| 2017 | محولات | ورقة Attention Is All You Need | انتباه ذاتي متعدد الرؤوس وترميز الموضع | الانتباه وحده لا يعرف ترتيب الكلمات | تدريب أشد موازاة، وصارت البنية الافتراضية للأبحاث |
| 2018 | تدريب مسبق | ELMo ثم BERT: مرمّز يتنبأ بكلمات محجوبة | تمثيل سياقي وتدريب مسبق وضبط دقيق | لبس الكلمة الواحدة مثل «عين» و«بنك» | نموذج واحد يُعاد استخدامه في مهام عدة |
| 2020 | نماذج لغوية كبيرة | GPT-3 بنحو 175 مليار معامل | مفكك توليدي وتكبير البيانات والمعاملات | مشكلات تقييم وتحيز وموثوقية أشد ظهورًا | مهام متنوعة بصياغة الطلب لغةً عادية |
| 2022 | نماذج لغوية كبيرة | InstructGPT: ضبط النموذج على تفضيلات البشر | الضبط بالتعليمات وRLHF | تحسين السلوك لا يضمن صدق المحتوى | نماذج تتبع التعليمات بدل الاكتفاء بالتكملة |
ما النماذج اللغوية الكبيرة وما علاقتها بمعالجة اللغات الطبيعية؟
ما المقصود بالنماذج اللغوية الكبيرة؟
النموذج اللغوي، في أصله، توزيع احتمالات على سلسلة من الرموز: ما أرجح الكلمة التالية؟ النموذج اللغوي الكبير (Large Language Model – LLM) نموذج من هذا النسب، مبني غالبًا على محولات، ودُرب على نص واسع، وبلغ من عدد المعاملات والبيانات والحوسبة حدًا جعله قادرًا على مهام لغوية متنوعة. «كبير» وصف نسبي تاريخي، لا عتبة رسمية واحدة. BERT كبير مقارنة بنماذج 2013، وصغير مقارنة بـGPT-3، والنماذج اللاحقة سلكت الاتجاهين: تكبير إضافي، وتصغير مدروس لنماذج متخصصة.
القدرة الظاهرة تنتج من تقاطع حجم البيانات، وعدد المعاملات، وحساب التدريب، وجودة التصميم، لا من عدد المعاملات منعزلًا. والنماذج الكبيرة جزء من معالجة اللغات الطبيعية لأنها تستخدم تمثيل اللغة والتنبؤ بها. ليست المجال كله: تحليل صرف عربي قابل للتفسير، أو محرك بحث يسترجع وثيقة بعيْنها، أو مصنّف مدرَّب على عشرة آلاف شكوى موسومة، كلها معالجة لغة حتى لو لم يكن في قلبها نموذج بمليارات المعاملات.
كيف تتعلم النماذج اللغوية الكبيرة؟
في التدريب المسبق التوليدي، تُعرض على النموذج نصوص طويلة ويُطلب منه توقع الرمز التالي. لا أحد يكتب وسمًا لكل جملة؛ النص نفسه مصدر الإشراف. هذا تعلم ذاتي الإشراف (Self-Supervised Learning). نماذج التمثيل مثل BERT تتعلم بتنبؤ الرموز المحجوبة من سياقها، وهو هدف مختلف ينتج تمثيلًا قويًا للفهم الهندسي لا مولّدًا حرًا بالضرورة.
المعاملات (Parameters) هي الأوزان التي تُحدَّث أثناء التدريب. بعد التدريب المسبق، الضبط الدقيق يواصل التحديث على مهمة أضيق. الفرق عملي: التدريب المسبق يكلّف كثيرًا ويُبنى مرة، والضبط يعيد استخدام تلك المعرفة. النموذج لا «يصل» إلى معلومة لم تدخل تدريبه أو أدواته إلا بقدر ما يستطيع تعميم نمط، وهذا التعميم قد يصيب وقد يختلق.
كيف تصبح النماذج قادرة على اتباع التعليمات؟
التنبؤ بالرمز التالي ينتج تكملة تشبه الإنترنت الذي دُرب عليه النموذج، لا مساعدًا يجيب عن طلب. الضبط بالتعليمات (Instruction Tuning) يدرب النموذج على أزواج من التعليمات والإجابات المرغوبة. التعلم المعزز من التغذية الراجعة البشرية (Reinforcement Learning from Human Feedback – RLHF)، كما استُخدم في InstructGPT الذي وصفه أويانغ وزملاؤه عام 2022، يذهب خطوة أخرى: الناس يرتبون إجابات، ويُدرَّب نموذج تفضيل، ثم تُعدَّل سياسة التوليد نحو ما فَضّله الناس.
هذا تحسين لسلوك النموذج أمام التعليمات، لا ضمان لصدق المحتوى، ولا تحويل للتفضيل البشري إلى فهم. يمكن لنموذج أن يتبع صيغة الطلب باتقان، وأن يخطئ في الواقع، وأن يظل متحيزًا إذا كان التفضيل أو البيانات كذلك.
كيف تنتج النماذج اللغوية النصوص؟
التوليد التتابعي يبني النص رمزًا فرمزًا. في كل خطوة ينتج النموذج توزيع احتمالات على معجمه، ثم تُختار نقطة من هذا التوزيع. الاختيار الجشع يأخذ الأعلى دائمًا، فيكون مستقرًا ومملًا وقابلًا للتكرار. البحث الشعاعي (Beam Search) يبقي عدة فرضيات متوازية، وهو شائع حين يكون المطلوب أقرب إلى أفضل تسلسل، كما في بعض أنظمة الترجمة. Top-k يحصر القرعة في أعلى عدد ثابت من الرموز. Top-p، أو العينة النواتية التي درسها هولتزمان وزملاؤه، يحصرها في أصغر مجموعة يبلغ مجموع احتمالاتها عتبة معينة. رفع عشوائية الاختيار يزيد التنوع وقد يزيد الخلل. هذه إعدادات استدلال، لا معرفة جديدة يحصل عليها النموذج بعد التدريب.
الفرق بين النماذج اللغوية الكبيرة ومحركات البحث
محرك البحث يسترجع وثائق موجودة ويرتبها. النموذج اللغوي يولّد تتمة محتملة لغويًا. الأول قد يخطئ في الترتيب، لكنه يستطيع إظهار المصدر. الثاني قد ينتج جملة لا توجد في أي مصدر، لأن هدفه الاحتمال لا الاستشهاد. لذلك تظهر معلومات خاطئة بصياغة واثقة: النموذج لم يصمم أصلًا ليراجع قاعدة حقائق عند كل رمز.
| وجه المقارنة | المفهوم الأول: محرك البحث | المفهوم الثاني: النموذج اللغوي الكبير |
|---|---|---|
| الوظيفة الأساسية | يسترجع وثائق موجودة ويرتبها | يولّد تتمة محتملة لغويًا |
| الهدف الذي يُحسَّن | ملاءمة الوثيقة للاستعلام وجودة ترتيبها | احتمال الرمز التالي في السلسلة |
| طبيعة الناتج | وثائق ومقاطع موجودة فعلًا | نص جديد قد لا يوجد في أي مصدر |
| إظهار المصدر | يستطيع إظهار المصدر | لا يستشهد بالضرورة؛ هدفه الاحتمال لا الاستشهاد |
| مصدر المعرفة | وثائق يمكن تحديثها | ما استقر في الأوزان أثناء التدريب |
| الخطأ المعتاد | خطأ في الترتيب أو وثيقة غير مناسبة | جملة سليمة ومعلومة خاطئة بصياغة واثقة |
| الاستخدام الأنسب | العثور على مصدر قابل للمراجعة | صياغة مسودة أو شرح أو تلخيص |
| الجمع بينهما (RAG) | يوفّر المقاطع المسترجعة | يصوغ الجواب مشروطًا بتلك المقاطع |
الجمع بينهما ممكن، وهو مختلف عن الادعاء أن النموذج «أصبح محرك بحث».
ما التوليد المعزز بالاسترجاع؟
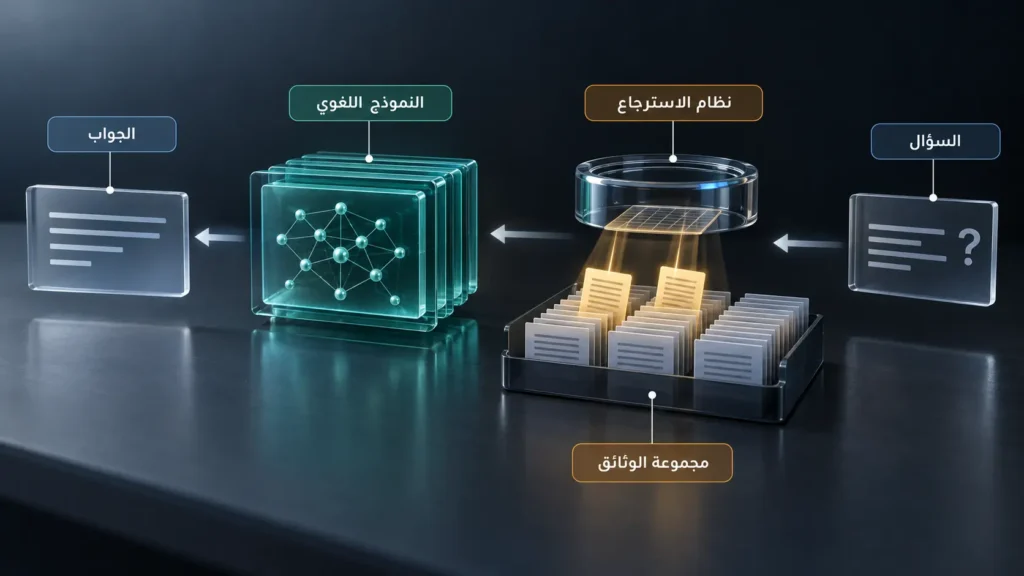
التوليد المعزز بالاسترجاع (Retrieval-Augmented Generation – RAG)، كما صاغه لويس وزملاؤه عام 2020، يفصل بين ما يمكن استرجاعه وما يُصاغ. عند السؤال، يبحث نظام استرجاع في مجموعة وثائق، ويعيد مقاطع قريبة، ثم يمرر هذه المقاطع مع السؤال إلى النموذج اللغوي ليصوغ الجواب مشروطًا بها. المعرفة هنا لم تعد محصورة فيما استقر داخل الأوزان أثناء التدريب. يمكن تحديث الوثائق من غير إعادة تدريب النموذج كله.
الحد واضح. الاسترجاع قد يجلب مقطعًا غير مناسب. النموذج قد يتجاهل المقطع ويستند إلى عادته اللغوية. المصدر الخارجي نفسه قد يكون خاطئًا أو قديمًا. RAG يقلل بعض الأخطاء ولا يلغي الحاجة إلى التحقق، وخصوصًا حين يكون الجواب قرارًا لا صياغة.
اقرأ أيضاً:
- الدليل الشامل إلى النماذج مفتوحة المصدر (Open Source Models): كيف تقود ثورة الذكاء الاصطناعي؟
- البيانات الضخمة (Big Data): كيف تحرك الأرقام العالم وتصنع مستقبل التكنولوجيا؟
ما تحديات معالجة اللغات الطبيعية في اللغة العربية؟
العربية تضع المبادئ السابقة تحت ضغط ظاهر. ليست «لغة صعبة» على سبيل الوصف الإنشائي، بل لغة تجتمع فيها ظواهر لها أثر هندسي مباشر: الاشتقاق، واللواصق المتصلة، والكتابة غير المشكولة، وازدواجية الفصحى والعامية، وتعدد الإملاء. دروس معالجة العربية ولهجاتها عُرضت مبكرًا في أعمال من نوع الكتاب المرجعي لنزار حبش عام 2010، والدروس التعليمية التي قدمتها منى دياب ونزار حبش في EMNLP عام 2014.
البنية الصرفية للكلمات العربية
تقوم كثير من الكلمات على جذر من صوامت قليلة يُصب في وزن. من الجذر كتب تُشتق أشكال تدل على الكتابة والكتاب والكاتب والمكتوب والمكاتبة، قبل أن تدخل علامات التصريف. ثم تأتي السوابق واللواحق: حرف عطف، وحرف جر، وتعريف، وضمير متصل، وعلامات جمع وتأنيث. الناتج أن المعنى النحوي الذي يوزعه الإنجليزية أحيانًا على كلمات منفصلة يتجمع في كلمة عربية واحدة.
الفرق بين التحليل الصرفي والتحليل النحوي أن الأول يفكك الكلمة، والثاني يربط الكلمات في جملة. لكن الحد بينهما يضيق حين تكون اللواصق هي التي تحمل وظيفة الفاعل والمفعول وأداة الربط. السؤال «ما الوحدة اللغوية؟» ليس سؤال تقطيع نصوص عامًا فحسب، بل سؤالًا صرفيًا: هل «وسيكتبونها» كلمة، أم سلسلة وحدات لكل منها وسم؟
اتساع الفضاء النظري كبير. في دراسة حبش ورامبو عام 2005 على المحلل الصرفي وبيانات المدونة الشجرية العربية، ذُكر أن عدد التحليلات الصرفية المحددة نظريًا يقارب 333 ألف تحليل، لا يُستخدم منها في أول 280 ألف كلمة من تلك المدونة سوى نحو 2200 وسم. القسمة هنا، وهي حساب هذه المقالة على الرقمين التقريبيين المنشورين، تضع المستعمَل عند قرابة 0.7% من الفضاء النظري في تلك الشريحة الإخبارية الفصيحة. هذا لا يصف العربية كلها، ويُظهر مع ذلك أن الندرة والتشتت مشكلتان معًا: الإمكانات هائلة، والمُشاهد في مدونة بعينها أضيق بكثير، وكل شكل نادر أصعب في التعلم.
تحديات تقسيم الكلمات واللواصق
الكلمة الإملائية العربية قد تضم حرف عطف وحرف جر وتعريفًا وجذعًا وضميرًا من غير علامة فاصلة. «والعلبة» في جملة الشحنة تبدأ بواو الربط ثم تعريف. إن عوملت كتلة واحدة، تكاثرت أشكال المعجم: والعلبة، بالعلبة، للعلبة، علبتهم. وإن فُصلت اللواصق، قلّ عدد الجذوع المختلفة وطالت السلسلة التي يراها النموذج.
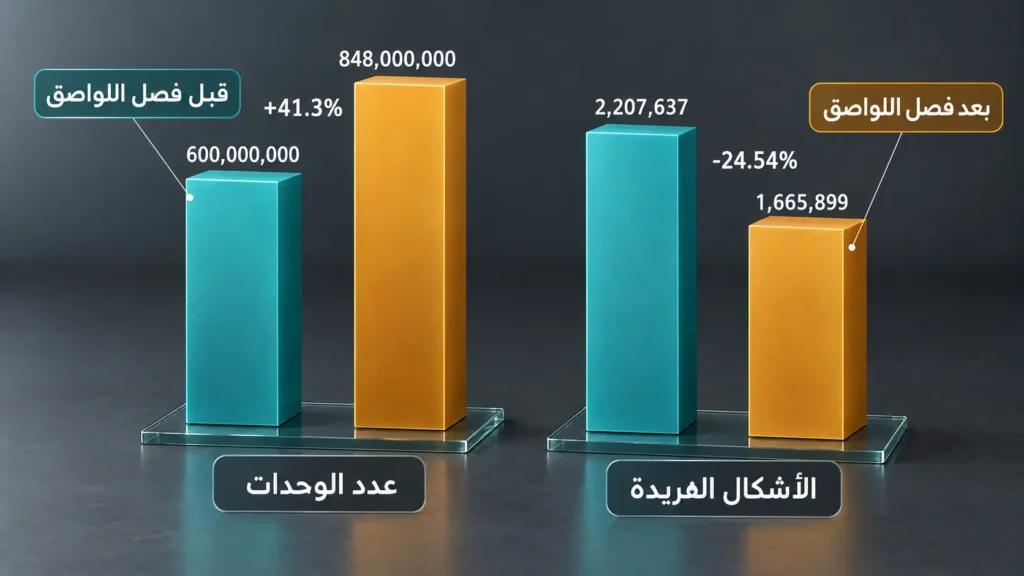
هذا الأثر مقيس، لا افتراضي. في دراسة العطيبي وفودة والخرشي المنشورة في PACLIC عام 2010، عُولجت مدونة عربية من 600 مليون كلمة بأداة AMIRA 2.0 لفصل اللواصق. كان عدد الأشكال الفريدة 2,207,637 قبل الفصل، فصار 1,665,899 بعده. وأصبح عدد الوحدات 848 مليونًا. الحساب المشتق في هذه المقالة من هذه الأرقام يعطي الصورة التالية.
| المؤشر | الرقم المنشور | ما يشتقه هذا المقال |
|---|---|---|
| حجم المدونة الأصلية | 600 مليون كلمة | خط الأساس |
| عدد الوحدات بعد فصل اللواصق | 848 مليونًا | زيادة 248 مليون وحدة، أي 41.3% |
| اللواصق المفصولة لكل 100 كلمة | غير معروض بهذا الشكل في المصدر | نحو 41 لاصقة، إن عُدّت الزيادة كلها لواصق مفصولة |
| أشكال فريدة قبل الفصل | 2,207,637 | — |
| أشكال فريدة بعد الفصل | 1,665,899 | نقص 541,738 شكلًا، أي 24.54% كما ذكرت الدراسة |
| حصة «ال» من اللواصق المرصودة | 57.02% | مع «و» (17.17%) و«ل» (6.35%) تبلغ 80.54% |
غياب التشكيل وتعدد المعاني
تُكتب معظم العربية المعاصرة من غير حركات. الشكل «علم» يحتمل، بين قراءات عدة، عِلْمًا وعَلَمًا وعَلِمَ وعَلَّمَ. والشكل «كتب» يحتمل الفعل المعلوم والمبني للمجهول والاسم «كُتُب». السياق يزيل كثيرًا من هذا اللبس ولا يزيله كله، خصوصًا في العناوين والنصوص القصيرة.
الأدبيات التي تستند إلى حبش (2010) تذكر أن الكلمة غير المشكولة قد تبلغ في المتوسط نحو 12 تحليلًا صرفيًا خارج السياق، وتذكر دراسة Exploiting Arabic Diacritization for High Quality Automatic Annotation المنشورة عام 2016 رقم 12.8 تحليلًا في بيانات تدريبها، محيلةً التقدير خارج السياق إلى شهير وزملائه (2015). الرقم إذن خاصية للمحلل والمدونة وغياب السياق، لا ثابتًا سحريًا للغة. وفي الدراسة نفسها التي أجراها حبش ورامبو على المدونة الشجرية، ينزل متوسط التحليلات المتنافسة للشكل الكتابي إلى نحو اثنين داخل ذلك الإعداد. المقارنة بين الرقمين ليست تجربة موحدة المنهج، وهي كافية لإظهار فكرتين: السياق يضيّق الاحتمال تضييقًا كبيرًا، واللبس لا ينعدم بعد التضييق.
رقم يستحق الانتباه: في نصوص الأخبار، لا تحمل سوى نحو 1.6% من الكلمات أي حركة تشكيل يضعها الكاتب، بحسب ما يوثقه حبش (2010) وتستعيده دراسات لاحقة. إذا طُبّق هذا المعدل على مقالة افتراضية طولها 500 كلمة، فالمتوقع نحو 8 كلمات مشكولة فقط. التشكيل الآلي (Arabic Diacritization) محاولة لاستعادة هذا المحذوف، وهو ضروري أحيانًا للنطق الآلي وللتعليم، لا خطوة تجميل.
اقرأ أيضاً: حاسبة النسبة المئوية الدقيقة: مع دليل القوانين الرياضية وطرق الحساب الذهني
الاختلافات الإملائية وتطبيع النص العربي
تختلف كتابة الهمزة والألف الممدودة، وتتبادل الألف المقصورة والياء في بعض الاستعمالات، وتتقارب التاء المربوطة والهاء في الخطأ الشائع. يضاف إلى ذلك اختلاف الأرقام العربية والأوروبية، وعلامات الترقيم، ومشكلات الترميز، واتجاه الكتابة من اليمين إلى اليسار حين يختلط النص بكلمات لاتينية أو أرقام. التطويل وعلامات الاتجاه غير المرئية تغيّر السلسلة الحاسوبية من غير أن يراها القارئ.
التوحيد الإملائي يرفع الاسترجاع في البحث لأنه يجمع أشكال الكلمة الواحدة، وقد يضر مهمة تحتاج الفرق: اسم علم، أو آية مشكلة، أو وزن صرفي تقوم فيه الهمزة بدور. حذف التشكيل من نص نادرًا ما يحتويه يكاد يكون محايدًا في الأخبار، وهو ضار إن كانت المهمة تعليم التجويد أو ضبط الإعراب. التطبيع قرار يخص المهمة، لا قاعدة نظافة عامة.
الفصحى واللهجات والازدواجية اللغوية
ازدواجية العربية، بالمعنى الذي استقر في اللسانيات منذ فيرغسون، تعني تعايش نمط كتابي معياري رسمي مع لهجات منطوقة تختلف عنه في المعجم والصرف والنحو والنطق. الفصحى المعاصرة (Modern Standard Arabic) لغة الإعلام والكتابة الرسمية في نطاق واسع. اللهجات تتباعد فيما بينها: أداة النفي، وتصريف المضارع، وكلمة «الآن» أو «كثير»، ليست واحدة في الخليج والمغرب. لا توجد لهجة عربية واحدة تُسمى «العامية» ويُكتفى بتدريب نظام عليها.
مشروع MADAR، الذي بنته هدى بوعمور ونزار حبش وزملاؤهما ونُشر عام 2018، يعطي مثالًا عربيًا موثقًا على حجم المسألة وعلى حد البيانات في الوقت نفسه. المدونة جمل سفر مترجمة من مدونة BTEC إلى لهجات 25 مدينة، من الرباط وفاس والجزائر وتونس وطرابلس والقاهرة والخرطوم وعمّان والقدس وبيروت ودمشق وحلب وبغداد والموصل والدوحة ومسقط وصنعاء وغيرها، إلى جانب الفصحى والإنجليزية والفرنسية. الجزء المسمى Corpus-26 يضم 2000 جملة لكل مدينة. حاصل الضرب الذي تجريه هذه المقالة: 50 ألف ترجمة لهجية متوازية في هذا الجزء وحده، قبل احتساب جانب الفصحى. القيمة أن المقارنة بين المدن منضبطة لأن المعنى المصدر واحد. والقيد أن الجمل مجال سفر مترجم، لا حديثًا عفويًا، وأن مدينتين داخل البلد نفسه ليستا «لهجة واحدة» ولا لغتين معزولتين بالضرورة.
الصورة في التقييم العلني أقرب إلى الصعوبة العملية. في المهمة المشتركة NADI 2024، وهي الخامسة في سلسلة التعرف الدقيق على اللهجات، بلغ أفضل نظام في الترجمة من اللهجة إلى الفصحى 20.44 على مقياس BLEU، وبلغت أفضل نتيجة في التعرف متعدد التسميات على مستوى البلد 50.57 على مقياس F1 مقابل دقة 67.50. لوحة النتائج توزع BLEU الفائز، بعد نقل أرقامها من صورتها المئوية الكسرية إلى المقياس المعتاد، بين 16.57 للمصرية و23.38 للإماراتية في تلك المهمة تحديدًا، بفارق 6.81 نقطة داخل النظام الفائز نفسه. لا يجوز قراءة هذا الفارق على أن لهجة «أسهل» بصورة مطلقة، فأحجام العينات ونوع النص جزء من النتيجة. يجوز قراءة شيء أضيق: حتى في مهمة مضبوطة عام 2024، لم تكن «اللهجة العربية» حالة اختبار واحدة، والتفوق على مقياس صعب ما زال بعيدًا عن أرقام الترجمة بين لغات وفيرة الموارد في اختباراتها التاريخية.
الكتابة بالحروف اللاتينية والمزج بين اللغات
عربيزي (Arabizi) كتابة الدارجة بحروف لاتينية وأرقام تقوم مقام أصوات لا يقابلها حرف لاتيني واحد، مثل 7 للحاء و3 للعين في اصطلاحات شائعة. ليست نظامًا إملائيًا موحدًا، بل عادة كتابية تختلف بين المستخدمين. التبديل اللغوي (Code-Switching) الانتقال داخل الخطاب بين الفصحى ولهجة، أو بين العربية ولغة أخرى. مراجعة إنجي حامد وزملائها في COLING 2025، وقد عُقد المؤتمر في أبوظبي، تصف المشهد بازدواجية داخل العربية وتعدد لغوي مع الإنجليزية والفرنسية وغيرهما، وتشير إلى تركز البحث في أزواج محدودة، منها الفصحى مع المصرية، أكثر مما يمثل استعمال الناس كله.
جملة دعم فني قد تجمع «الشحنة delayed والعلبة مكسورة» أو تكتب الطلب كله بحروف لاتينية. إن دُرب النظام على فصحى مشكلة جزئيًا من وكالات الأنباء، فهذه المدخلات خارج توزيعه. تحديد لغة كل كلمة، وتطبيع العربيزي إلى العربية، ثم تحليلها، ثلاث مشكلات تتقدم التصنيف أو الترجمة. البيانات الموسومة لهذه الأنماط أقل وأصعب اتفاقًا بين المعلقين، لأن الإملاء نفسه غير مستقر. معيار الكتابة التقليدية للهجة (CODA)، الذي اقترحه حبش ودياب ورامبو عام 2012 بدءًا بالمصرية، محاولة لصنع إملاء حاسوبي متسق للبحث، لا قرارًا بأن يتبنى المتكلمون إملاءً أكاديميًا في حياتهم.
تحديات البيانات والأدوات المخصصة للعربية
الأدوات والبيانات العربية حقيقية ومتقدمة، وتوزيعها غير متوازن. محللات صرفية مثل سلسلة MADA ثم MADAMIRA، وأداة فرسة التي طُورت في معهد قطر لبحوث الحوسبة، وحزمة CAMeL Tools التي قدمها أسامة عبيد وزملاؤه عام 2020 من مختبر CAMeL في جامعة نيويورك أبوظبي، تتيح تطبيعًا وتحليلًا صرفيًا والتعرف على اللهجات والكيانات. AraBERT، الذي دربه وسام أنطون وفادي بلي وحازم الحاج في الجامعة الأميركية في بيروت وقدموه عام 2020، نقل فكرة BERT إلى العربية.
ورقة AraBERT تقارن نموذجًا بحجم BERT الأساسي، نحو 110 ملايين معامل، بنموذج BERT متعدد اللغات على مهام عربية. إحدى النسختين، v1، دُربت على نص قُطعت لواصقه بأداة فرسة قبل بناء معجم SentencePiece، تحديدًا لأن أداة التعريف والزيادات تكرر الجذع في المعجم. الأرقام الآتية من الورقة، والفروق من حساب هذه المقالة:
| المجموعة والمقياس | AraBERT v1 | النموذج متعدد اللغات | الفرق |
|---|---|---|---|
| HARD، دقة، تقييمات فنادق كبيرة | 96.1 | 95.7 | +0.4 |
| ASTD، دقة، تغريدات مشاعر متوازنة | 92.6 | 80.1 | +12.5 |
| ArSenTD-Lev، دقة، تغريدات شامية | 59.4 | 51.0 | +8.4 |
| AJGT، دقة، تغريدات أردنية | 93.8 | 83.6 | +10.2 |
| LABR، دقة، مراجعات كتب | 86.7 | 83.0 | +3.7 |
| ANERcorp، F1 للكيانات | 81.9 | 78.4 | +3.5 |
| ARCD، F1 للإجابة | 62.7 | 61.3 | +1.4 |
حين يساعد تقطيع الكلمة العربية مهمةً ويضر بأخرى
يُعرض تطبيع العربية وفصل لواصقها أحيانًا كتهيئة محايدة تسبق الفهم. أرقام المدونة ونتائج AraBERT ترسم مقايضة أدق: فصل اللواصق يضغط المعجم ويطيل السلسلة معًا، والتقطيع الصرفي المسبق الذي يلامس نتيجة تصنيف قد يخفض نتيجة التعرف على الكيانات. النموذج لا يتسلم اللغة مجردة من القرار الهندسي. يتسلم ما بقي بعد إبقاء دليل وحذف دليل. أداة التطبيع لا تُحكم بجودتها العامة، بل بأثرها المقيس في المهمة التي ستُستخدم لها، وعلى بيانات تشبه استعمالها الفعلي لا على الأخبار وحدها.
ما أبرز تطبيقات معالجة اللغات الطبيعية؟
الترجمة الآلية وتعدد اللغات
الترجمة العصبية المعاصرة، والقائمة غالبًا على محولات بمرمّز ومفكّك أو على نماذج توليد كبيرة، هي التي تشغل خدمات الترجمة الواسعة الانتشار. تتقدم حين تتوفر نصوص متوازية وحين يكون المجال مألوفًا، وتضعف في المصطلح المتخصص، والتعبير الاصطلاحي، والإحالة الثقافية، والجملة التي يعتمد معناها على فقرة سابقة. الترجمة بين الفصحى والإنجليزية غير الترجمة بين لهجة منطوقة وفصحى، كما تلمح فجوة BLEU في مهمة NADI. مراجعة بشرية تظل جزءًا من الترجمة عالية المسؤولية، لا انعدام ثقة بالتقنية على الإطلاق.
محركات البحث والبحث الدلالي
تحليل الاستعلام يقرر ما إذا كانت الكلمات اسمًا، أو سؤالًا، أو تسلسلًا يجب مطابقته حرفيًا. المطابقة الدلالية تساعد حين يتنوع التعبير، والمطابقة الحرفية تبقى ضرورية في أرقام المواد القانونية وأسماء الأعلام والأخطاء التي لا يجوز «تصحيحها» تلقائيًا. في العربية يدخل التطبيع وفصل اللواصق داخل جودة البحث دخولًا مباشرًا: من يبحث عن «جامعة» يتوقع وثائق «بالجامعة» و«والجامعة». إن كان هذا الربط خاطئًا ضاع الاسترجاع وإن كان النموذج الدلالي حديثًا.
المساعدات الذكية وروبوتات المحادثة
المساعد يتعرف على القصد، ويملأ خانات مثل المدينة أو رقم الطلب، ويتابع سياق الحوار، ثم يجيب بقالب أو باستدعاء نظام خارجي أو بتوليد حر. الأنظمة القواعدية منضبطة ويمكن اختبار مساراتها، وتفشل خارج العبارات المتوقعة. النماذج التوليدية أوسع استيعابًا للصياغة، وأصعب ضبطًا إن كان الجواب يجب أن يطابق سياسة شركة أو قاعدة بيانات أسعار. النظام الهجين، الذي يترك التوليد للصياغة ويستند في الحقائق إلى أدوات وقواعد، أقرب إلى الاستخدام المسؤول من مولّد حر يتحدث عن الشحنة من غير سجل.
تحليل الآراء والمحتوى المنشور
تحليل تعليقات المنتجات والأخبار يتتبع الرضا ويستخرج الموضوعات المتكررة ويكشف الإساءة أو الرسائل المزعجة. السخرية، والأمثال، والخلط اللغوي، تجعل القرار الهش أشد هشاشة في المحتوى العربي الشبكي. مجموعة ArSenTD-Lev في جدول AraBERT، ودقتها قرب 59% حتى مع نموذج عربي مخصص في تلك التجربة، تذكير بأن «تحليل مشاعر العربية» ليس رقمًا واحدًا يُنقل من تقييمات الفنادق الفصيحة إلى التغريدات الشامية.
تلخيص المستندات واستخراج المعلومات
تلخيص تقرير طويل، أو استخراج أطراف عقد وتواريخه ومبالغه، يحوّل نصًا غير منظم إلى شيء يمكن البحث فيه ومراجعته. التعرف على الكيانات وربطها وتصنيف الوثائق مراحل عملية في المؤسسات. الخطأ هنا مكلف بصمت: اسم مكان قُسم على حرف جر قد لا يظهر في فهرس الأسماء. لذلك تُراجع المخرجات في المجالات القانونية والطبية والمالية حتى لو بدا الملخص سلسًا.
الكتابة والإنتاج اللغوي الآلي
الاقتراح الإملائي، وإكمال الجملة، وإعادة الصياغة، وإعداد مسودة تقرير من نقاط، تطبيقات توليد مألوفة. حدودها أن الطلاقة تغري بتخطي المراجعة. المسودة أداة بدء لا وثيقة انتهت مسؤوليتها. حين يكون النص منسوبًا إلى مؤسسة أو يقرر حقًا، تبقى مراجعة الوقائع والأسلوب البشري جزءًا من المهمة لا خطوة شكلية.
التطبيقات التعليمية وإتاحة الوصول
تحليل إجابة مفتوحة، وتبسيط جملة معقدة، وتدريب متعلم لغة على إعادة الصياغة، أمثلة على الاستخدام التعليمي. في العربية يتقاطع التشكيل مع الإتاحة: قارئ الشاشة وتركيبه الصوتي يحتاجان غالبًا إلى حركات صحيحة حتى لا يُنطق الاسم فعلًا. نظام تشكيل آلي جيد قد يكون أداة وصول، ونظام تشكيل ضعيف قد يعلّم نطقًا خاطئًا بثقة. تبسيط النصوص العلمية مفيد إن حُفظ القيد والمقدار، وضار إن حُذف الاستثناء ليصبح الجملة أسهل.
اقرأ أيضاً:
- تطبيقات الذكاء الاصطناعي في التعليم: الفرص والتحديات
- تطبيقات الذكاء الاصطناعي في علم الأدوية: التحديات والفرص
كيف نقيس دقة وكفاءة أنظمة معالجة اللغات الطبيعية؟
لا تُختصر الجودة بكلمة «دقيق». كل مقياس يفترض تعريفًا للنجاح، وهذا التعريف هو المهمة.
مقاييس تقييم تحليل النصوص وتصنيفها
الدقة (Accuracy) نسبة القرارات الصحيحة إلى كل القرارات. الإحكام (Precision) يسأل: من بين ما أعلنه النظام إيجابيًا، كم كان إيجابيًا فعلًا؟ الاسترجاع (Recall) يسأل: من بين الحالات الإيجابية الحقيقية، كم التقط النظام؟ مقياس F1 وسط توافقي بينهما:
F1 = 2 × Precision × Recall / (Precision + Recall) مصفوفة الالتباس (Confusion Matrix) تعرض الصواب والخطأ لكل باب، لا كرقم واحد. الدقة العامة تضلل حين تميل الفئات. في مثال إيضاحي، إن كان 95% من الرسائل غير مزعجة، فمصنّف يسمي كل الرسائل «غير مزعجة» يبلغ دقة 95% واسترجاعًا صفرًا للفئة التي تهم صاحب النظام. فجوة الدقة وF1 في التعرف على لهجات NADI 2024، 67.50 مقابل 50.57، من النوع نفسه من التحذير: الرقم الأعلى لا يلغي أن كثيرًا من التسميات فاتت أو زادت.
مقاييس تقييم الترجمة والتلخيص
BLEU، الذي قدمه بابينيني وزملاؤه عام 2002، يقارن الترجمة الآلية بترجمة مرجعية عبر دقة سلاسل الكلمات القصيرة، مع عقوبة للإيجاز الشديد. ROUGE، الذي قدمه لين عام 2004، يميل إلى قياس التداخل بين الملخص الآلي وملخص مرجعي، تداخلًا يشبه الاسترجاع. BERTScore يقارن تمثيلات سياقية للجمل، فيعطي تشابهًا أعلى للصياغات المختلفة التي تتقارب متجهاتها. هذه المقاييس تقيس علاقة بالمرجع أو بين التمثيلات، لا الحقيقة الواقعية كاملة، ولا قبول القارئ دائمًا. ترجمة عربية سليمة تصرف الفعل أو تضم الضمير بصورة تختلف عن المرجع قد تُعاقب في المطابقة الحرفية رغم صحة المعنى، وهي مشكلة معروفة في اللغات الغنية صرفيًا. لذلك يبقى التقييم البشري للوفاء بالمعنى والسلامة والطلاقة لازمًا بجانب الرقم، لا زينة له.
تقييم النماذج اللغوية الحيرة (Perplexity) تقيس اندهاش النموذج من نص:
كلما انخفضت كان النص أقرب إلى ما يتوقعه النموذج. صيغتها الشائعة لمتسلسلة طولها N:
PP = exp( − (1/N) × Σ log P(wi | w<i) )
الحيرة المنخفضة لا تعني أن المعلومات صحيحة. نص طلق كاذب قد يكون متوقعًا لغويًا. تقييم النماذج التوليدية ينظر أيضًا إلى الاتساق، واتباع التعليمات، والتعامل مع سياقات جديدة، والصحة الواقعية. التقييم البشري مكلف ومتحيز إن لم تُضبط تعليماته. واستخدام نموذج لغوي حكمًا على نموذج آخر ممارسة منتشرة ولها حد: الحكم يحمل تفضيلات نموذجه، وقد يفضّل أسلوبًا يشبهه. هو أداة فرز لا معيارًا نهائيًا.
اقرأ أيضاً:
- الدالة الأسية (Exponential Function): المفهوم، الخصائص، والتطبيقات
- التابع اللوغاريتمي: الدليل العلمي الشامل من القوانين الأساسية حتى التطبيقات المعقدة
| المقياس | المهمة المناسبة | ما الذي يقيسه | ما الذي يتركه خارج القياس | ملحوظة |
|---|---|---|---|---|
| الدقة (Accuracy) | تصنيف النصوص | نسبة القرارات الصحيحة إلى كل القرارات | توزيع الخطأ بين الفئات | يضلل مع الفئات غير المتوازنة |
| الإحكام (Precision) | التصنيف ووسم الكيانات | من بين ما أعلنه النظام إيجابيًا، كم كان إيجابيًا فعلًا | الحالات الإيجابية التي فاتت النظام | يُقرأ مع الاسترجاع |
| الاسترجاع (Recall) | التصنيف ووسم الكيانات | من بين الحالات الإيجابية الحقيقية، كم التقط النظام | الإنذارات الزائدة التي أعلنها النظام | يُقرأ مع الإحكام |
| مقياس F1 | التصنيف ووسم الكيانات | وسط توافقي بين الإحكام والاسترجاع | نوع الأخطاء وتوزيعها بين الأبواب | تكمله مصفوفة الالتباس |
| BLEU | الترجمة الآلية | دقة سلاسل الكلمات القصيرة مقارنةً بترجمة مرجعية | المعنى المنقول بصياغة تخالف المرجع | قد يعاقب ترجمة عربية سليمة |
| ROUGE | التلخيص | التداخل بين الملخص الآلي والملخص المرجعي | الصحة الواقعية وقبول القارئ | يشبه الاسترجاع |
| BERTScore | الترجمة والتلخيص | تشابه التمثيلات السياقية للجمل | الصحة الواقعية | يتسامح مع اختلاف الصياغة |
| الحيرة (Perplexity) | نماذج اللغة | مدى اندهاش النموذج من نص؛ الأقل أقرب إلى توقعه | صدق المعلومات واتباع التعليمات | الحيرة المنخفضة لا تعني صحة |
| التقييم البشري | الترجمة والتلخيص والتوليد | الوفاء بالمعنى والسلامة والطلاقة | الاتساق حين تغيب تعليمات تقييم منضبطة | مكلف ومتحيز إن لم تُضبط تعليماته |
لماذا لا تكفي نتيجة اختبار واحد؟
مجموعة اختبار واحدة قد تشبه التدريب أكثر مما تشبه الاستعمال. التسرب (Data Leakage) دخول أسئلة الاختبار إلى التدريب داخل التجربة نفسها. تلوث المعايير (Benchmark Contamination) أوسع في زمن النماذج المدربة على الويب: مجموعات الاختبار منشورة، فربما رآها النموذج قبل الامتحان. مراجعة سيمين تشن وزملائه في EMNLP 2025 ترصد انتقال التقييم من معايير ثابتة إلى معايير ديناميكية تُحدَّث للحد من هذا الخطر، وتشير إلى فجوة مقابلة: ما زالت معايير الحكم على جودة الاختبار الديناميكي نفسه غير متفق عليها. النتيجة المرتفعة قد تعني تعميمًا، وقد تعني تذكرًا. من دون معرفة تاريخ البيانات لا يُحسم الأمر.
التنوع ضروري: مجالات مختلفة، ولهجات، وأساليب إملاء، وأسئلة لم تُكتب بصيغة القالب الشائع. الاختبار الذي لا يتغير عامًا بعد عام يصير، مع النشر الواسع، أقرب إلى مادة تدريب مؤجلة.
اختبار قدرة النموذج على التعميم
التعميم أداء على نص لم يُستخدم في التدريب، وفي مجال أو لهجة أو صياغة لم تُمثَّل تمثيلًا كافيًا. مقاومة التغيير الإملائي، والانتقال من الأخبار إلى المحادثة، ومن الفصحى إلى لهجة مدينة، اختبارات أصدق من إعادة نتيجة مشهورة. التفوق على معيار بحثي إنجاز حقيقي داخل تعريفه، والنجاح في الاستخدام الواقعي يضيف قيود الزمن والتكلفة والخطأ المكلف وتغير المستخدمين. نظام يفوز في تصنيف مراجعات الفنادق لم يبرهن بعد أنه يفهم شكوى مكتوبة بالعربيزي عن شحنة في عمّان.
ما حدود معالجة اللغات الطبيعية ومخاطرها؟
صعوبة فهم السياق والمعنى المقصود
الغموض، والسخرية، والمجاز، والإحالة إلى معرفة خارج النص، والإشارات الاجتماعية، تبقى مناطق ضعف نسبية حتى مع النماذج الكبيرة. النظام يجيد تعميم أنماط رآها. المقصد البشري قد يعتمد على شيء لم يُكتب: علاقة المتكلم بالمخاطب، أو حدث بالأمس، أو قاعدة مجتمع. التعرف على النمط ليس فهمًا بالمعنى الذي يحمّل القائل مسؤولية. هذه الحدود لا تمنع الاستخدام؛ تمنع تفسير النتيجة بأكثر مما تسنده المهمة.
التحيز في البيانات والنماذج اللغوية
النموذج يعيد إنتاج ما غلب في تدريبه. إن غابت لهجة، ساء أداؤها. وإن ارتبطت أسماء أو صفات بصور نمطية في النصوص، فقد تظهر في الإجابات. التحيز قد يكون جغرافيًا ولغويًا لا أخلاقيًا فحسب: تركيز البيانات والأبحاث على الفصحى الإخبارية وعلى أزواج لغوية قليلة، كما توثق مراجعة التبديل اللغوي لعام 2025، يعني أن جودة الخدمة غير موزعة بالتساوي على مستخدمي العربية. مراجعة مصادر التدريب، واختبار المجموعات المختلفة اختبارًا منفصلًا، جزء من قياس النظام لا ملحق علاقات عامة.
المعلومات غير الصحيحة والهلوسة اللغوية
الهلوسة، في اصطلاح النماذج التوليدية، إنتاج محتوى لا يسنده المصدر أو الواقع، مع صياغة قد تكون سليمة. مراجعات الظاهرة، ومنها مسح جي وزملائها المنشور عام 2023، تجمع أسبابًا عدة: هدف التدريب لغوي، وفجوات المعرفة، والتحفيز الذي يشجع إجابة واثقة، وضعف الربط بمصدر. الاحتمال اللغوي يجيب عن «ما أشيع تكملة؟» لا عن «ما الحقيقة؟». لذلك لا تكفي طلاقة الجملة للثقة بها. التخفيف الممكن مزيج من الاسترجاع من مصدر موثوق، وعرض المرجع، ورفض الإجابة حين لا يوجد سند، ومراجعة بشرية حيث الضرر محتمل. لا واحدة من هذه تكفي وحدها.
الخصوصية وحقوق البيانات
تدريب النماذج على نصوص منشورة على الويب قد يتضمن بيانات شخصية كُتبت لغرض آخر. أبحاث الاستخراج، مثل عمل كارليني وزملائه حول استرجاع عينات من بيانات التدريب، أظهرت أن بعض النصوص قد تُستعاد من النماذج في ظروف معينة. هذا خطر خصوصية، لا فضولًا أكاديميًا فقط. تُضاف حقوق أصحاب المحتوى المستخدم في التدريب، والحاجة إلى توثيق المصادر، وحذر المستخدم من إدخال وثائق حساسة في نظام لا يعرف سياسة الاحتفاظ به. الحماية هنا سياسات وتقنيات معًا: تقليل البيانات، والعزل، وعدم معاملة كل نص عام كأنه متاح لكل تدريب.
اقرأ أيضاً:
- أمن المعلومات: الدليل العلمي الشامل لحماية البيانات ومواجهة التهديدات السيبرانية
- الأمن السيبراني: المبادئ العلمية، بنية الأنظمة، وآليات الحماية الرقمية
التكلفة الحاسوبية ومتطلبات التشغيل
تدريب النماذج الكبيرة يحتاج بنية متخصصة ووقتًا وطاقة. حتى الاستدلال، حين يُستخدم على نطاق واسع، له تكلفة تتراكم مع طول النص وعدد المستخدمين. دراسات مبكرة مثل دراسة ستروبل وغانيش وماكالوم عام 2019 نبهت إلى أثر تدريب الشبكات الكبيرة في استهلاك الطاقة قبل موجة النماذج الأضخم. النموذج الأكبر ليس الخيار العقلاني لكل مهمة: مصنّف متخصص جيد البيانات قد يتفوق على نموذج عام عملاق في باب ضيق، وبتكلفة أقل يمكن تفسيرها. المقارنة العادلة تضع الجودة والكمون والذاكرة والطاقة معًا.
ما المفاهيم الشائعة الخاطئة عن معالجة اللغات الطبيعية؟
❌ الخرافة: معالجة اللغات الطبيعية هي روبوتات المحادثة.
✅ الحقيقة: المحادثة تطبيق واحد. المجال يشمل البحث، والترجمة، والتدقيق، واستخراج الكيانات، والتصنيف، والتلخيص، والتحليل الصرفي، حتى حين لا يوجد حوار ولا مولّد نصوص.
❌ الخرافة: النظام الذي يكتب نصًا سليمًا يفهم اللغة كما يفهمها الإنسان.
✅ الحقيقة: الإنتاج المقنع قد ينشأ من توقع الرمز التالي. الفهم البشري يتضمن مقصدًا ومسؤولية ومعرفة مقام لا يضمنها شكل الجملة. أثر إليزا، منذ ستينيات القرن العشرين، اسم قديم لهذه النسبة المتسرعة.
❌ الخرافة: النماذج اللغوية الكبيرة هي معالجة اللغات الطبيعية.
✅ الحقيقة: هي تقنية مركزية اليوم داخل المجال، إلى جانب القواعد والإحصاء والمحللات الصرفية وأنظمة الاسترجاع. اختزال المجال فيها يخفي أدوات ما زالت أدق في مهام ضيقة، ومنها مهام عربية صرفية.
❌ الخرافة: زيادة حجم النموذج تحسّن كل المهام دائمًا.
✅ الحقيقة: الحجم ساعد في التعميم عبر مهام كثيرة، غير أن البيانات، واللغة المستهدفة، وتصميم التقسيم، والضبط، والتقييم، قد تغلب فرق الحجم. AraBERT المتخصص تفوق على نموذج متعدد اللغات أكبر تنوعًا في تغطيتها اللغوية، في مهام عربية بعينها، من غير أن يكون الأكبر عالميًا.
❌ الخرافة: النتيجة المرتفعة على اختبار مشهور تعني نجاحًا في كل استخدام.
✅ الحقيقة: الاختبار يقيس ما صُمم له، وقد يتلوث بنشره على الويب. أداء الأخبار الفصيحة لا يضمن أداء اللهجة أو العربيزي أو وثيقة قانونية، والدقة وحدها قد تخفي فشلًا على الفئة النادرة.
إلى أين تتجه أبحاث معالجة اللغات الطبيعية؟
تحسين معالجة اللغات منخفضة الموارد
اللغات واللهجات التي لا تملك مدونات موسومة كبيرة تستفيد من التعلم بالنقل (Transfer Learning): بدء من نموذج دُرب على لغة قريبة أو على مزيج لغات، ثم ضبطه ببيانات أقل. النماذج متعددة اللغات خطوة في هذا الاتجاه، وتجربة AraBERT تذكر بأن التخصيص قد يتفوق على التعميم متعدد اللغات حين تتوفر مدونة عربية كافية. الاتجاه البحثي هنا بناء بيانات أنظف وأكثر تنوعًا، لا تكبير النموذج فقط.
تحسين معالجة العربية واللهجات
الأولوية الموثقة في المراجعات الحديثة تمثيل اللهجات تمثيلًا جغرافيًا أعدل، ومعالجة التبديل بين الفصحى واللهجة وبين العربية وغيرها، وتحسين الصرف والدلالة لا الترجمة وحدها، وبناء اختبارات تُبقي المدن والأنماط الإملائية منفصلة حتى لا يختفي الفشل داخل متوسط عام. MADAR مفيد لأنه متوازٍ، وناقص لأنه مترجم ومحدود المجال. البيانات العفوية الموسومة أغلى وألزم.
تطوير نماذج لغوية أكثر كفاءة
النماذج الصغيرة المتخصصة، وتحسين سرعة الاستدلال، والضبط الذي لا يحدّث كل المعاملات، اتجاه عملي لا تراجع عن الجودة بالضرورة. الضبط الفعال من حيث عدد المعاملات (Parameter-Efficient Fine-Tuning)، ومن أشهر صوره LoRA التي طرحها هو وزملاؤه، يحدث مصفوفات صغيرة تُضاف إلى النموذج المجمد، فيقلل كلفة تكييفه مع مهمة أو لغة. هذا أنسب لكثير من المؤسسات من إعادة تدريب نموذج عام.
دمج اللغة مع أنواع البيانات الأخرى
النماذج متعددة الوسائط تربط النص بالصورة أو الصوت أو الفيديو. السؤال البحثي ليس إضافة صورة للعرض، بل هل يستطيع النظام أن يستند إلى دليل بصري حين يكون النص غامضًا، وأن يمتنع عن اختلاق ما لا يراه. في العربية، ربط الكلام اللهجي بنص مكتوب، أو ربط مستند مصور باستخراج معلومات، تطبيقات بحثية وعملية تتقدم بسرعات متفاوتة بحسب توفر البيانات الموسومة.
تحسين الموثوقية وقابلية التفسير
الحد من التحيز، وقياس عدم اليقين، وربط الادعاء بمصدر، وتفسير قرار صرفي أو تصنيفي تفسيرًا يمكن مراجعته، موضوعات بحث مفتوحة لا وعودًا منجزة. معايير التقييم الديناميكية محاولة لمواجهة التلوث، وهي نفسها تحتاج معايير حتى لا يصبح تحديث الاختبار مصدر لبس جديد. الخصوصية وتوثيق البيانات جزء من موثوقية النظام، لأن نتيجة لا يُعرف منشأ تدريبها يصعب محاسبتها.
اقرأ أيضاً: الثورة الصناعية الرابعة: الدليل العلمي الشامل للتقنيات التي تعيد صياغة مستقبل البشرية
التوصية العلمية من موقعنا
- حدّد المهمة قبل النموذج. الترجمة، واسترجاع وثيقة، وتصنيف شكوى، واستخراج اسم علم، أسئلة تقييمية مختلفة. البدء بنموذج توليدي عام قبل معرفة المخرج المطلوب يخلط الطلاقة بالنجاح.
- عامل التطبيع العربي كفرضية تُختبر. فصل اللواصق وتوحيد الهمزة وحذف الحركة تغيّر الدليل المتاح للنموذج. قارن النسخة المقطعة بغير المقطعة على المهمة نفسها، ولا تنقل نتيجة تحليل المشاعر إلى التعرف على الكيانات.
- افصل الفصحى عن اللهجة عن العربيزي في الاختبار. المتوسط الواحد يخفي فشل مدينة أو نمط كتابة. بيانات MADAR المتوازية مناسبة للمقارنة المنضبطة، ولا تغني عن نص عفوي من الاستعمال الذي ستواجهه.
- اقرأ المقياس مع تعريف خطئه. الدقة مع فئة نادرة، وBLEU مع صرف غني، والحيرة مع سؤال الصدق، كلها أرقام ناقصة وحدها. اطلب الإحكام والاسترجاع ونوع الخطأ، وأضف حكمًا بشريًا حين يكون المعنى هو المنتج.
- لا تفصل التوليد عن مصدر حين تكون الحقيقة مطلوبة. التوليد المعزز باسترجاع موثق، مع الامتناع عن الجواب عند غياب السند، أقرب إلى الاستخدام المسؤول من قبول النص لمجرد تماسكه.
- صغّر التجربة قبل تكبير النموذج. في كثير من المهام المؤسسية، بيانات موسومة نظيفة ونموذج متوسط الحجم المضبوط على المجال يعطيان نتيجة قابلة للتفسير بتكلفة أقل. التكبير مسوغ حين يفشل هذا المسار فشلًا مقيسًا، لا قبل قياسه.
- وثّق ما دخل التدريب وما مُنع من الاختبار. التسرب وتلوث المعايير لا يُكشفان من درجة مرتفعة. الاحتفاظ بنسخة اختبار مغلقة، وتسجيل مصادر المدونة، جزء من النتيجة العلمية لا من إدارة الملفات.
تبقى معالجة اللغات الطبيعية حسابًا على تمثيلات للغة، لا دخولًا إلى القصد البشري من بابه الفلسفي. أهميتها العملية أن هذا الحساب صار دقيقًا بما يكفي للترجمة والبحث والاستخراج والمساعدة على الكتابة، وحدّها الدائم أن سلاسة المخرج لا تشهد بصدقه ولا بعدالة بياناته ولا بصلاحه لكل لهجة. العربية تجعل هذا الحد مرئيًا: ما يُحذف في التطبيع، وما يُفصل في اللصق، وما يُستبعد من اللهجات، يقرر سلفًا ما الذي سيقدر الحاسوب على رؤيته. أي جزء من اللغة نطلب من النظام أن يحتفظ به، وأي جزء نطلب منه أن يمحوه قبل أن يبدأ؟
تتقاطع موضوعات هذا المقال (التقييم، والموثوقية، والتحيز، والخصوصية، ومعالجة النص العربي) مع الأطر والمعايير الرسمية الآتية، ويُنصح بالرجوع إليها عند بناء أنظمة معالجة اللغة أو نشرها:
- NIST AI Risk Management Framework (AI RMF 1.0) — إطار إدارة مخاطر الذكاء الاصطناعي الصادر عن المعهد الوطني الأمريكي للمعايير والتقنية (2023).
- NIST AI 600-1: Generative AI Profile — ملف خاص بمخاطر الذكاء الاصطناعي التوليدي، ومنها اختلاق المعلومات وتسرب البيانات (2024).
- ISO/IEC 42001:2023 — معيار نظام إدارة الذكاء الاصطناعي داخل المؤسسات.
- ISO/IEC 22989:2022 — مفاهيم الذكاء الاصطناعي ومصطلحاته.
- Regulation (EU) 2024/1689 — قانون الاتحاد الأوروبي للذكاء الاصطناعي.
- UNESCO Recommendation on the Ethics of Artificial Intelligence — توصية اليونسكو بشأن أخلاقيات الذكاء الاصطناعي (2021).
- Unicode Standard Annex #9 (UAX #9) — خوارزمية الاتجاه الثنائي في يونيكود، وهي مرجع معالجة النص العربي المختلط بالأرقام والحروف اللاتينية.
- Model Cards وData Statements for NLP — ممارسات توثيق النماذج وبيانات التدريب المقترحة في الأدبيات البحثية (2018 – 2019).
المصادر والمراجع
المعلومات الواردة في هذا المقال مقدَّمة لأغراض التثقيف العلمي فقط، ولا تُشكّل بديلًا عن الاستشارة الأكاديمية أو المهنية المتخصصة، ولا عن مراجعة مختص في المجال الهندسي أو القانوني أو الطبي أو المالي. الأرقام والنتائج المذكورة تعود إلى دراسات ومعايير واختبارات محددة في تواريخ معينة، ولا تعني أن أي نظام أو نموذج سيعطي الأداء نفسه في بيئتك أو على بياناتك.
مخرجات أنظمة معالجة اللغات الطبيعية والنماذج اللغوية الكبيرة قد تكون سليمة الصياغة وخاطئة المضمون، وقد تحمل تحيزات أو تنسب إلى مصادر ما لا يوجد فيها. لذلك لا تعتمد عليها وحدها في قرار يمس صحة أحد أو حقوقه أو أمواله. وتجنّب إدخال بيانات شخصية أو وثائق سرية في أي نظام لا تعرف سياسة احتفاظه بالبيانات. أسماء النماذج والأدوات المذكورة وردت للتوضيح العلمي، ولا تُعد توصية بها ولا ترويجًا لها.
موقع خلية لا يتحمل أي مسؤولية قانونية أو علمية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين.