البيانات الضخمة (Big Data): كيف تحرك الأرقام العالم وتصنع مستقبل التكنولوجيا؟
هل أصبحت الأرقام الوقود الجديد الذي يُحرك اقتصادات الأمم ويُعيد رسم خرائط النفوذ التكنولوجي؟

البيانات الضخمة (Big Data) مصطلح تقني يُشير إلى مجموعات معلوماتية هائلة الحجم ومتباينة البنية، يتجاوز معدل تدفقها اليومي 402.74 مليون تيرابايت وفق تقديرات 2024، وتعجز أنظمة قواعد البيانات التقليدية عن معالجتها، مما يستدعي بنى حوسبية موزعة وخوارزميات متقدمة لاستخراج القيمة المعرفية والاقتصادية منها.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات
- تجاوز حجم البيانات العالمية 181 زيتابايت بحلول 2025 وفق IDC، وتُعرَّف البيانات الضخمة بتقاطع خمس خصائص هي 5Vs وليس الحجم فقط.
- تُنفق فرق علم البيانات 60% إلى 80% من وقتها في تنظيف البيانات قبل أي تحليل فعلي.
- أطر عمل مثل Hadoop وSpark تُوزّع المعالجة على آلاف الخوادم، فيما تعتمد منصات كنتفليكس وأمازون على هذه التقنيات لتوليد توصيات وأرباح مباشرة.
- في السعودية، تُستخدم البيانات الضخمة في أرامكو للصيانة التنبؤية، وفي المدن الذكية كنيوم لإدارة الطاقة والمرور.
- البيانات “المُجهّلة” ليست آمنة كما يُشاع؛ أثبتت دراسة في Nature Communications إمكانية إعادة تعريف 99.98% من الأفراد من مجموعات بيانات مجهّلة تحتوي 15 سمة فقط.
- متوسط تكلفة اختراق البيانات عالمياً بلغ 4.88 مليون دولار عام 2024 وفق IBM، ما يجعل الأمن السيبراني ركيزة لا غنى عنها.
بلغ حجم البيانات المُنشأة عالمياً عام 2020 نحو 64.2 زيتابايت، ويُتوقع أن يتجاوز 181 زيتابايت بحلول 2025 وفق تقرير مؤسسة IDC العالمية. هذا الرقم الفلكي يُعادل ما يستوعبه 181 مليار قرص صلب سعة 1 تيرابايت. لم يعد الأمر يتعلق بتخزين المعلومات، بل بإدارة محيطات رقمية تفيض في كل ثانية. ومن هنا وُلد مصطلح البيانات الضخمة ليُعبّر عن تحول جذري في طبيعة التعامل مع الأرقام والنصوص والوسائط.
تفكيك المفهوم: ما وراء التعريف الأكاديمي للبيانات الضخمة
يذهب البعض إلى أن البيانات الضخمة مجرد كميات كبيرة من المعلومات، غير أن هذا الفهم قاصر تماماً. فالتعريف التقني الدقيق يشمل ثلاثة أبعاد متكاملة: الحجم الهائل، والسرعة الفائقة في التوليد، والتنوع الشديد في الأنماط. ومن الناحية الفلسفية، تُمثل البيانات الضخمة نقلة إبستمولوجية في كيفية استخراج المعرفة، إذ انتقل العلم من الاعتماد على العينات الإحصائية الصغيرة إلى تحليل مجتمعات البيانات الكاملة (Population-scale Analytics).
الفرق الجوهري بين قواعد البيانات العلائقية التقليدية (Relational Databases) مثل MySQL وOracle، وأنظمة NoSQL الحديثة، يكمن في المرونة الهيكلية. فالأولى تعتمد على جداول ثابتة وعلاقات صارمة تُفرض عبر لغة SQL، بينما تسمح الثانية بتخزين وثائق JSON، أو أزواج مفتاح-قيمة، أو رسوم بيانية معقدة دون قيود بنيوية مسبقة. هذا التحرر من الجمود الهيكلي هو ما مكّن البيانات الضخمة من استيعاب الفوضى المعلوماتية للعالم الحديث.
أما مصادر توليد هذه المحيطات الرقمية فهي متشعبة. تتصدرها شبكات التواصل الاجتماعي التي تُنتج فيسبوك وحدها أكثر من 4 بيتابايت يومياً. تليها أجهزة إنترنت الأشياء (IoT) المنتشرة في المصانع والمنازل الذكية والسيارات. وتُساهم المعاملات المالية عبر البورصات العالمية بضخ ملايين السجلات في الثانية. كما تُغذي المستشعرات الطبية والأجهزة القابلة للارتداء تدفقاً حيوياً من البيانات الصحية اللحظية.
معلومة موسوعية سريعة: يستهلك محرك البحث غوغل نحو 3.5 مليار عملية بحث يومياً، وكل عملية تُولّد بيانات وصفية (Metadata) تُغذي خوارزميات الترتيب والتخصيص، مما يجعل غوغل واحداً من أضخم مُنتجي ومُعالجي البيانات على كوكب الأرض.
اقرأ أيضاً:
- الإحصاء التطبيقي: كيف يحول البيانات إلى قرارات واقعية؟
- تكنولوجيا المعلومات والاتصالات (ICT): المفهوم، المكونات، والدور
نموذج الـ 5Vs: الخصائص الخمس التي تُميز البيانات الضخمة
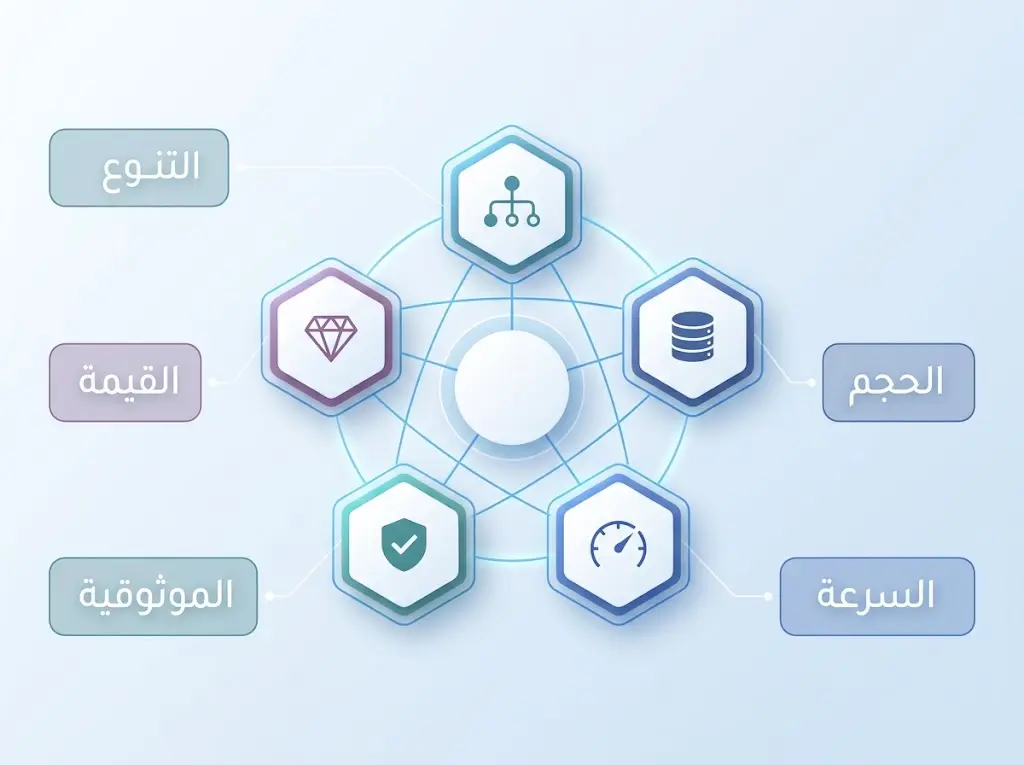
طوّر خبراء IBM ومختبرات جارتنر إطاراً معيارياً لفهم البيانات الضخمة عبر خمس خصائص جوهرية تبدأ جميعها بحرف V. هذه الخصائص ليست مجرد تصنيف نظري، بل هي المعايير الهندسية التي يستند إليها مهندسو البيانات لتصميم البنى التحتية المناسبة.
الحجم (Volume): انتقل مقياس التخزين من الجيجابايت إلى البيتابايت والإكسابايت، وصولاً إلى الزيتابايت (Zettabyte) الذي يُساوي مليار تيرابايت. مراكز بيانات شركات مثل أمازون ومايكروسوفت تستوعب اليوم إكسابايتات من المعلومات، ومصادم الهادرونات الكبير في سيرن (CERN) وحده يُولد نحو 90 بيتابايت من بيانات التجارب سنوياً.
السرعة (Velocity): لم يعد كافياً معالجة البيانات لاحقاً، بل باتت المعالجة اللحظية (Real-time Streaming) ضرورة قصوى. منصات مثل Apache Kafka وApache Flink تُعالج ملايين الرسائل في الثانية الواحدة. البورصات المالية تعتمد على خوارزميات التداول الفائق السرعة (High-Frequency Trading) التي تتخذ قرارات في مايكروثانية.
التنوع (Variety): تشمل البيانات الضخمة ثلاثة أنماط رئيسة: البيانات المُهيكلة (Structured) كجداول قواعد البيانات، والبيانات شبه المهيكلة (Semi-structured) كملفات XML وJSON، والبيانات غير المُهيكلة (Unstructured) كالنصوص الحرة والصور ومقاطع الفيديو. تُشكّل الأخيرة أكثر من 80% من إجمالي البيانات المُولّدة عالمياً وفق تقديرات مؤسسة IDC.
القيمة (Value): جوهر البيانات الضخمة ليس في حجمها بل في قدرتها على توليد قرارات ذكية وأرباح ملموسة. شركة نتفليكس مثلاً توفّر نحو مليار دولار سنوياً بفضل خوارزميات التوصية القائمة على تحليل سلوك المشاهدين.
الموثوقية (Veracity): تُشير إلى جودة البيانات ومدى نظافتها من الضوضاء والتشوهات. تُقدّر مؤسسة Gartner أن الشركات تخسر نحو 12.9 مليون دولار سنوياً بسبب رداءة جودة البيانات، وهو ما يجعل عمليات التنقية والتحقق ركيزة لا غنى عنها.
| الخاصية (V) | المعنى الهندسي | مثال من الواقع | التحدي الرئيسي |
|---|---|---|---|
| الحجم (Volume) | الانتقال من الجيجابايت إلى الزيتابايت | مصادم LHC في سيرن يولّد نحو 90 بيتابايت سنوياً | تكلفة البنية التحتية |
| السرعة (Velocity) | المعالجة اللحظية للتدفقات المستمرة | التداول الفائق السرعة بقرارات تُتخذ في مايكروثانية | زمن استجابة حرج |
| التنوع (Variety) | تعدد أنماط البيانات: مُهيكلة وشبه مُهيكلة وغير مُهيكلة | أكثر من 80% من البيانات العالمية غير مُهيكلة | صعوبة التوحيد والمعالجة |
| القيمة (Value) | القدرة على توليد قرارات ذكية وأرباح ملموسة | نتفليكس توفّر نحو مليار دولار سنوياً بخوارزميات التوصية | استخراج المعنى من الضجيج |
| الموثوقية (Veracity) | جودة البيانات ومدى نظافتها من التشوّهات | خسائر تُقدّر بـ 12.9 مليون دولار سنوياً بسبب رداءة الجودة (Gartner) | تنقية مستمرة |
رقم لافت: أضاف بعض الباحثين حرفي V إضافيين هما التغيرية (Variability) والتصور (Visualization)، ليصبح النموذج 7Vs، مما يعكس التطور المستمر لمفهوم البيانات الضخمة.
اقرأ أيضاً:
البنية التحتية الهندسية: كيف تعمل تقنيات Big Data من الداخل؟
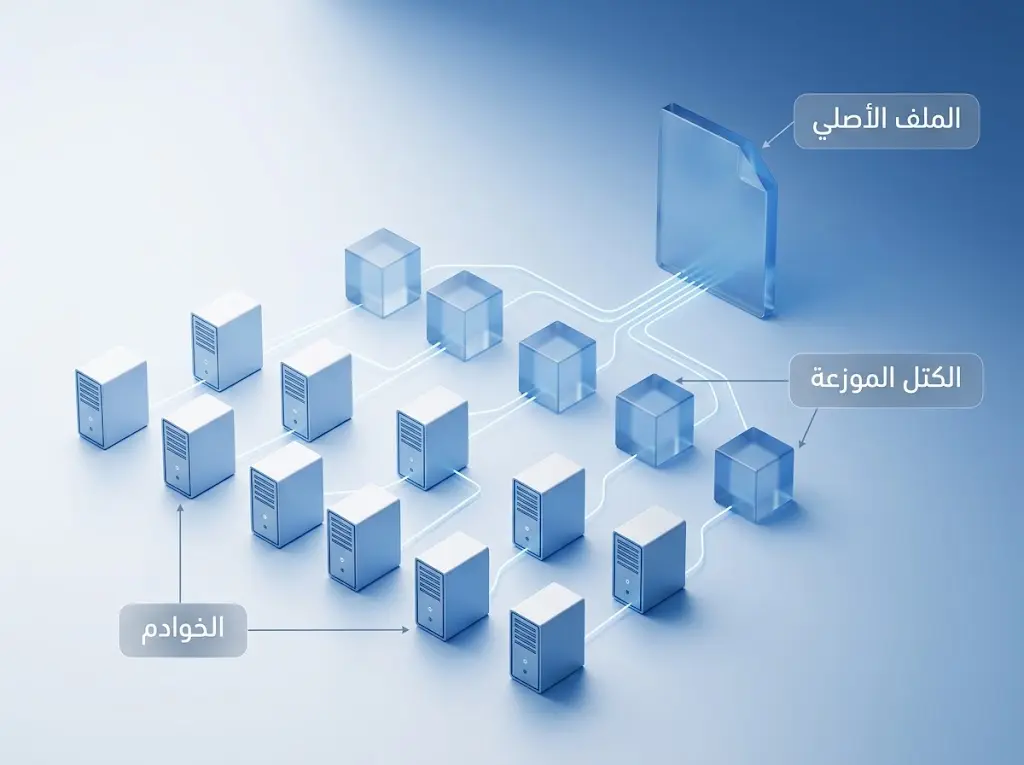
تقوم فلسفة الحوسبة الموزعة (Distributed Computing) على مبدأ بسيط لكنه ثوري: بدلاً من الاعتماد على حاسوب عملاق واحد، تُوزع المهام على مئات أو آلاف الخوادم العادية التي تعمل بالتوازي. هذا النموذج، المعروف باسم “المجموعة الحاسوبية” (Cluster)، يُتيح التوسع الأفقي (Horizontal Scaling) بتكلفة أقل وموثوقية أعلى، إذ إن فشل خادم واحد لا يُعطّل المنظومة بأكملها.
إطار عمل أباتشي هادوب (Apache Hadoop) يُعد الأب الروحي للحوسبة الموزعة للبيانات الضخمة. طوّرته مؤسسة أباتشي مستوحياً من أوراق غوغل البحثية عام 2003-2004. يتكوّن من مكونين رئيسين: نظام الملفات الموزع HDFS (Hadoop Distributed File System) الذي يُقسّم الملفات الضخمة إلى كتل صغيرة (Blocks) بحجم 128 ميغابايت افتراضياً، ويُخزّنها موزعة على خوادم متعددة مع نسخ احتياطية متعددة. والمكون الثاني هو خوارزمية MapReduce التي تُنفذ العمليات الحسابية عبر مرحلتين: التخطيط (Map) الذي يُوزع المهمة على العقد، والاختزال (Reduce) الذي يُجمّع النتائج النهائية.
جاء أباتشي سبارك (Apache Spark) ليُحدث ثورة حقيقية في سرعة المعالجة. فبدلاً من الكتابة المستمرة على الأقراص كما يفعل هادوب، يعتمد سبارك على المعالجة داخل ذاكرة الوصول العشوائي (In-Memory Processing)، مما يجعله أسرع بمعدل 100 ضعف في بعض السيناريوهات. يدعم سبارك خمس مكتبات متكاملة: Spark SQL للاستعلامات، MLlib لتعلم الآلة، GraphX للرسوم البيانية، Spark Streaming للتدفق اللحظي، وواجهات برمجية بلغات Python وScala وR وJava.
في عالم قواعد البيانات غير العلائقية (NoSQL) تبرز أسماء عملاقة. قاعدة MongoDB التي تُخزّن البيانات كوثائق JSON مرنة، تُستخدم في تطبيقات المحتوى والتجارة الإلكترونية. أما Cassandra التي طوّرتها فيسبوك أصلاً، فتتفوق في السيناريوهات ذات الكتابة المكثفة والتوزيع الجغرافي الواسع. وتُستخدم Redis كقاعدة بيانات في الذاكرة للاستجابات الفائقة السرعة، بينما تتخصص Neo4j في تحليل العلاقات الشبكية المعقدة.
يبرز هنا مفهومان تقنيان يخلط بينهما كثيرون: بحيرات البيانات (Data Lakes) ومستودعات البيانات (Data Warehouses). بحيرة البيانات هي مستودع خام يستوعب البيانات بجميع أنواعها دون معالجة مسبقة، وتُستخدم للتحليلات الاستكشافية والذكاء الاصطناعي. أما المستودع فيحتوي بيانات نظيفة ومُهيكلة جاهزة لتقارير الأعمال. وقد ظهر مؤخراً مفهوم “بيت البيانات الهجين” (Data Lakehouse) الذي يجمع مزايا النظامين معاً.
| وجه المقارنة | Apache Hadoop | Apache Spark |
|---|---|---|
| آلية المعالجة | كتابة وقراءة متكررة على القرص الصلب | معالجة داخل الذاكرة العشوائية (In-Memory) |
| السرعة النسبية | أبطأ بسبب عمليات الإدخال والإخراج المتكررة | أسرع بمعدل يصل إلى 100 ضعف في بعض السيناريوهات |
| المكوّنات الأساسية | HDFS للتخزين + خوارزمية MapReduce | محرك موحّد يضم Spark SQL وMLlib وGraphX وStreaming |
| نشأة التقنية | مستوحى من أوراق غوغل البحثية 2003–2004 | تطوّر لاحقاً كبديل أسرع لتجاوز قيود هادوب |
| حالة الاستخدام الأمثل | معالجة دُفعية ضخمة لبيانات أرشيفية (Batch) | معالجة لحظية وتحليلات تفاعلية وتعلّم آلي |
اقرأ أيضاً:
- الحوسبة السحابية (Cloud Computing): المفهوم، النماذج، والتطبيقات
- نماذج الحوسبة السحابية: IaaS، PaaS، وSaaS
- التخزين السحابي: ما هو وكيف يُغير طريقة حفظ بياناتنا؟
تشريح عملية بث فيديو على منصة مثل شاهد أو نتفليكس
في اللحظة التي يبدأ فيها مشاهد سعودي بث فيلم على منصة رقمية عبر شبكة 5G، تنطلق سلسلة تفاعلات هندسية معقدة. تُرسل خوارزميات المنصة استعلاماً إلى بحيرة بيانات ضخمة تُخزن سجلات مشاهدة مئات الملايين. يُحلل نظام التوصية أنماط المشاهدة السابقة، وتفضيلات الأنواع، وحتى اللحظات التي أُوقف فيها الفيديو مؤقتاً. بالتوازي، يُقيّم نظام تكييف معدل البت (Adaptive Bitrate) جودة الشبكة كل ثانيتين، فيرفع دقة الفيديو حين تكون سرعة الاتصال عالية في الظهيرة الحارة حين يجلس أفراد الأسرة في المنزل، وينخفض تلقائياً عند تراجعها. كل نقرة، وكل توقف، وكل بحث، يُغذي تدفقاً بيانياً يمر عبر Apache Kafka إلى خوارزميات سبارك، لتُعاد صياغة قائمة المقترحات فوراً. تعمل هذه المنظومة كأوركسترا موزعة على آلاف الخوادم في مراكز البيانات السحابية.
صندوق اقتباس علمي: يُشير تقرير معهد ماساتشوستس للتكنولوجيا (MIT) الصادر عن مركز MIT Sloan للأبحاث إلى أن “المؤسسات التي تعتمد على القرارات القائمة على البيانات (Data-driven Decision Making) تُحقق إنتاجية أعلى بنسبة 5% إلى 6% من نظيراتها التي تعتمد على الحدس التقليدي” وفق دراسة بروك برينجولفسون وزملائه المنشورة عبر مركز الأبحاث الرقمية بالمعهد.
دورة حياة البيانات الضخمة من الالتقاط إلى القرار
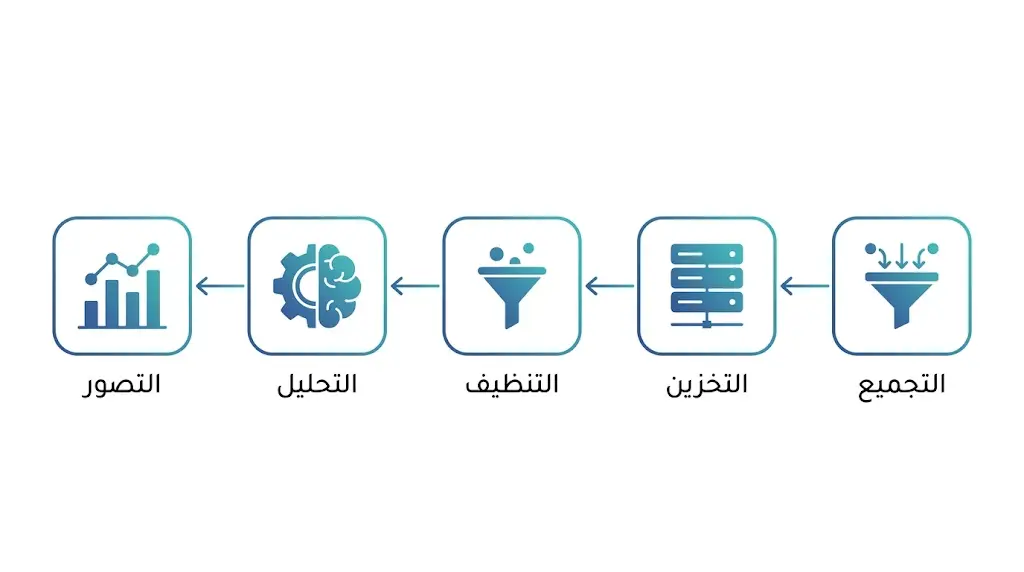
تبدأ الرحلة بمرحلة الاستلاب والتجميع (Data Ingestion) التي تُشكّل البوابة الأولى للبيانات. تُستخدم فيها أدوات متخصصة مثل Apache NiFi وApache Flume وAmazon Kinesis لسحب البيانات من مصادرها المتباينة: سجلات الخوادم، واجهات برمجة التطبيقات (APIs)، مستشعرات المصانع، وقواعد البيانات التقليدية. وتُقسم هذه العملية إلى نوعين: الاستلاب الدُفعي (Batch Ingestion) الذي يُجمّع البيانات في فترات زمنية محددة، والاستلاب التدفقي (Streaming Ingestion) الذي يعمل بشكل مستمر ولحظي.
يلي ذلك مرحلة التخزين والتنظيم، إذ تُوزع البيانات عبر منظومات موزعة مع تشفير طبقي متعدد المستويات. تعتمد الشركات الكبرى على معمارية “السلال” (Tiered Storage) التي تُصنّف البيانات وفق تكرار الوصول إليها: البيانات الساخنة (Hot) على أقراص SSD سريعة، والدافئة (Warm) على أقراص HDD، والباردة (Cold) على أنظمة أرشيفية منخفضة التكلفة كخدمة Amazon Glacier.
ثم تأتي مرحلة التنظيف والمعالجة المسبقة (Data Cleaning) التي يُنفق عليها علماء البيانات نحو 60% إلى 80% من وقتهم. تشمل هذه المرحلة إزالة التكرارات، وسد القيم المفقودة، وتوحيد التنسيقات، واكتشاف القيم الشاذة (Outliers) التي قد تُشوّه التحليل. تُستخدم فيها مكتبات مثل Pandas في بايثون، وأدوات مثل OpenRefine وTrifacta.
بعد التنظيف، تنطلق مرحلة التحليل والنمذجة عبر تقنيات التنقيب في البيانات (Data Mining) التي تكشف الأنماط المخفية. تُطبق خوارزميات التصنيف (Classification) والتجميع (Clustering) والانحدار (Regression) وقواعد الترابط (Association Rules). أشهر هذه الخوارزميات: K-Means للتجميع، والغابات العشوائية (Random Forests)، والشبكات العصبية العميقة.
أخيراً يأتي التصوير البياني (Data Visualization) الذي يُحوّل الأرقام الجافة إلى لوحات قيادة تفاعلية. تتصدر أدوات مثل Tableau وMicrosoft Power BI وApache Superset وGoogle Data Studio هذا المجال، إلى جانب مكتبات برمجية كـ D3.js وPlotly.
| المرحلة | الوصف الوظيفي | الأدوات والتقنيات المستخدمة | الناتج/المخرج | التحدي الرئيسي |
|---|---|---|---|---|
| الاستلاب والتجميع | سحب البيانات من مصادرها المتعددة دُفعياً أو تدفقياً | Apache NiFi, Apache Flume, Amazon Kinesis | بيانات خام مجمّعة من مصادر متباينة | تعدد المصادر وتباين الصيغ |
| التخزين والتنظيم | توزيع البيانات وفق معمارية السلال الساخنة والدافئة والباردة | HDFS, Amazon Glacier, SSD/HDD | بيانات مصنّفة حسب تكرار الوصول | التوازن بين التكلفة والسرعة |
| التنظيف والمعالجة المسبقة | إزالة التكرار وسد القيم المفقودة وتوحيد التنسيقات | Pandas, OpenRefine, Trifacta | بيانات نظيفة خالية من الشذوذ | 60%–80% من وقت المحلل |
| التحليل والنمذجة | تطبيق خوارزميات التصنيف والتجميع والانحدار | K-Means, Random Forests, الشبكات العصبية | أنماط واستنتاجات إحصائية | اختيار الخوارزمية الأنسب |
| التصوير البياني | تحويل النتائج إلى لوحات قيادة تفاعلية | Tableau, Power BI, D3.js | قرارات قابلة للتنفيذ | تبسيط دون تحريف الحقيقة |
لغز الأرقام المدفونة: تُقدّر مؤسسة IBM أن نحو 90% من البيانات المُخزنة عالمياً لم تُستخدم مطلقاً في أي تحليل، وهي ما يُعرف بـ “البيانات المظلمة” (Dark Data)، مما يعني أن كنوزاً معرفية هائلة لا تزال حبيسة الأقراص الصلبة.
اقرأ أيضاً:
البيانات الضخمة والذكاء الاصطناعي: العلاقة التكاملية المصيرية
تُشكّل البيانات الضخمة الوقود الأساسي الذي بدونه لن تعمل محركات الذكاء الاصطناعي. فنماذج التعلم الآلي (Machine Learning) تتعلم عبر معالجة كميات هائلة من الأمثلة، وكلما زادت جودة وتنوع البيانات، ارتفعت دقة النموذج. نموذج GPT-4 مثلاً دُرّب على مئات المليارات من الكلمات المستخرجة من الإنترنت، فيما احتاج نموذج AlphaFold من ديب مايند إلى قاعدة بيانات هائلة من هياكل البروتينات لحل لغز طي البروتين.
يُمثل التعلم العميق (Deep Learning) الطبقة الأكثر تعطشاً للبيانات. الشبكات العصبية الاصطناعية العميقة تحتوي على ملايين المعاملات (Parameters) التي تحتاج إلى تعديل دقيق عبر ملايين الأمثلة. بدون البنية التحتية للبيانات الضخمة، ستنهار هذه النماذج تحت وطأة عدم كفاية العينات التدريبية.
التحليلات التنبؤية (Predictive Analytics) تُمثل الثمرة الأنضج لهذا التكامل. تعتمد عليها البنوك للتنبؤ بالاحتيال، وشركات التأمين لتقدير المخاطر، ومنصات التسويق لاستشراف سلوك المستهلكين. مصرف البنك السعودي البريطاني (SABB) وغيره من البنوك في المنطقة العربية يستخدمون خوارزميات تحليل تنبؤية لرصد المعاملات المشبوهة في زمن حقيقي.
أما الذكاء الاصطناعي التوليدي (Generative AI) الذي فجّر ثورة 2022-2024، فيقوم كلياً على البيانات الضخمة. نماذج مثل ChatGPT وGemini وClaude وDeepSeek لم تكن لتوجد لولا وجود بنية تحتية قادرة على تخزين ومعالجة قواعد بيانات نصية بحجم بيتابايتات.
اقرأ أيضاً:
- التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
- شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
لماذا تفشل النماذج الإحصائية الكلاسيكية أمام تعقيد البيانات الحديثة؟
من منظور التحليل العلمي المتقدم، يوضح المهندس عبد الله محمد جمال – خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية – أن التبسيط الشائع لمعالجة البيانات الضخمة يميل إلى تصويرها على أنها مجرد “توسيع أفقي” لأنظمة قواعد البيانات التقليدية عبر إضافة خوادم أكثر، إلا أن أحدث النماذج الهندسية تكشف عن ديناميكية أعمق تتمثل في نظرية CAP (Consistency, Availability, Partition Tolerance) التي أثبتها إريك بروير عام 2000، والتي تُثبت رياضياً استحالة تحقيق الاتساق التام والتوفر الكامل وتحمل التقسيم في آن واحد داخل أي نظام موزع. هذا يُجبر مهندسي البيانات على قبول مقايضات معمارية دقيقة، مثل نموذج BASE (Basically Available, Soft state, Eventual consistency) الذي يُضحي بالاتساق اللحظي مقابل التوفر العالي. هذا المستوى من الفهم ضروري لتصميم أنظمة قادرة على الصمود عند التعامل مع ملايين المعاملات المتزامنة دون انهيار.
التطبيقات العملية للبيانات الضخمة في القطاعات الحيوية
في القطاع الطبي والصحي، أحدثت البيانات الضخمة قفزة نوعية. تحليل الجينوم البشري الذي كان يستغرق سنوات وملايين الدولارات في مشروع الجينوم البشري الأصلي (1990-2003)، أصبح اليوم يُنجز في أيام معدودة بتكلفة أقل من ألف دولار. تُستخدم البيانات الضخمة في التنبؤ بتفشي الأوبئة، إذ نجحت خوارزميات BlueDot الكندية في رصد إنذار مبكر لجائحة كوفيد-19 قبل تسعة أيام من إعلان منظمة الصحة العالمية. ويُمهّد الطب الشخصي المُخصص (Precision Medicine) لعصر تُصمم فيه العلاجات وفق الخريطة الجينية لكل مريض.
في القطاع المالي والاقتصادي، تعمل خوارزميات كشف الاحتيال عبر تحليل ملايين المعاملات في أجزاء من الثانية. منصة PayPal تُعالج نحو 41 معاملة في الثانية عالمياً، وتستخدم شبكات عصبية معقدة لرصد الأنماط المشبوهة. أما التداول الفائق السرعة (HFT) فيُنفذ صفقات تعتمد على تحليل بيانات السوق في ميكروثانية، ويُشكّل نحو 50% من حجم التداول في سوق الأوراق المالية الأميركية.
في التجارة الإلكترونية، تتصدر أمازون المشهد بأنظمة التوصية التي تُساهم بنحو 35% من إجمالي مبيعاتها. في المنطقة العربية، تعتمد منصات مثل نون وأمازون السعودية على تحليلات مماثلة لتخصيص العروض وفق المواسم كرمضان والأعياد والمواسم السياحية. تُصمم لكل مستخدم تجربة فريدة بناءً على سجل تصفحه، ومواقعه الجغرافية، وحتى حالة الطقس في مدينته.
المدن الذكية تُمثل ساحة تطبيق مذهلة للبيانات الضخمة. مشروع نيوم السعودي، ومدينة مصدر في الإمارات، ودبي الذكية، تعتمد جميعها على منظومات ضخمة لجمع بيانات حركة المرور، واستهلاك الطاقة، وجودة الهواء. تُحلل هذه البيانات لحظياً لتحسين إشارات المرور، وإدارة شبكات الكهرباء، وتقليل الانبعاثات الكربونية.
في البحث العلمي، تُنتج التلسكوبات الفضائية الحديثة كميات مذهلة من البيانات. تلسكوب جيمس ويب الفضائي (JWST) يُرسل نحو 57 غيغابايت يومياً، فيما سيُنتج مرصد فيرا روبين الفلكي (Vera C. Rubin Observatory) عند تشغيله الكامل نحو 20 تيرابايت ليلياً. أما مصادم الهادرونات الكبير في سيرن فيُولد بيانات تفوق قدرة أي حاسوب فردي على تحليلها، مما يستدعي شبكة الحوسبة العالمية WLCG.
معلومة موسوعية خاطفة: كل دقيقة تمر على الإنترنت في عام 2024 تشهد إرسال 241 مليون رسالة بريد إلكتروني، ومشاهدة 6 ملايين مقطع فيديو على تيك توك، وإجراء 6.3 مليون عملية بحث على غوغل، ورفع 34 مليون رسالة على واتساب، وفق تقرير Domo السنوي “Data Never Sleeps”.
اقرأ أيضاً:
- الزراعة الذكية: التكنولوجيا والبيانات لتحسين المحاصيل
- الثورة الصناعية الرابعة: الدليل العلمي الشامل للتقنيات التي تعيد صياغة مستقبل البشرية
التحديات الكبرى والوجه المظلم للبيانات الضخمة
مخاوف الخصوصية والأخلاقيات الرقمية تتصدر قائمة التحديات. فضيحة كامبريدج أناليتيكا عام 2018 كشفت كيف يمكن استغلال بيانات 87 مليون مستخدم على فيسبوك للتأثير على الانتخابات. صدرت لائحة حماية البيانات العامة الأوروبية (GDPR) عام 2018 كرد فعل تشريعي، وأصدرت المملكة العربية السعودية نظام حماية البيانات الشخصية (PDPL) الذي دخل حيز التنفيذ عام 2023، لتنظيم جمع ومعالجة البيانات.
التهديدات السيبرانية تُشكّل خطراً وجودياً على بحيرات البيانات الضخمة. تُقدّر شركة IBM في تقرير Cost of a Data Breach 2024 أن متوسط تكلفة اختراق البيانات وصلت إلى 4.88 مليون دولار عالمياً، وأن اكتشاف الاختراق يستغرق 258 يوماً في المتوسط. هجمات الفدية التي تستهدف مراكز البيانات الطبية والمالية أصبحت شبه يومية.
التكلفة العالية للبنية التحتية تُمثل عقبة رئيسة أمام الشركات الناشئة. بناء مركز بيانات متوسط الحجم يتطلب استثمارات تتراوح بين 100 مليون إلى مليار دولار، إضافة إلى تكاليف تشغيل ضخمة تشمل استهلاك الكهرباء والتبريد.
ظاهرة “البيانات المظلمة” (Dark Data) تُشير إلى المعلومات التي تجمعها المؤسسات دون استخدامها. تُقدّر Splunk أن 55% من بيانات المؤسسات تدخل في هذه الفئة، مما يُشكّل عبئاً تخزينياً واستهلاكاً للطاقة دون عائد.
أزمة نقص الكفاءات تُلاحق الصناعة عالمياً. تُقدّر مؤسسة QuantHub وجود فجوة تُقارب 250,000 وظيفة شاغرة في مجال علم البيانات في الولايات المتحدة وحدها، وتتضاعف هذه الفجوة في المنطقة العربية.
اقرأ أيضاً:
- الأمن السيبراني: المبادئ الأساسية وأهميته في العصر الرقمي
- كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
- أمن المعلومات: الدليل العلمي الشامل لحماية البيانات ومواجهة التهديدات السيبرانية
ما الذي يجعل الاختراق السيبراني لبيانات ضخمة أشد خطورة من اختراق قاعدة بيانات عادية؟
يكمن الفارق الجوهري في حجم الضرر والتعقيد. قاعدة بيانات عادية قد تحتوي على آلاف السجلات، بينما بحيرة بيانات ضخمة تحتوي على مليارات البيانات التي تشمل سلوكيات المستخدمين، والمعاملات المالية، والسجلات الصحية، والبيانات الجغرافية. ويزيد الأمر تعقيداً أن البنى الموزعة تعني وجود مئات نقاط الدخول المحتملة.
يرى الدكتور بكر وائل يبرودي – خبير الأمن السيبراني ومستشار حماية البيانات في موقع خلية – أن كثيراً من المؤسسات تقع في فخ التركيز على حماية البيانات الساخنة المُستخدمة يومياً، بينما تُهمل البيانات الباردة المُخزنة في أنظمة الأرشيف، رغم أنها تحتوي في الغالب على أكثر البيانات حساسية. والمفارقة أن هذه الأنظمة الأرشيفية تحظى بأضعف مستويات الحماية الأمنية.
اقرأ أيضاً:
- جدار الحماية (Firewall): الدليل العلمي والتطبيقي الشامل لمعمارية أمن الشبكات
- التشفير: الدليل العلمي الشامل لخوارزميات حماية البيانات ومستقبل الأمن السيبراني
المختبر التقني: تشريح الآلية الرياضية خلف MapReduce
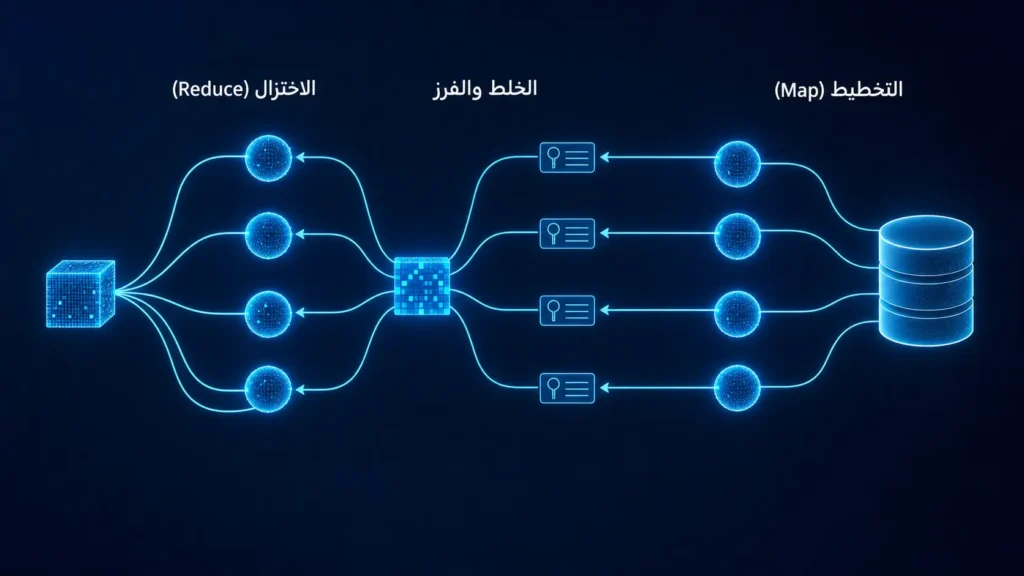
تعتمد خوارزمية MapReduce على مفهومين رياضيين مستوحيين من البرمجة الوظيفية (Functional Programming). دالة التخطيط (Map Function) تُطبق تحويلاً على كل عنصر في مجموعة الإدخال بشكل مستقل، وتُنتج أزواج (مفتاح، قيمة) وسيطة. رياضياً، إذا كان الإدخال I = {i₁, i₂, …, iₙ}، فإن ناتج التخطيط هو:
ثم تأتي مرحلة الخلط والفرز (Shuffle & Sort) التي تُجمّع القيم المرتبطة بنفس المفتاح من جميع العقد. بعدها تُنفّذ دالة الاختزال (Reduce Function) التي تُطبّق عملية تجميعية على مجموعة القيم المرتبطة بكل مفتاح:
القوة الحسابية لهذا النموذج تنبع من قابليته للتوازي (Parallelizability). التعقيد الزمني (Time Complexity) لمهمة تُنفذ على N عقدة يصبح تقريباً O(T/N) حيث T هو الزمن التسلسلي، مما يُتيح تسارعاً خطياً مع إضافة الخوادم. هذا ما يُعرف بقانون أمدال (Amdahl’s Law) المعدّل للحوسبة الموزعة. لكن هذا التسارع محدود بالعمليات التسلسلية غير القابلة للتوازي، مثل مرحلة الخلط التي تتطلب تواصلاً شبكياً مكثفاً بين العقد. لذلك تُصبح الشبكة الداخلية للمجموعة (Cluster Interconnect) عنق الزجاجة الحقيقي.
اقرأ أيضاً:
- الدليل الشامل لخوارزمية البحث الثنائي (Binary Search): من الأساسيات إلى التحليل المعقد
- الكمبيوتر: كيف غيّر هذا الاختراع العظيم مسار الحضارة البشرية؟
الاتجاهات المستقبلية: نحو أفق جديد للبيانات الضخمة
حوسبة الحافة (Edge Computing) تُمثل تحولاً معمارياً جذرياً. بدلاً من إرسال جميع البيانات إلى السحابة، تُعالج قرب مصدر توليدها. سيارة تسلا الذاتية القيادة تُنتج نحو 4 تيرابايت من البيانات يومياً، ومن غير العملي إرسالها كلها للسحابة. لذا تحتوي على وحدات معالجة عصبية (NPU) تُنفذ تحليلات فورية داخل السيارة.
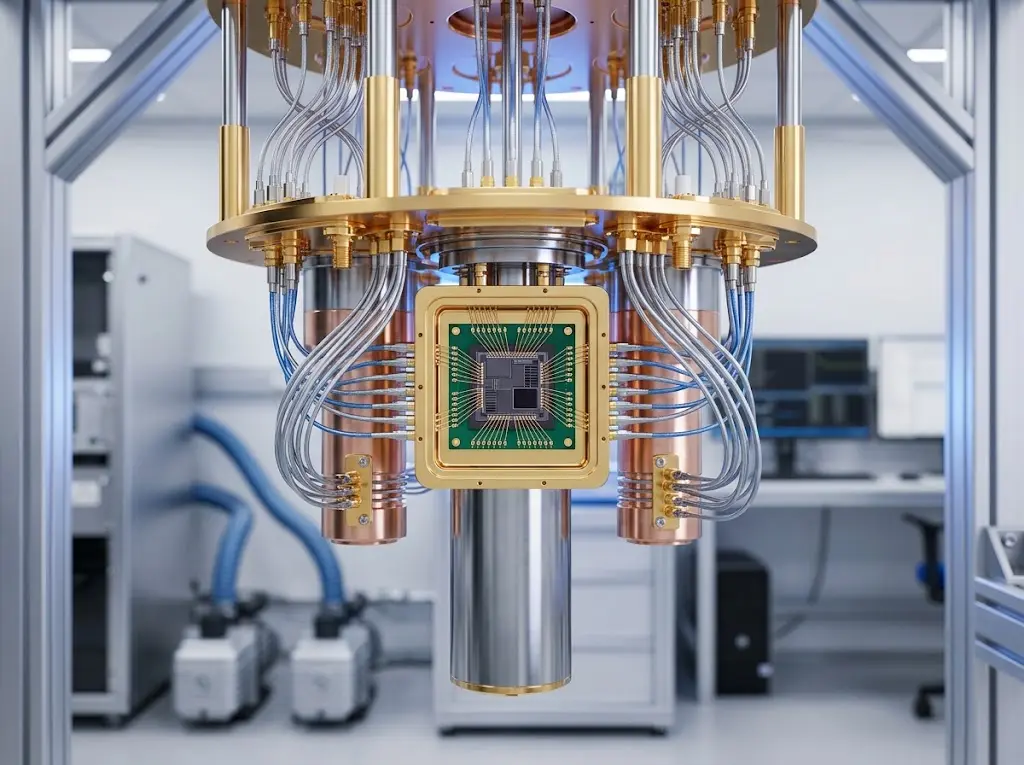
الحوسبة الكمومية (Quantum Computing) تعِد بقفزة تسريع خيالية. حاسوب غوغل الكمومي Sycamore أنجز حسبة في 200 ثانية كانت ستحتاج 10,000 سنة على أفضل حاسوب تقليدي. وأعلنت IBM عن معالج Condor الكمومي بألف كيوبت. تطبيقاته المتوقعة تشمل تحليل الجزيئات لاكتشاف الأدوية، وكسر التشفير الحالي.
أتمتة إدارة البيانات (DataOps) و(MLOps) تُطبّق مبادئ DevOps على خطوط أنابيب البيانات، لتحقيق التكامل المستمر والتسليم المستمر (CI/CD) لعمليات معالجة البيانات ونماذج تعلم الآلة.
البصمة الكربونية لمراكز البيانات تُشكّل هاجساً بيئياً متصاعداً. تستهلك مراكز البيانات عالمياً نحو 1-2% من إجمالي الكهرباء، ويُتوقع أن ترتفع النسبة إلى 8% بحلول 2030. تسعى شركات مثل غوغل ومايكروسوفت إلى تشغيل مراكزها بطاقة متجددة 100%، وتُطوّر تقنيات تبريد مبتكرة كالتبريد بمياه المحيط.
من المثير أن يُعرف: يستهلك تدريب نموذج ذكاء اصطناعي كبير مثل GPT-3 نحو 1,287 ميغاواط ساعة من الكهرباء، وينتج ما يُعادل 552 طناً من ثاني أكسيد الكربون، أي ما يُعادل انبعاثات 120 سيارة أميركية سنوياً وفق دراسة جامعة ماساتشوستس أمهيرست.
اقرأ أيضاً:
- التهدئة الكمومية (Quantum Annealing): المفهوم، الآلية، والتطبيقات
- الحوسبة بدون خادم (Serverless): النموذج الجديد لتطوير التطبيقات
خرافات شائعة وحقائق علمية حول البيانات الضخمة
❌ الخرافة: البيانات الضخمة تعني فقط “كميات كبيرة من البيانات”، وأي شركة تمتلك ملايين السجلات تتعامل مع Big Data.
✅ الحقيقة: البيانات الضخمة تُعرّف بتقاطع خمس خصائص (5Vs) وليس الحجم فحسب. جدول بيانات بحجم تيرابايت لكنه مُهيكل بالكامل يمكن معالجته بأدوات SQL تقليدية، ولا يُصنّف تقنياً كبيانات ضخمة. المصدر: تعريف Gartner الرسمي.
❌ الخرافة: كلما زادت كمية البيانات، ارتفعت جودة التحليل تلقائياً.
✅ الحقيقة: البيانات الرديئة، مهما كثرت، تُنتج نتائج مضللة. مبدأ “قمامة تدخل، قمامة تخرج” (GIGO) قاعدة راسخة في علوم الحاسب. الجودة تسبق الكمية دائماً وفق أبحاث MIT Sloan.
❌ الخرافة: الذكاء الاصطناعي يُمكنه استخلاص أي معرفة من البيانات دون تدخل بشري.
✅ الحقيقة: يحتاج علماء البيانات إلى إنفاق 60-80% من وقتهم في تنظيف البيانات وهندسة الخصائص (Feature Engineering) قبل أي تدريب. المصدر: استطلاع Kaggle السنوي لعلماء البيانات.
❌ الخرافة: البيانات المُجهّلة (Anonymized Data) آمنة تماماً ولا يمكن ربطها بأصحابها.
✅ الحقيقة: أثبتت دراسات جامعة إمبريال كوليدج لندن (Nature Communications 2019) أن 99.98% من الأميركيين يُمكن إعادة تعريفهم من مجموعات بيانات مُجهّلة تحتوي 15 سمة ديموغرافية فقط.
❌ الخرافة: الحوسبة السحابية تجعل البيانات الضخمة رخيصة للجميع.
✅ الحقيقة: فاتورة السحابة قد تُصبح كارثية دون تحسين. شركات ناشئة أفلست بسبب فواتير AWS شهرية تجاوزت المليون دولار من دون رقابة. تحسين التكلفة (FinOps) أصبح تخصصاً قائماً بذاته.
أين تلمس البيانات الضخمة أثرها في الحياة اليومية للمستخدم العربي؟
تتغلغل البيانات الضخمة في تفاصيل يومية دقيقة يغفلها كثيرون. تطبيقات التوصيل مثل هنقرستيشن وطلبات وجاهز تُحلل ملايين الطلبات لتحسين مسارات المندوبين، وتتنبأ بالوجبة المفضلة عند الإفطار في رمضان. تطبيقات ملاحة كخرائط غوغل وويز تُعالج بيانات حركة ملايين المستخدمين لتحديث حالة الطرق في الرياض وجدة والدمام لحظياً.
في الصناعة، تعتمد شركة أرامكو السعودية على منصة تحليل بيانات ضخمة تُدير آلاف الآبار النفطية عبر مستشعرات إنترنت الأشياء، مما يُتيح الصيانة التنبؤية (Predictive Maintenance) وتقليل التوقفات المكلفة. اعتمدت هيئة السياحة السعودية على تحليلات البيانات لفهم أنماط السياح وتخصيص التجارب في مواقع مثل العُلا.
في القطاع الزراعي، تُساعد البيانات الضخمة المزارعين في وادي الأحساء وحائل على تحسين استهلاك المياه عبر مستشعرات رطوبة التربة وبيانات الأقمار الصناعية. يُعالج نظام “زراعتنا” في وزارة البيئة والمياه والزراعة السعودية بيانات ضخمة لدعم قرارات الأمن الغذائي.
⚠️ تنويه: بعض التطبيقات المذكورة، خاصة في مجالات الطب الشخصي والذكاء الاصطناعي التوليدي، لا تزال في مراحل بحثية أو تطويرية. النتائج قد تتغير مع تقدم التقنية، والاعتماد التجاري الكامل يحتاج مزيداً من الدراسات والتحقق التنظيمي.
اقرأ أيضاً:
- الاقتصاد السعودي: كيف تحول من الاعتماد على النفط إلى التنويع الشامل؟
- تطبيقات الذكاء الاصطناعي في التعليم: الفرص والتحديات
مدخل الطالب والمبتدئ إلى عالم البيانات الضخمة: من أين ينطلق المسار؟
المفاهيم الأساسية التي يجب إتقانها قبل التعمق:
- الأساسيات الرياضية: الإحصاء الوصفي والاستدلالي، الاحتمالات، الجبر الخطي (المصفوفات والمتجهات)، وأساسيات التفاضل والتكامل. هذه الأدوات تُشكّل اللغة الأم لعلم البيانات.
- البرمجة: إتقان بايثون (Python) كلغة أولى لسهولة تعلمها وثراء مكتباتها (NumPy, Pandas, Scikit-learn)، ثم SQL للتعامل مع قواعد البيانات، وأخيراً Scala أو Java للعمل مع سبارك وهادوب.
- قواعد البيانات: فهم النظرية العلائقية أولاً (Normalization, ACID)، ثم الانتقال إلى مفاهيم NoSQL ونظرية CAP.
- أنظمة التشغيل والشبكات: أساسيات لينكس، مفاهيم الحوسبة الموزعة، وبروتوكولات الشبكات.
الأخطاء الشائعة عند المبتدئين:
- القفز إلى الأدوات قبل إتقان المبادئ: كثيرون يبدأون بتعلم TensorFlow قبل فهم الانحدار الخطي، مما يجعلهم يستخدمون الأدوات بشكل أعمى.
- إهمال هندسة البيانات: التركيز على النماذج الفاخرة مع تجاهل تنظيف البيانات وهندسة الخصائص، رغم أن الأخيرة تُحدد 70% من نجاح المشروع.
- الاعتقاد بأن حجم البيانات يعوّض ضعف المنهجية: المبتدئون يظنون أن جمع بيانات أكثر سيحل المشكلات، بينما الحل غالباً في فهم أعمق للمجال.
- إهمال التصور البياني: التركيز على الأرقام دون تعلم فن سرد القصص بالبيانات (Data Storytelling)، وهي مهارة تُميز عالم البيانات الناجح.
اقرأ أيضاً:
- الإحصاء البايزي: كيف يُغيّر طريقة تفكيرنا في البيانات والاحتمالات؟
- تعلم الرياضيات: التحديات، الاستراتيجيات، والموارد
كيف تتشابك البيانات الضخمة مع فروع العلم الأخرى؟
ترتبط البيانات الضخمة برباط عضوي مع الرياضيات التطبيقية (Applied Mathematics)، وتحديداً نظرية الاحتمالات (Probability Theory) والإحصاء البايزي (Bayesian Statistics)، إذ تعتمد جميع خوارزميات التعلم الآلي على نماذج احتمالية لاستنتاج الأنماط من العينات.
كما تتشابك مع علم الأعصاب الحاسوبي (Computational Neuroscience)، فالشبكات العصبية الاصطناعية استُلهمت من بنية الدماغ البشري، رغم أن نماذج التعلم العميق الحديثة تجاوزت التشبيه البيولوجي البسيط.
في الفيزياء، تُشكّل البيانات الضخمة أداة لا غنى عنها في فيزياء الجسيمات (Particle Physics)، إذ تحتاج تجارب مصادم LHC في سيرن إلى تحليل بيتابايتات من بيانات التصادمات لاكتشاف جسيمات مثل بوزون هيغز. كما تُغذي علم الفلك الرصدي (Observational Astronomy) في مسوحات السماء الرقمية.
في علم الأحياء الحاسوبي (Computational Biology)، مكّنت البيانات الضخمة من فك تسلسل الحمض النووي (DNA Sequencing) بسرعة قياسية، وأتاحت تطوير علم البروتيوميات (Proteomics) وعلم الأيض (Metabolomics).
وتتقاطع مع الاقتصاد الكلي (Econometrics) عبر تحليلات السوق الضخمة، ومع علم الاجتماع الحاسوبي (Computational Sociology) في دراسة الشبكات الاجتماعية.
اقرأ أيضاً:
- الهندسة الوراثية: ما هي وكيف تُغيّر مستقبل البشرية؟
- البيولوجيا الجزيئية: ما الذي يجعلها أساس فهم الحياة؟
خطة عملية متدرجة لبناء مهارات البيانات الضخمة
- إتقان أساسيات بايثون خلال 3 أشهر: التركيز على مكتبات NumPy وPandas وMatplotlib عبر منصات كـ Coursera وedX.
- دراسة قواعد البيانات SQL: تنفيذ استعلامات على قواعد بيانات حقيقية كـ PostgreSQL، مع فهم مفاهيم الفهرسة والتحسين.
- الغوص في الإحصاء التطبيقي: كتاب “Statistical Learning” من جامعة ستانفورد المتاح مجاناً يُعد مرجعاً ممتازاً.
- تعلم إطار عمل واحد للبيانات الضخمة: البدء بأباتشي سبارك عبر واجهة PySpark، ثم التوسع لهادوب.
- بناء مشاريع عملية: تحليل مجموعات بيانات مفتوحة من Kaggle أو بيانات حكومية سعودية من بوابة البيانات المفتوحة.
- الحصول على شهادات معتمدة: شهادات AWS Certified Data Analytics، أو Google Professional Data Engineer، أو Databricks Certified Associate.
- المشاركة في مجتمعات المصادر المفتوحة: المساهمة في مشاريع GitHub، وحضور مؤتمرات كـ Strata Data Conference وSpark Summit.
اقرأ أيضاً:
- الدليل الشامل إلى النماذج مفتوحة المصدر (Open Source Models): كيف تقود ثورة الذكاء الاصطناعي؟
- تخصصات الأمن السيبراني الرئيسية: المسارات الوظيفية والمهارات المطلوبة
توصية علمية موسوعية للقارئ العربي المهتم بالبيانات الضخمة
- البدء بالأساسيات الرياضية قبل الأدوات: فهم الاحتمالات والجبر الخطي يُشكّل حصانة معرفية تجعل تعلم أي إطار عمل مستقبلي أسهل بمراحل، لأن جوهر الخوارزميات ثابت بينما الأدوات متغيرة.
- التركيز على هندسة البيانات لا علم البيانات فقط: سوق العمل الحالي يشهد فجوة أكبر في مهندسي البيانات (Data Engineers) مقارنة بعلماء البيانات، إذ يحتاج كل نموذج تعلم آلي إلى بنية تحتية قوية تسبقه.
- متابعة أبحاث المعامل الكبرى: أوراق غوغل ومايكروسوفت وميتا البحثية على arXiv.org تكشف الاتجاهات قبل ظهورها تجارياً بسنوات، وهذه ميزة إستراتيجية للباحث الطموح.
- إتقان مفاهيم الأمن السيبراني للبيانات: مع تصاعد أنظمة حماية البيانات كنظام PDPL السعودي وGDPR الأوروبي، أصبحت معرفة قوانين حماية البيانات مهارة لا تقل أهمية عن المهارات التقنية.
- اختيار قطاع تخصصي (Vertical): الخبرة العميقة في قطاع محدد كالطب أو المالية أو الطاقة تُميّز عالم البيانات عن أقرانه، لأن فهم المجال يُغذي جودة النماذج.
- بناء مهارات التواصل وسرد القصص: أفضل التحليلات تفشل إذا لم يُحسن صاحبها إيصالها لصانعي القرار غير التقنيين. مهارات العرض والكتابة العلمية استثمار حاسم.
- مواكبة الحوسبة الكمومية مبكراً: رغم أنها لا تزال في مراحلها التأسيسية، فإن تعلم أساسياتها اليوم عبر منصات مثل IBM Quantum يمنح ميزة تنافسية للعقد القادم.
ومضة تربط النظرية بالواقع: كل مرة يستخدم فيها فرد من أفراد المجتمع تطبيق أبشر أو توكلنا أو نظام الدفع الرقمي مدى، فإنه يُساهم بتغذية منظومات بيانات ضخمة تُشكّل العصب الرقمي للتحول الوطني السعودي 2030، وتُغذي قرارات هيئة الحكومة الرقمية في تحسين الخدمات.
إن استشراف مستقبل البيانات الضخمة يتطلب استيعاب حقيقة مفصلية: لقد أصبحت البيانات “النفط الجديد” للاقتصاد العالمي، بل تجاوزت النفط في بعض أوجه القياس. فبينما تُنضب حقول النفط، تتضاعف البيانات باستمرار وتُنتج قيمة متزايدة مع كل استخدام. الشركات التي تحولت من ثقافة التخمين إلى ثقافة القرارات القائمة على الحقيقة الرقمية باتت تُهيمن على مشهد الابتكار العالمي. وتلوح في الأفق تساؤلات معمارية أعمق: هل ستُطلق الحوسبة الكمومية موجة ثالثة من الثورة البياناتية تُعيد تعريف حدود ما يُمكن معرفته وحسابه في الكون الرقمي؟
يستند هذا المقال إلى أحدث المعايير والدلائل الإرشادية الرسمية المعتمدة في مجال البيانات وأمن المعلومات:
- نظام حماية البيانات الشخصية (PDPL) — الهيئة السعودية للبيانات والذكاء الاصطناعي (SDAIA)
- اللائحة العامة لحماية البيانات (GDPR) — الاتحاد الأوروبي
- معايير NIST لإطار عمل الخصوصية والأمن السيبراني — المعهد الوطني الأمريكي للمعايير والتقنية
- معايير IEEE الهندسية لأنظمة البيانات الموزعة — معهد مهندسي الكهرباء والإلكترونيات
- تقارير Gartner وIDC المرجعية لتصنيف نضج تقنيات البيانات الضخمة
- معيار ISO/IEC 27001 لإدارة أمن المعلومات
المصادر والمراجع
- Reinsel, D., Gantz, J., & Rydning, J. (2022). Worldwide IDC Global DataSphere Forecast. IDC White Paper. https://www.idc.com/
تقرير يُقدّم أحدث توقعات نمو حجم البيانات العالمي حتى 2025. - Dean, J., & Ghemawat, S. (2004). MapReduce: Simplified Data Processing on Large Clusters. Google Research. https://research.google/pubs/mapreduce-simplified-data-processing-on-large-clusters/
الورقة البحثية التأسيسية التي ألهمت تطوير هادوب. - Zaharia, M., et al. (2016). Apache Spark: A Unified Engine for Big Data Processing. Communications of the ACM, 59(11). https://doi.org/10.1145/2934664
دراسة تشرح معمارية سبارك وتفوقه على هادوب. - IBM Security. (2024). Cost of a Data Breach Report 2024. IBM. https://www.ibm.com/reports/data-breach
تقرير سنوي يرصد تكاليف اختراقات البيانات عالمياً. - Rocher, L., Hendrickx, J. M., & de Montjoye, Y. A. (2019). Estimating the success of re-identifications in incomplete datasets. Nature Communications, 10(1). https://doi.org/10.1038/s41467-019-10933-3
دراسة تُثبت هشاشة تجهيل البيانات وإمكانية إعادة تعريف الأفراد. - NASA. (2023). James Webb Space Telescope Data Volume Analysis. NASA Goddard Space Flight Center. https://www.nasa.gov/mission_pages/webb/main/index.html
معلومات عن حجم البيانات المُنتجة من تلسكوب جيمس ويب. - CERN. (2023). Worldwide LHC Computing Grid Annual Report. CERN. https://home.cern/science/computing/grid
تقرير عن معالجة بيانات مصادم الهادرونات الكبير. - Brynjolfsson, E., & McElheran, K. (2016). The Rapid Adoption of Data-Driven Decision-Making. MIT Sloan Research. https://mitsloan.mit.edu/
دراسة MIT حول أثر القرارات القائمة على البيانات في الإنتاجية. - Strubell, E., Ganesh, A., & McCallum, A. (2019). Energy and Policy Considerations for Deep Learning in NLP. University of Massachusetts Amherst. https://arxiv.org/abs/1906.02243
دراسة أثر تدريب نماذج الذكاء الاصطناعي على البيئة. - Saudi Data & AI Authority (SDAIA). (2023). Personal Data Protection Law Implementing Regulations. https://sdaia.gov.sa/
نظام حماية البيانات الشخصية السعودي ولوائحه التنفيذية.
قراءات إضافية ومصادر للتوسع
- كتاب “Designing Data-Intensive Applications” لمؤلفه Martin Kleppmann (O’Reilly, 2017)
لماذا نقترح قراءته: يُعد الكتاب المرجعي الأشمل لفهم البنى الهندسية للأنظمة الموزعة الحديثة، ويشرح بعمق نظرية CAP ونماذج الاتساق في قواعد البيانات الموزعة. - ورقة مراجعة “A Survey on Data Collection for Machine Learning” في IEEE Transactions on Knowledge and Data Engineering (2021)
لماذا نقترح قراءته: مراجعة شاملة لتقنيات جمع البيانات الحديثة للتعلم الآلي، مع تحليل نقدي للتحديات والفرص البحثية المفتوحة. - كتاب “The Data Warehouse Toolkit” لمؤلفه Ralph Kimball (Wiley, 3rd Edition)
لماذا نقترح قراءته: المرجع الكلاسيكي في تصميم مستودعات البيانات، يُقدم منهجية Kimball المعتمدة عالمياً في نمذجة البيانات الأبعادية (Dimensional Modeling).
فهل ستشهد العقود القادمة انتقالاً من عصر البيانات الضخمة إلى عصر “البيانات الذكية” (Smart Data) التي تحمل معناها المُشفّر داخلها منذ لحظة توليدها؟
موقع خلية لا يتحمل أي مسؤولية قانونية أو تقنية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين.
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات