علم البيانات: الركيزة العلمية لقيادة الذكاء الاصطناعي وصناعة القرار
هل يمكن للأرقام أن تحكم العالم؟ قراءة في العلم الذي أعاد تعريف المعرفة

علم البيانات (Data Science) حقلٌ علميّ متعدد الاختصاصات يوظّف الأساليب الإحصائية والخوارزميات الحاسوبية والخبرة المجالية لاستخلاص المعرفة من البيانات المهيكلة وغير المهيكلة. تشير تقديرات شركة IDC إلى أن الحجم العالمي للبيانات المُنتَجة سيبلغ 181 زيتابايت بحلول عام 2025، ما يجعل هذا العلم ركيزةً حاسمة لصناعة القرار.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
- علم البيانات يجمع الرياضيات والبرمجة والخبرة المجالية لتحويل البيانات الخام إلى قرارات.
- الحجم العالمي للبيانات سيبلغ 181 زيتابايت بحلول 2025 وفق IDC.
- الطلب على علماء البيانات سينمو 35% حتى 2032 وفق مكتب إحصاءات العمل الأميركي.
- يختلف علم البيانات عن تحليل البيانات في أنه تنبؤي وتوجيهي لا وصفي فقط.
- دورة حياة المشروع تكرارية لا خطية، وتستهلك التنقية 80% من الوقت.
- الشبكات العصبية العميقة تعاني من معضلة الصندوق الأسود رغم دقتها العالية.
- تشخيص طبي بدقة تنافس الأطباء، وكشف احتيال بنكي في أجزاء من الثانية.
- أنظمة توصية تُدرّ أكثر من 35% من إيرادات منصات مثل Amazon وNetflix.
- 87% من مشاريع علم البيانات لا تصل لمرحلة الإنتاج الفعلي، غالباً لأسباب تنظيمية لا تقنية.
- تحيّز البيانات (Data Bias) قد يُنتج قرارات تمييزية خطيرة إن لم تُراجَع بعناية.
الثورة العلمية الموجهة بالبيانات
في مطلع عام 2012، وصفت مجلة Harvard Business Review مهنة عالم البيانات بأنها «أكثر المهن إثارة في القرن الحادي والعشرين»، ولم يكن ذلك التوصيف مبالغة صحفية بقدر ما كان قراءةً مبكرة لتحوّل عميق في بنية الاقتصاد المعرفي. لقد انتقلت البيانات من كونها سجلات محاسبية جامدة إلى مورد إستراتيجي يوازي في قيمته النفط الخام، مع فارق جوهري: البيانات لا تنضب، بل تتضاعف أُسّياً مع كل نقرة رقمية.
يقوم علم البيانات في جوهره على تقاطع ثلاثي بين الرياضيات التطبيقية، والبرمجة الحاسوبية، والخبرة المجالية (Domain Expertise). وهذا التقاطع هو ما يميّزه عن التخصصات المجاورة كتحليل البيانات (Data Analysis) الذي يميل إلى الطابع الوصفي، أو هندسة البيانات (Data Engineering) التي تعنى ببناء البنية التحتية. فبينما يصف المحلل «ما حدث»، يسعى عالم البيانات إلى التنبؤ بـ«ما سيحدث» ووصف «كيف نتصرف حياله».
ولعل الفارق الأعمق يكمن في المنهج: علم البيانات نظامٌ شمولي يبدأ من صياغة السؤال العلمي وينتهي بنشر النموذج التنبؤي في بيئة الإنتاج، مروراً بمراحل معقدة من التنقية والنمذجة والتحقق الإحصائي. إنه بنية علمية متكاملة، لا مجرد أداة تحليلية.
ومضة علمية: بحسب تقرير المنتدى الاقتصادي العالمي (World Economic Forum) لعام 2023، يُتوقع أن تنشأ 97 مليون وظيفة جديدة مرتبطة بعلم البيانات والذكاء الاصطناعي حول العالم بحلول 2025، مقابل تراجع 85 مليون وظيفة تقليدية.
الأركان العلمية الثلاثة التي يقوم عليها هذا التخصص
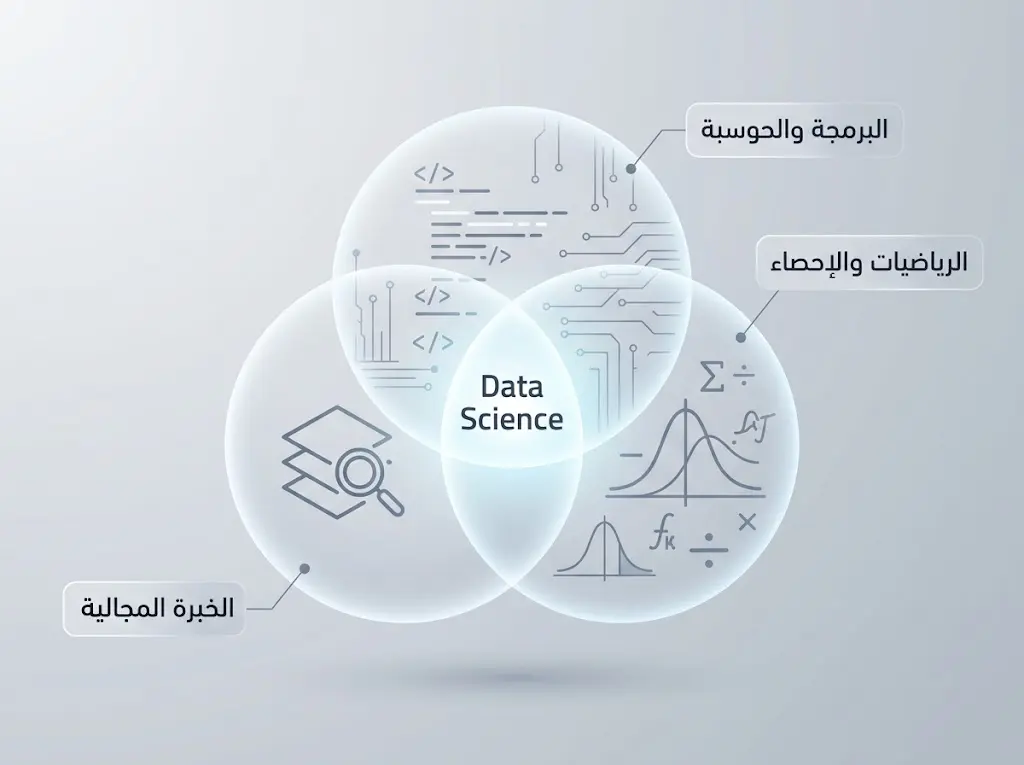
لا يمكن فهم علم البيانات دون تفكيك أعمدته البنائية الثلاثة. فهو ليس تخصصاً أحادياً، بل نسيج معرفي يتشكّل من تضافر حقول متباعدة ظاهرياً ومتكاملة جوهرياً.
الرياضيات والإحصاء تمثّل العمود الفقري النظري. فمن الجبر الخطي (Linear Algebra) الذي يحكم عمليات المصفوفات في الشبكات العصبية، إلى نظرية الاحتمالات (Probability Theory) التي تشكّل أساس الاستدلال البايزي (Bayesian Inference)، تتحكم الرياضيات في كل خطوة نمذجة. الاستدلال الإحصائي (Statistical Inference) هو ما يميّز الاستنتاج العلمي من التخمين العشوائي، إذ يوفر أدوات مثل اختبار الفرضيات (Hypothesis Testing) وفواصل الثقة (Confidence Intervals) لقياس اليقين في النتائج.
البرمجة والحوسبة تمنح هذه النظريات القدرة على التنفيذ الفعلي. لا يكفي أن يعرف عالم البيانات معادلة الانحدار الخطي، بل يجب أن يترجمها إلى شيفرة قادرة على معالجة ملايين السجلات. لغتا Python وR تهيمنان على هذا المجال، إلى جانب لغات الاستعلام مثل SQL. كما تفرض هياكل البيانات (Data Structures) وخوارزميات المعالجة المتوازية نفسها بقوة عند التعامل مع البيانات الضخمة (Big Data).
الخبرة المجالية (Domain Knowledge) تُعَدُّ الركن المهمَل غالباً، لكنها الأكثر حسماً. فنموذج تنبؤ بالسكري لا ينفع دون فهم فيزيولوجي لآلية إفراز الأنسولين، وتحليل سلوك المستهلك في السوق السعودية يستلزم إدراكاً للأنماط الثقافية والموسمية كرمضان ومواسم التخفيضات. وإن غياب هذا البُعد يُنتج نماذج دقيقة إحصائياً، لكنها فارغة عملياً.
صندوق الاقتباس العلمي: أشار تقرير معهد ماساتشوستس للتكنولوجيا (MIT Sloan Management Review) عام 2023 إلى أن 87% من مشاريع علم البيانات لا تصل إلى مرحلة الإنتاج الفعلي، والسبب الأول ليس تقنياً بل يتعلق بضعف الربط بين الفريق التقني والسياق التجاري للمؤسسة.
اقرأ أيضاً:
- علم الإحصاء: الأدوات، المنهجيات، ودوره في صنع القرار
- الإحصاء الاستدلالي: الاستنتاج من العينات إلى السكان
دورة حياة علم البيانات: من السؤال إلى القرار
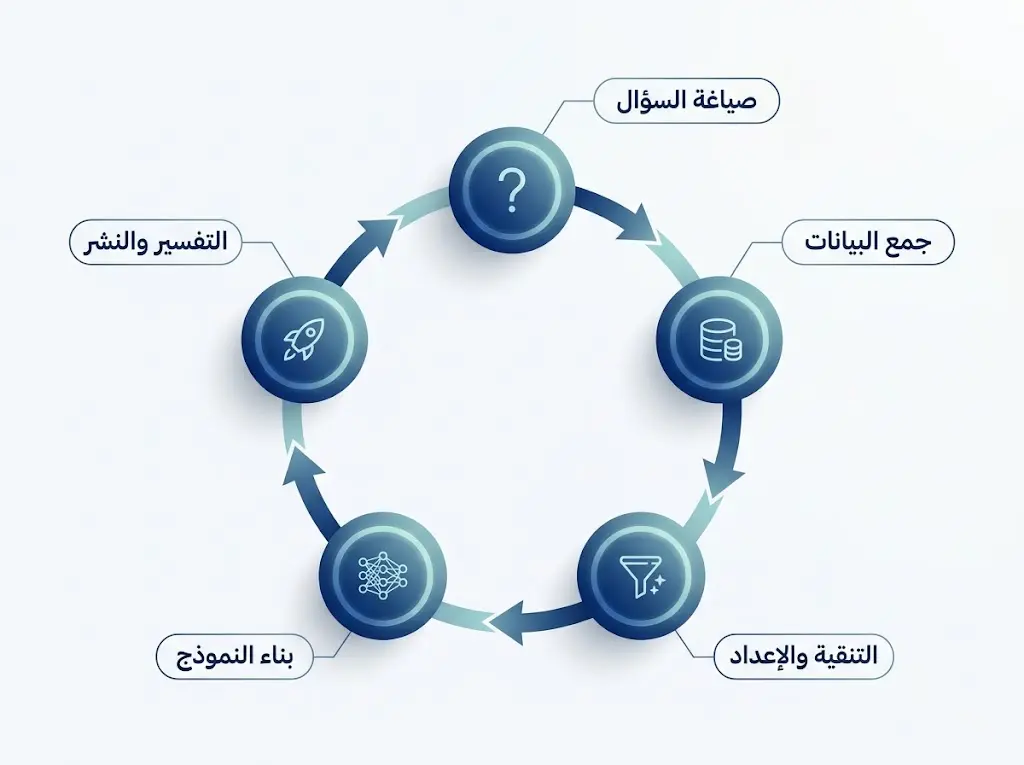
دورة حياة علم البيانات (Data Science Lifecycle) ليست مساراً خطياً، بل حلقة تكرارية يعود فيها الباحث مراراً إلى الخلف لتصحيح الفرضيات وإعادة تشكيل النماذج. تبدأ الحلقة بصياغة السؤال، وتنتهي بنشر الحل، لكنها لا تنتهي فعلياً أبداً.
صياغة السؤال العلمي: تنطلق كل رحلة تحليلية من سؤال دقيق قابل للقياس. سؤال مثل «كيف نزيد المبيعات؟» غامضٌ عديم الجدوى، بينما «ما احتمالية إلغاء العميل لاشتراكه خلال الأشهر الثلاثة القادمة بناءً على سلوكه الرقمي؟» سؤال قابل للنمذجة. جمع البيانات واستكشافها: تلي ذلك مرحلة الحصول على البيانات من مصادرها المتنوعة، ثم إخضاعها للتحليل الاستكشافي (Exploratory Data Analysis – EDA) لفهم توزيعاتها الإحصائية وكشف الأنماط الأولية. التنقية والإعداد: تستهلك هذه المرحلة نحو 80% من وقت عالم البيانات وفق تقديرات شركة CrowdFlower، وتشمل معالجة القيم المفقودة، وترميز المتغيرات الفئوية، وتطبيع البيانات، والتعامل مع القيم الشاذة (Outliers). هذه المرحلة تتقاطع مباشرة مع هندسة البيانات التي تبني الأنابيب (Pipelines) الناقلة للبيانات من مصادرها إلى بيئة التحليل.
بعد اكتمال الإعداد، تأتي مرحلة بناء النماذج التنبؤية، إذ يختار عالم البيانات الخوارزمية المناسبة لطبيعة المشكلة: انحداراً كان أم تصنيفاً أم تجميعاً. ثم يجري تدريب النموذج على جزء من البيانات (Training Set) واختباره على جزء منفصل (Test Set) لقياس أدائه بمقاييس دقيقة كالمصفوفة الالتباسية (Confusion Matrix) ومنحنى ROC. وأخيراً تأتي مرحلة التفسير والنشر، إذ يُحوَّل النموذج إلى واجهة برمجية (API) قابلة للاستخدام ضمن الأنظمة الحية، مع مراقبة مستمرة لأدائه لمنع ظاهرة انحراف النموذج (Model Drift).
نقطة تستحق الانتباه: كثير من النماذج الناجحة في مرحلة الاختبار تفشل عند النشر، والسبب هو تغيّر توزيع البيانات الواقعية عن البيانات التدريبية، وهي ظاهرة تُعرف بـ «انزياح المفهوم» (Concept Drift) وتستلزم إعادة تدريب دورية.
اقرأ أيضاً:
- التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
- الإحصاء البايزي: كيف يُغيّر طريقة تفكيرنا في البيانات والاحتمالات؟
ما الفرق بين علم البيانات وتحليل البيانات وتنقيب البيانات؟
يشيع الخلط بين هذه المصطلحات الثلاثة، وإن التمييز بينها ضروري لفهم البنية المعرفية للحقل. تحليل البيانات (Data Analysis) يميل إلى الطابع الوصفي والتشخيصي؛ يجيب عن أسئلة «ماذا حدث؟» و«لماذا حدث؟» باستخدام أدوات مثل جداول Excel المتقدمة ولوحات المعلومات (Dashboards). أما علم البيانات فيتجاوز ذلك إلى الأسئلة التنبؤية والتوجيهية: «ماذا سيحدث؟» و«ما الذي ينبغي فعله؟».
تنقيب البيانات (Data Mining) يُعَدُّ حقلاً جزئياً ضمن علم البيانات، يركّز على اكتشاف الأنماط المخفية والعلاقات غير الواضحة في مجموعات البيانات الضخمة، باستخدام تقنيات مثل قواعد الترابط (Association Rules) وخوارزمية Apriori الشهيرة في تحليل سلة المشتريات. بينما تعمل هندسة البيانات (Data Engineering) خلف الكواليس، إذ تبني البنية التحتية لتخزين البيانات ونقلها ومعالجتها، بدءاً من قواعد البيانات العلائقية (Relational Databases) وصولاً إلى بحيرات البيانات (Data Lakes) وأنظمة التدفق مثل Apache Kafka.
بالمقابل، يقف عالم البيانات في منتصف هذه المنظومة؛ يستهلك ما يبنيه مهندس البيانات، ويستخدم تقنيات تنقيب البيانات، ويتجاوز الوصف التقليدي إلى النمذجة الاحتمالية والتنبؤ. الفرق الجوهري يكمن في المخرج النهائي: المحلل يقدّم تقريراً، ومنقّب البيانات يكتشف نمطاً، وعالم البيانات يبني نظاماً ذكياً يتخذ قرارات ذاتية.
| وجه المقارنة | علم البيانات | تحليل البيانات | تنقيب البيانات | هندسة البيانات |
|---|---|---|---|---|
| السؤال الأساسي | ماذا سيحدث؟ وما الذي ينبغي فعله؟ | ماذا حدث؟ ولماذا حدث؟ | ما الأنماط المخفية في البيانات؟ | كيف تُنقل البيانات وتُخزَّن؟ |
| الطبيعة العلمية | تنبؤية وتوجيهية | وصفية وتشخيصية | استكشافية للأنماط | بنيوية تحتية |
| الأدوات الشائعة | Python، Scikit-learn، TensorFlow | Excel، لوحات المعلومات | قواعد الترابط، Apriori | Apache Kafka، Data Lakes |
| المخرج النهائي | نظام ذكي يتخذ قرارات ذاتية | تقرير تحليلي | نمط أو علاقة مكتشفة | بنية تحتية جاهزة للبيانات |
| علاقتها ببعضها | يستهلك مخرجات الحقول الثلاثة الأخرى | مرحلة أولى ضمن دورة التحليل | حقل جزئي ضمن علم البيانات | تعمل خلف الكواليس لتغذية الحقول الأخرى |
خوارزميات علم البيانات ونماذج التعلم الآلي
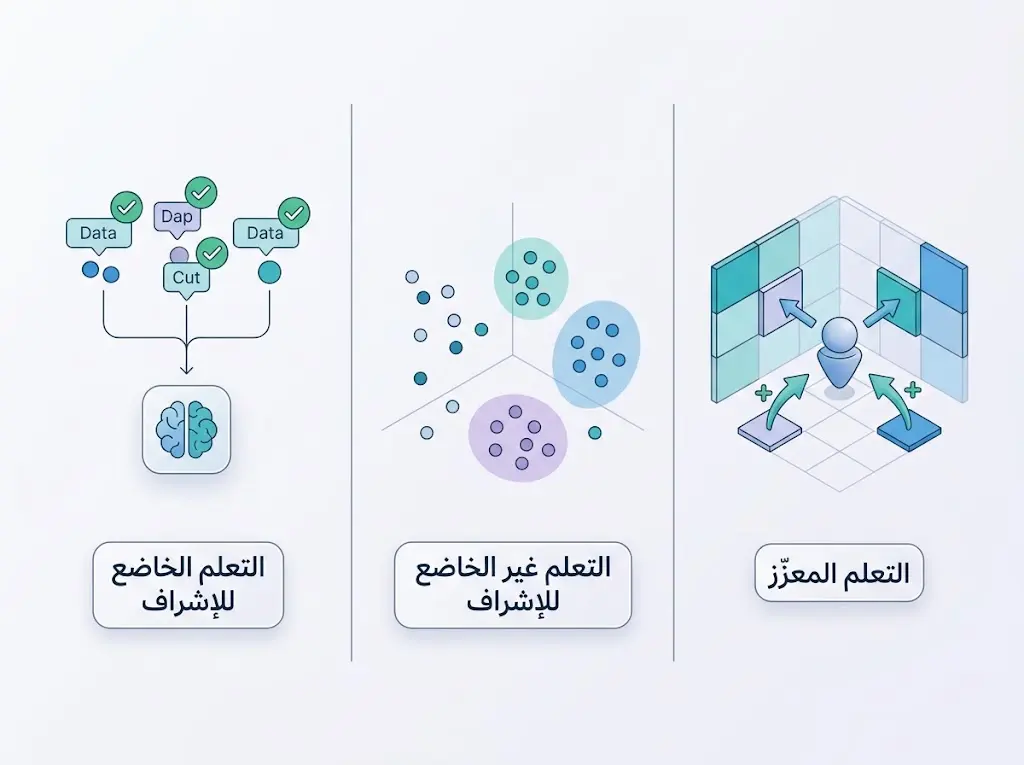
تشكّل الخوارزميات القلب النابض لعلم البيانات، وتنقسم عائلاتها الكبرى بحسب طبيعة المشكلة ونمط التعلم. التعلم الخاضع للإشراف (Supervised Learning) يعمل على بيانات موسومة (Labeled Data)، إذ يعرف النموذج الإجابة الصحيحة أثناء التدريب. ينقسم هذا النمط إلى مهمتين رئيستين: الانحدار (Regression) للتنبؤ بقيم عددية مستمرة كأسعار العقارات، والتصنيف (Classification) لتوزيع البيانات على فئات محددة كتشخيص المرض من عدمه. من أشهر خوارزمياته: الانحدار اللوجستي (Logistic Regression)، وأشجار القرار (Decision Trees)، والغابات العشوائية (Random Forests)، وآلات الدعم المتجهي (Support Vector Machines).
التعلم غير الخاضع للإشراف (Unsupervised Learning) يواجه بيانات دون إجابات مسبقة، ومهمته اكتشاف البنية الكامنة فيها. أبرز تطبيقاته التجميع (Clustering) عبر خوارزمية K-Means التي تُستخدم في تقسيم العملاء إلى شرائح تسويقية، وتقليل الأبعاد (Dimensionality Reduction) بتقنية تحليل المكونات الرئيسة (PCA). أما التعلم المعزّز (Reinforcement Learning) فيمثّل الجيل الأحدث، إذ يتعلم النموذج عبر التجربة والخطأ في بيئة تفاعلية، وهو ما مكّن AlphaGo من التفوق على أبطال العالم في لعبة الغو.
الشبكات العصبية العميقة (Deep Neural Networks) نقلت الحقل نقلة نوعية بعد عام 2012، مع فوز نموذج AlexNet في مسابقة ImageNet. تقوم فكرتها على محاكاة بنية مبسّطة للنظام العصبي البيولوجي عبر طبقات متتالية من الخلايا الحاسوبية، كلٌّ منها تستخرج ميزة أعقد من سابقتها. الشبكات الالتفافية (CNN) هيمنت على معالجة الصور، والشبكات المتكررة (RNN) ومحوّلات Transformer أحدثت ثورة في معالجة اللغة الطبيعية، وهو ما تجلّى في نماذج مثل GPT وBERT.
| السنة | الحدث العلمي | الباحث/الجهة | الأثر على الحقل | التصنيف |
|---|---|---|---|---|
| 1948 | تأسيس نظرية المعلومات | كلود شانون | أساس رياضي لقياس المعلومة وضغط البيانات | تأسيسية |
| 1986 | خوارزمية الانتشار العكسي | روملهارت، هينتون، ويليامز | مكّن تدريب الشبكات العصبية متعددة الطبقات | تأسيسية |
| 1989 | إثبات نظرية التقريب الشامل | جورج سايبنكو | أساس نظري لقدرة الشبكات على تقريب أي دالة | تأسيسية |
| 2012 | فوز AlexNet في مسابقة ImageNet | كريجيفسكي وزملاؤه | انطلاقة عصر التعلم العميق الحديث | نقطة تحوّل |
| 2017 | نشر ورقة Attention Is All You Need | فاسواني وزملاؤه (Google) | إرساء بنية المحوّلات Transformers | نقطة تحوّل |
| 2018 | تطبيق اللائحة الأوروبية GDPR | الاتحاد الأوروبي | تنظيم قانوني صارم لخصوصية البيانات | معاصرة |
اقرأ أيضاً:
- تعلم الآلة: كيف نبرمج الحواسيب لتفكر وتستنتج وتتخذ القرارات بنفسها
- التعلم العميق (Deep Learning): كيف تحاكي الآلات شبكات الدماغ البشري؟
لماذا تعجز النماذج الكلاسيكية عن تفسير قرارات الشبكات العميقة؟
من منظور التحليل العلمي المتقدم، يوضح المهندس عبد الله محمد جمال – خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية – أن التبسيط الشائع لخوارزميات التعلم العميق يميل إلى تصويرها على أنها «صناديق ذكية» تُدخَل لها البيانات فتُخرج قرارات دقيقة، إلا أن أحدث الأبحاث في مجال قابلية التفسير الميكانيكي (Mechanistic Interpretability) تكشف عن ديناميكية أعمق: الشبكات العصبية الحديثة تُشكّل داخلها ما يُسمى «تمثيلات كامنة» (Latent Representations) في فضاءات رياضية عالية الأبعاد، وهي تمثيلات لا يمكن للنماذج الإحصائية التقليدية كالانحدار الخطي التقاطها لأنها تفترض علاقات خطية بسيطة، بينما تعمل الشبكات على مبدأ التقريب الشامل (Universal Approximation Theorem) الذي أثبته سايبنكو عام 1989. هذا المستوى من الدقة ضروري لفهم لماذا قد يقدّم نموذج ذكي إجابة صحيحة لأسباب خاطئة، وهي ظاهرة توثقها أبحاث Anthropic وDeepMind الحديثة.
مفارقة حاسوبية مذهلة: نموذج GPT-4 يحتوي على ما يقارب 1.7 تريليون معامل قابل للتعديل، وإذا حاول إنسان أن يعدّها بمعدل رقم واحد في الثانية دون توقف، فسيستغرق ذلك أكثر من 53 ألف سنة.
أدوات علم البيانات ولغات البرمجة الأساسية
تشكّل منظومة الأدوات في علم البيانات نظاماً بيئياً متكاملاً تتصدره لغتان رئيستان. Python هيمنت في العقد الأخير بفضل تركيبها البسيط وغنى مكتباتها، إذ توفر NumPy الحسابات العددية الفعّالة عبر مصفوفات ND-arrays، وPandas تدير جداول البيانات بمرونة عالية، وScikit-learn تجمع خوارزميات التعلم الآلي الكلاسيكية في واجهة موحّدة. على الجانب الأعمق، تقدّم TensorFlow من Google وPyTorch من Meta بنى تحتية لبناء الشبكات العصبية العميقة وتدريبها على المعالجات الرسومية (GPUs).
لغة R تحتفظ بمكانتها القوية في الأوساط الأكاديمية والإحصائية، بفضل حزمها المتخصصة مثل ggplot2 للتصوير البياني، وdplyr لمعالجة البيانات، وcaret لبناء النماذج التنبؤية. الفارق الجوهري بين اللغتين يتلخص في التوجه: Python لغة برمجة عامة مالت نحو علم البيانات، بينما R وُلدت أصلاً للإحصاء وتحمل بصمته في تصميمها.
| وجه المقارنة | Python | R |
|---|---|---|
| النشأة والغرض الأصلي | لغة برمجة عامة اتجهت لاحقاً لعلم البيانات | لغة صُممت أصلاً للإحصاء والتحليل الرياضي |
| سهولة التعلم | تركيب بسيط وقريب من اللغة الطبيعية | منحنى تعلم أكثر حدة للمبتدئين |
| المكتبات الأساسية | NumPy، Pandas، Scikit-learn، TensorFlow | ggplot2، dplyr، caret |
| مجال الاستخدام الأقوى | التعلم العميق وبناء الأنظمة الإنتاجية | التحليل الإحصائي الأكاديمي والبحثي |
| التصوير البياني | Matplotlib، Seaborn، Plotly | ggplot2 (معيار ذهبي في التصور البياني) |
| سوق العمل والانتشار | الأوسع انتشاراً في الصناعة والشركات التقنية | الأقوى حضوراً في الأوساط الأكاديمية والبحثية |
أما بيئات العمل التفاعلية فتتصدرها Jupyter Notebook وGoogle Colab وDatabricks، إذ تتيح الجمع بين الشيفرة والنتائج والتوثيق في مستند واحد. للتصوير البياني، تتوفر أدوات كـ Tableau وPower BI للاستخدام التجاري، وMatplotlib وSeaborn وPlotly ضمن بيئة Python. وفي عالم البيانات الضخمة، تحكم Apache Spark وHadoop المعالجة الموزعة، بينما تدير خدمات سحابية كـ AWS SageMaker وGoogle Vertex AI وMicrosoft Azure ML دورة حياة النماذج بالكامل من التطوير إلى النشر.
اقرأ أيضاً:
- الحوسبة السحابية (Cloud Computing): المفهوم، النماذج، والتطبيقات
- الذكاء الاصطناعي: هندسة العقل الآلي من الخوارزميات الأولى إلى تكنولوجيا المستقبل
تطبيقات علم البيانات في الرعاية الصحية والعلوم والاقتصاد
مجالات استخدام علم البيانات تمتد اليوم لتغطي كل حقل معرفي تقريباً، وإن الأمثلة الواقعية توضح عمق التحوّل الذي أحدثه. في الرعاية الصحية، تُستخدم نماذج التعلم العميق لتشخيص سرطان الجلد بدقة تنافس أطباء الأمراض الجلدية، وفق دراسة نشرتها مجلة Nature عام 2017 بقيادة إستيفا وزملائه من جامعة ستانفورد. كما تُوظَّف الخوارزميات في تحليل صور الرنين المغناطيسي للكشف المبكر عن الأورام، وفي التنبؤ باحتمالية دخول مرضى الطوارئ إلى العناية المركزة.
في العلوم الطبيعية، اعتمدت وكالة ناسا (NASA) على علم البيانات في مهمة المسبار Perseverance لتحليل التربة المريخية، وفي تصفية الإشارات الصادرة عن التلسكوبات الراديوية لاكتشاف الكواكب الخارجية (Exoplanets). أما نمذجة المناخ في المركز الأوروبي للتنبؤات الجوية متوسطة المدى (ECMWF) فتعالج يومياً بيتابايتات من بيانات الأقمار الصناعية لإنتاج توقعات جوية عالية الدقة.
في الاقتصاد والأعمال، غيّر علم البيانات وجه التجارة الإلكترونية. أنظمة التوصية في Amazon وNetflix تُدرّ ما يزيد عن 35% من إيراداتهما وفق تصريحات رسمية، عبر خوارزميات الترشيح التعاوني (Collaborative Filtering). البنوك السعودية والخليجية بدأت اعتماد نماذج كشف الاحتيال في الوقت الحقيقي، إذ يتم فحص كل معاملة بطاقة ائتمانية عبر شبكات عصبية تحدد شذوذها في أجزاء من الثانية. حتى قطاع النفط، العصب الاقتصادي للمملكة العربية السعودية، بات يستخدم علم البيانات لتحسين إنتاجية الآبار عبر تحليل بيانات المستشعرات الجيوفيزيائية.
رقم لافت: بحسب تقرير McKinsey Global Institute لعام 2023، يمكن للذكاء الاصطناعي التوليدي المدعوم بعلم البيانات أن يضيف ما بين 2.6 و4.4 تريليون دولار سنوياً للاقتصاد العالمي، وهو ما يعادل الناتج المحلي الإجمالي للمملكة المتحدة بأكملها.
اقرأ أيضاً:
- تطبيقات الذكاء الاصطناعي في التعليم: الفرص والتحديات
- الذكاء الاصطناعي التوليدي: كيف يعمل وما تطبيقاته في 2026؟
التحديات الأخلاقية ومعضلة الصندوق الأسود
مع اتساع أثر علم البيانات، تتصاعد المعضلات الأخلاقية المرافقة له. تحيز البيانات (Data Bias) يُعَدُّ من أخطر هذه التحديات، إذ تعكس النماذج التحيّزات الموجودة في بيانات التدريب. أشهر الأمثلة قضية نظام COMPAS الأميركي للتنبؤ بمعدلات العودة إلى الجريمة، الذي كشفت دراسة صحيفة ProPublica عام 2016 تحيّزه ضد المتهمين من أصول إفريقية. كذلك سحبت Amazon نظاماً داخلياً للتوظيف عام 2018 بعد اكتشاف أنه يميّز ضد السير الذاتية النسائية، لأنه دُرّب على بيانات توظيف تاريخية يهيمن عليها الذكور.
مسألة الخصوصية تفرض نفسها بقوة في عصر البيانات الضخمة. اللائحة العامة لحماية البيانات الأوروبية (GDPR) التي دخلت حيز التنفيذ عام 2018، ونظام حماية البيانات الشخصية السعودي (PDPL) الصادر عام 2021، فرضا قيوداً صارمة على جمع البيانات ومعالجتها. الحق في النسيان (Right to be Forgotten) والحق في التفسير (Right to Explanation) أصبحا معياريَن قانونيَن يتحدّيان مباشرة النماذج المعقدة.
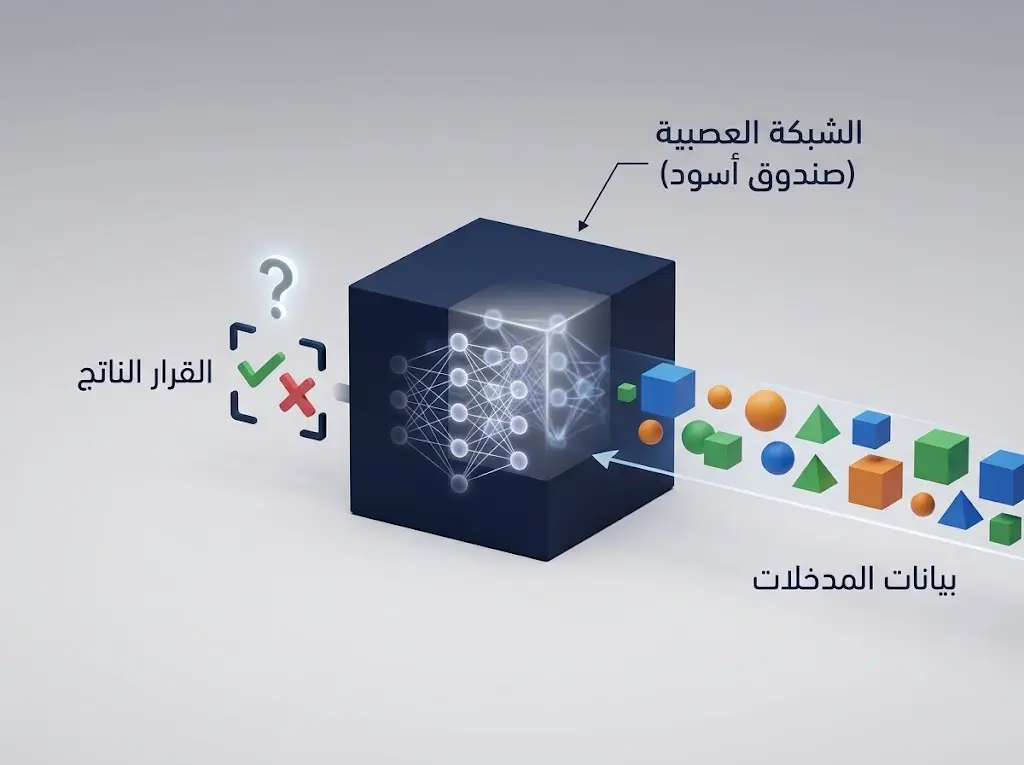
معضلة الصندوق الأسود (Black Box Problem) تمثّل تحدياً معرفياً عميقاً. الشبكات العصبية العميقة قد تحقق دقة استثنائية لكنها لا تفسّر قراراتها. هذا القصور دفع إلى ولادة حقل الذكاء الاصطناعي القابل للتفسير (Explainable AI – XAI)، الذي طوّر أدوات مثل LIME وSHAP لتقديم تفسيرات محلية لقرارات النماذج. مسألة التفسير ليست ترفاً أكاديمياً، بل ضرورة عملية في مجالات كالطب والقضاء والائتمان؛ إذ لا يكفي أن يكون القرار صحيحاً، بل يجب أن يكون مبرَّراً.
اقرأ أيضاً:
- كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
- الأمن السيبراني: المبادئ الأساسية وأهميته في العصر الرقمي
المختبر العلمي – للمهتمين بالتفاصيل الدقيقة
على المستوى الرياضي العميق، يعتمد تدريب الشبكات العصبية على خوارزمية الانتشار العكسي (Backpropagation) التي طوّرها روملهارت وهنتون وويليامز عام 1986. تقوم هذه الخوارزمية على حساب مشتقات دالة الخسارة (Loss Function) بالنسبة لكل معامل في الشبكة باستخدام قاعدة السلسلة (Chain Rule) في التفاضل، ثم تحديث المعاملات عبر خوارزمية الانحدار التدرجي (Gradient Descent).
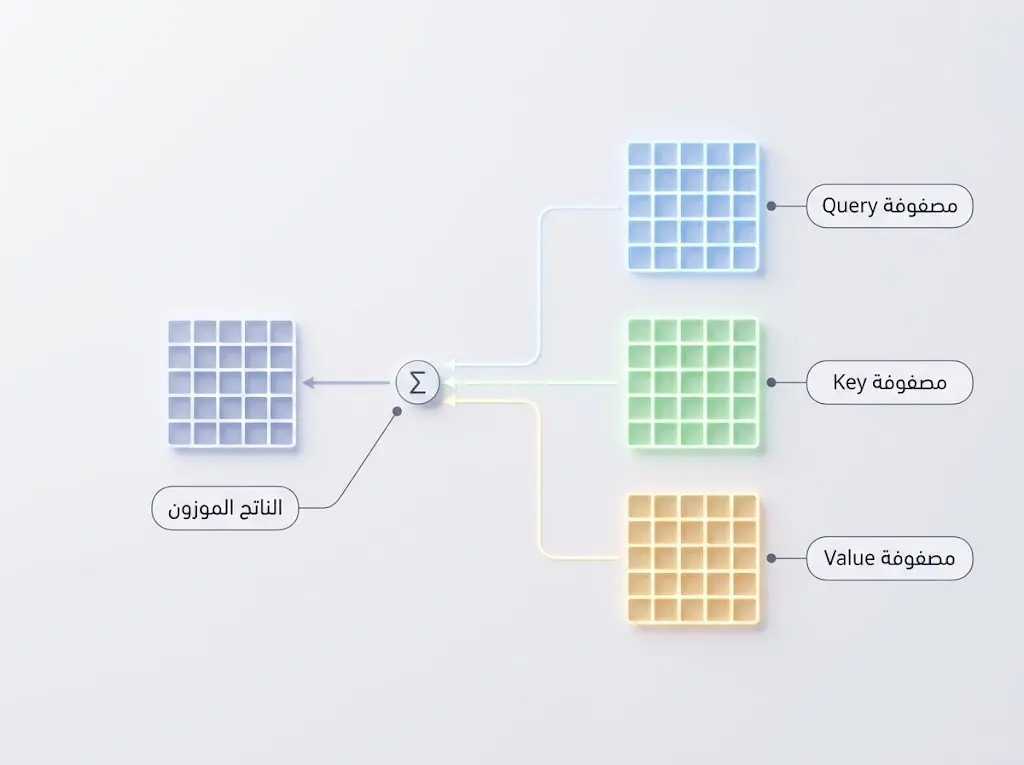
في نماذج المحوّلات (Transformers) التي تشكّل أساس النماذج اللغوية الكبرى، تُستخدم آلية الانتباه الذاتي (Self-Attention) التي طرحتها ورقة “Attention Is All You Need” الشهيرة عام 2017. تقوم هذه الآلية على حساب ثلاث مصفوفات: Query وKey وValue، ثم استخدام حاصل ضربها القياسي المقسوم على جذر البعد لحساب أوزان الانتباه.
من الناحية الاحتمالية، يبقى مبرهنة بايز (Bayes’ Theorem) الحجر الأساس للاستدلال الإحصائي في علم البيانات، وهي التي تربط الاحتمال الشرطي بالتحديث المعرفي عند وصول أدلة جديدة، وتُستخدم في مصنّفات Naive Bayes وشبكات بايز الاحتمالية.<div style=”direction:ltr; text-align:left; font-family:inherit; padding:10px; background:#f8f9fa; border-right:3px solid #2c7be5; margin:15px 0;”> <strong>Bayes’ Theorem:</strong> P(A|B) = [P(B|A) · P(A)] / P(B) </div>
اقرأ أيضاً:
- التفاضل والتكامل: كيف أصبح علم التغيير لغة الكون؟
- القيم الذاتية والمتجهات الذاتية: المفاهيم، الخصائص، والتطبيقات
خرافات شائعة وحقائق علمية حول علم البيانات
❌ الخرافة: علم البيانات هو مجرد إعادة تسمية للإحصاء التقليدي.
✅ الحقيقة: رغم أن الإحصاء ركن جوهري، إلا أن علم البيانات يدمج البرمجة الحاسوبية، وهندسة البيانات، والخبرة المجالية، والذكاء الاصطناعي في منظومة واحدة، وفق تعريف جمعية الحاسوب الأميركية (ACM).
❌ الخرافة: الذكاء الاصطناعي التوليدي سيقضي على مهنة عالم البيانات.
✅ الحقيقة: أشار تقرير مكتب إحصاءات العمل الأميركي (BLS) لعام 2024 إلى أن الطلب على علماء البيانات سينمو بنسبة 35% حتى 2032، أسرع بكثير من متوسط المهن الأخرى، لأن الذكاء الاصطناعي يحتاج إلى من يبنيه ويوجّهه.
❌ الخرافة: كلما زادت البيانات، تحسّن أداء النموذج تلقائياً.
✅ الحقيقة: جودة البيانات أهم من كميتها، وأثبتت دراسة منشورة في مجلة Communications of the ACM أن 20% من بيانات نظيفة تتفوق على 100% من بيانات ملوّثة في معظم المهام التنبؤية.
❌ الخرافة: النموذج ذو الدقة 99% نموذج ممتاز دائماً.
✅ الحقيقة: في البيانات غير المتوازنة كالكشف عن الاحتيال، قد يحقق نموذج ساذج دقة 99% بمجرد التنبؤ بعدم وجود احتيال دائماً، لذلك تُستخدم مقاييس أدق كـ Precision وRecall وF1-Score.
❌ الخرافة: علم البيانات يتطلب دكتوراه في الرياضيات.
✅ الحقيقة: كثير من علماء البيانات الناجحين قدموا من خلفيات متنوعة كالفيزياء والهندسة والاقتصاد، بل حتى من العلوم الإنسانية، ويكفي إتقان الأساسيات الإحصائية والبرمجية مع خبرة مجالية.
مدخل الطالب والهاوي إلى علم البيانات: من أين تبدأ الرحلة المعرفية؟
يقع كثير من المبتدئين في فخ القفز مباشرة إلى الشبكات العصبية العميقة قبل إتقان الأساسيات، فينتهي بهم المطاف إلى نسخ الأكواد دون فهم. المسار العلمي الصحيح يبدأ من الأسفل إلى الأعلى.
المفاهيم الأساسية التي يجب إتقانها: الإحصاء الوصفي والاستدلالي (المتوسط، الوسيط، الانحراف المعياري، التوزيعات الاحتمالية، اختبار t، تحليل التباين ANOVA). الجبر الخطي (المتجهات، المصفوفات، القيم الذاتية Eigenvalues). حساب التفاضل والتكامل (المشتقات الجزئية، التدرجات، قواعد التفاضل). البرمجة بلغة Python مع إتقان مكتبات Pandas وNumPy وMatplotlib. قواعد البيانات ولغة SQL للاستعلام والاسترجاع.
الأخطاء الشائعة لدى المبتدئين وتصحيحها: الوقوع في فرط التخصيص (Overfitting) عبر بناء نماذج معقدة على بيانات قليلة، والصواب استخدام التحقق المتقاطع (Cross-Validation) والتنظيم (Regularization). إهمال تنقية البيانات والقفز إلى النمذجة، وهو ما يؤدي إلى نتائج مضلّلة. الخلط بين الارتباط والسببية (Correlation vs Causation)، فالبيانات قد تظهر ارتباطاً قوياً بين متغيرين دون أن يكون بينهما علاقة سببية حقيقية. تجاهل تحليل الأخطاء (Error Analysis) بعد بناء النموذج، وهي المرحلة التي تكشف نقاط الضعف الحقيقية.
اقرأ أيضاً:
- الإحصاء التطبيقي: كيف يحول البيانات إلى قرارات واقعية؟
- مناهج البحث العلمي: ما أنواعها وكيف تختار المنهج المناسب
أين نلمس علم البيانات في حياتنا اليومية؟
تنويه علمي: بعض التطبيقات المذكورة أدناه لا تزال قيد التطوير المستمر، وقد تختلف مستويات النضج بين الدول والقطاعات. النتائج الفعلية تعتمد على جودة البيانات المتاحة والبنية التحتية التقنية.
في التجارة الإلكترونية: عندما يفتح متسوق تطبيق «نون» أو «أمازون» ويجد توصيات منتجات تشبه اهتماماته، فذلك نتاج مباشر لخوارزميات الترشيح التي تحلل سلوكه الشرائي وسلوك ملايين آخرين.
في التنقل الذكي: تطبيقات مثل Google Maps وأبشر للنقل تعتمد على نماذج تنبؤية بحركة المرور، تحلل ملايين نقاط GPS في الوقت الحقيقي لتقدير أفضل المسارات في مدن كالرياض وجدة.
في المساعدات الصوتية: خدمات مثل Siri وGoogle Assistant والمساعدات العربية الصاعدة تعتمد على نماذج معالجة اللغة الطبيعية المدربة على مليارات الكلمات.
في الرعاية الصحية: بدأت مستشفيات كبرى في السعودية والإمارات باعتماد أنظمة ذكية لتحليل صور الأشعة، إذ يعمل الذكاء الاصطناعي مساعداً للطبيب في الكشف المبكر عن أورام الثدي والرئة.
في الأمن السيبراني: كل معاملة بنكية إلكترونية تمر عبر نماذج كشف احتيال تحلّل مئات المتغيرات في ميلي ثانية لتحديد شرعيتها.
في الزراعة الذكية: المشاريع الزراعية في القصيم وحائل بدأت اعتماد أنظمة تحليل صور الأقمار الصناعية لرصد صحة المحاصيل وتحسين استهلاك المياه.
اقرأ أيضاً:
- الزراعة الذكية: التكنولوجيا والبيانات لتحسين المحاصيل
- ما هو إنترنت الأشياء: وكيف يُغيّر حياتنا ومستقبلنا؟
الخطة العملية لدخول عالم علم البيانات
- إتقان الأساسيات الرياضية: خصص 8-12 أسبوعاً لدراسة الإحصاء التطبيقي والجبر الخطي عبر منصات مثل Khan Academy وMIT OpenCourseWare.
- تعلّم لغة برمجية أساسية: ابدأ بـ Python وأكمل دورة شاملة لمكتباتها العلمية الأساسية (NumPy, Pandas, Matplotlib) خلال 6-8 أسابيع.
- اكتساب مهارة SQL: استثمر 3-4 أسابيع في إتقان استعلامات قواعد البيانات، فهي مهارة لا غنى عنها في أي وظيفة تحليلية.
- الغوص في تعلم الآلة: اتبع دورة أندرو نغ (Andrew Ng) الشهيرة على Coursera كنقطة انطلاق نظرية متينة، ثم انتقل إلى مكتبة Scikit-learn للتطبيق.
- بناء ملف مشاريع: أنجز 4-6 مشاريع كاملة من الصفر باستخدام بيانات حقيقية من Kaggle، ووثّقها على GitHub على نحو احترافي.
- التخصص التدريجي: بعد ستة أشهر من الأساسيات، اختر مساراً متخصصاً كمعالجة اللغة الطبيعية أو رؤية الحاسوب أو تحليل السلاسل الزمنية.
- المشاركة في المسابقات: انضم إلى منافسات Kaggle للتعلم من حلول المتقدمين، وطوّر شبكة علاقات مهنية عبر LinkedIn والمؤتمرات المتخصصة.
التوصية العلمية من موقعنا
- إعطاء الأولوية لفهم البيانات قبل الخوارزميات: المشاريع الناجحة تبدأ من فهم عميق للبيانات لا من اختيار خوارزمية معقدة. خصص وقتاً كافياً للتحليل الاستكشافي قبل النمذجة.
- تجاوز مفهوم «الأداة السحرية»: لا توجد خوارزمية أفضل من غيرها في جميع الحالات، وهو ما تؤكده مبرهنة «لا وجبة غداء مجانية» (No Free Lunch Theorem) في التعلم الآلي. الاختيار يعتمد على طبيعة المشكلة والبيانات.
- الاستثمار في مهارات التواصل العلمي: كثير من علماء البيانات يفشلون ليس لضعف تقني بل لعجزهم عن ترجمة نتائجهم إلى لغة يفهمها صانع القرار. تعلّم فن سرد البيانات (Data Storytelling).
- متابعة أبحاث arXiv بانتظام: الحقل يتطور بسرعة مذهلة، وقراءة ورقة بحثية أسبوعياً من قسم cs.LG أو stat.ML تحافظ على تحديث المعرفة.
- إتقان أدوات MLOps الحديثة: مستقبل المهنة يتجه نحو نشر النماذج وصيانتها لا مجرد بنائها. أدوات مثل MLflow وKubeflow وDocker تصبح إلزامية.
- تبني منهج الشك العلمي: كل نتيجة تحليلية تحتاج إلى تحقق مضاعف. الاعتماد الأعمى على مخرجات النموذج دون فهم آلياته الداخلية طريق مباشر إلى قرارات كارثية.
- بناء جسور بين علم البيانات والفلسفة الأخلاقية: الأسئلة القادمة ليست تقنية بحتة، بل تتعلق بالعدالة الخوارزمية والمساءلة، ويحتاج عالم البيانات المعاصر إلى وعي فلسفي بهذه المسائل.
كيف يرتبط علم البيانات بفروع العلم الأخرى؟
يشكّل علم البيانات نقطة تقاطع حقيقية بين تخصصات علمية متباعدة ظاهرياً، وإن فهم هذه الروابط يعمّق الرؤية التخصصية. الإحصاء الرياضي (Mathematical Statistics) هو الأب الشرعي للحقل، إذ يقدّم الأسس النظرية للاستدلال والاحتمال، من نظرية النهاية المركزية (Central Limit Theorem) إلى الاستدلال البايزي (Bayesian Inference). دون هذه الأسس، تصبح النماذج مجرد آلات إحصائية عمياء.
الفيزياء الإحصائية (Statistical Physics) تربط نفسها بعلم البيانات عبر مفاهيم كالإنتروبيا (Entropy) التي تُستخدم في نظرية المعلومات لشانون، وفي دوال الخسارة كـ Cross-Entropy. النماذج الشبكية العصبية استلهمت أصلاً من فيزياء المواد المكثفة (Condensed Matter Physics)، خصوصاً نماذج Ising للتفاعلات المغناطيسية.
علوم الأعصاب الحاسوبية (Computational Neuroscience) قدّمت الإلهام البيولوجي للشبكات العصبية الاصطناعية، رغم أن التشابه بين الاثنتين يبقى مجازياً أكثر منه حرفياً. علم اللغويات الحاسوبي (Computational Linguistics) ازدهر على نحو غير مسبوق مع صعود نماذج المحوّلات، إذ باتت نظريات تشومسكي حول القواعد التوليدية تُختبر عملياً عبر نماذج ضخمة تولّد نصوصاً بلغات متعددة.
نظرية المعلومات (Information Theory) التي أسسها كلود شانون عام 1948، توفّر الأدوات الرياضية لقياس المعلومة والحدّ من فقدها، وهي حاضرة في كل خوارزمية ضغط بيانات وكل نموذج تصنيف يستخدم دالة الإنتروبيا المتقاطعة.
صلة مباشرة بالحياة اليومية: كل توصية بمنتج على متجرك الرقمي المفضل، وكل ترجمة فورية لنص أجنبي عبر هاتفك، وكل تحذير من رسالة احتيالية في بريدك الإلكتروني، هي في جوهرها قرارات يتخذها نموذج علم بيانات دُرّب على ملايين الأمثلة السابقة.
اقرأ أيضاً:
- شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
- الحاسوب الكمي: الدليل العلمي الشامل لفهم تكنولوجيا المستقبل وتأثيرها المرعب على العالم
آفاق علم البيانات في عصر الذكاء الاصطناعي الفائق
يقف علم البيانات اليوم على مفترق طرق تاريخي. اتجاه الأتمتة عبر منصات AutoML مثل H2O.ai وGoogle AutoML يهدف إلى تبسيط بناء النماذج ليصبح متاحاً لغير المتخصصين، لكنه في المقابل يرفع سقف التوقعات من عالم البيانات ليركّز على المهام الأعقد كالتصميم المعماري للأنظمة وتفسير النماذج. الذكاء الاصطناعي التوليدي (Generative AI) فتح آفاقاً جديدة لتوليد بيانات اصطناعية (Synthetic Data) لتدريب النماذج في المجالات التي تفتقر إلى بيانات كافية كالطب النادر.
مستقبل الحقل يتشكّل حول عدة اتجاهات متسارعة: التعلم الموحّد (Federated Learning) الذي يسمح بتدريب النماذج على بيانات موزعة دون نقلها، الحوسبة الكمومية (Quantum Computing) التي تعد بحل مسائل تحسينية معقدة في زمن أُسّي أقل، والذكاء الاصطناعي المتجسّد (Embodied AI) الذي يدمج التعلم مع الأنظمة الروبوتية. الرؤية السعودية 2030 تولي هذا الحقل أهمية إستراتيجية، مع تأسيس الهيئة السعودية للبيانات والذكاء الاصطناعي (SDAIA) ومشاريع ضخمة كنيوم التي تعتمد جوهرياً على البيانات في تصميم مدن المستقبل.
يظل السؤال الأعمق مطروحاً: هل ستُفضي الطفرة الحالية في نماذج اللغة الكبرى إلى ذكاء اصطناعي عام (Artificial General Intelligence) قادر على منافسة الفهم البشري، أم أن ما نشهده اليوم مجرد قدرة إحصائية متقدمة على استحضار الأنماط دون فهم حقيقي؟ الإجابة عن هذا السؤال ستحدد ملامح العلاقة بين الإنسان والآلة في العقود القادمة، ويبقى علم البيانات هو اللغة التي ستُصاغ بها هذه الإجابة؛ فأي المسارات ستختار الحضارة الرقمية القادمة: أن يكون الإنسان سيّد البيانات، أم أن تصبح البيانات هي السيّد الجديد؟
اقرأ أيضاً:
- الثورة الصناعية الرابعة: الدليل العلمي الشامل للتقنيات التي تعيد صياغة مستقبل البشرية
- النماذج مفتوحة المصدر (Open Source Models): كيف تقود ثورة الذكاء الاصطناعي؟
يستند هذا المقال إلى أحدث المعايير والدلائل الإرشادية الرسمية المعتمدة في مجالي علم البيانات وحوكمة الذكاء الاصطناعي:
- NIST AI Risk Management Framework (2023): إطار المعهد الوطني الأميركي للمعايير والتقنية لإدارة مخاطر أنظمة الذكاء الاصطناعي.
- IEEE Ethically Aligned Design: دلائل معهد المهندسين الكهربائيين والإلكترونيين لتصميم أنظمة ذكاء اصطناعي أخلاقية.
- ACM Code of Ethics: مدونة أخلاقيات جمعية الحاسوب الأميركية لممارسي علم البيانات والبرمجة.
- GDPR (اللائحة الأوروبية العامة لحماية البيانات، 2018): الإطار القانوني المرجعي لخصوصية البيانات عالمياً.
- نظام حماية البيانات الشخصية السعودي PDPL (2021): الإطار التنظيمي المحلي لحوكمة البيانات في المملكة.
- الإستراتيجية الوطنية للبيانات والذكاء الاصطناعي – SDAIA: الجهة السعودية المشرفة على تنظيم هذا القطاع.
المصادر والمراجع
- Provost, F., & Fawcett, T. (2013). Data Science for Business: What You Need to Know about Data Mining and Data-Analytic Thinking. O’Reilly Media. https://www.oreilly.com/library/view/data-science-for/9781449374273/
- كتاب مرجعي يشرح المبادئ الأساسية لعلم البيانات في السياق التجاري.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems. https://arxiv.org/abs/1706.03762
- الورقة التأسيسية لبنية المحوّلات التي غيّرت مسار معالجة اللغة الطبيعية.
- Esteva, A., et al. (2017). Dermatologist-level classification of skin cancer with deep neural networks. Nature, 542(7639), 115-118. https://doi.org/10.1038/nature21056
- دراسة تثبت قدرة الشبكات العصبية على تشخيص سرطان الجلد بدقة تنافس الأطباء.
- IDC. (2024). Global DataSphere Forecast, 2023-2027. International Data Corporation. https://www.idc.com/getdoc.jsp?containerId=IDC_P38353
- تقرير يقدّر النمو العالمي لحجم البيانات وأثره الاقتصادي.
- McKinsey Global Institute. (2023). The economic potential of generative AI: The next productivity frontier. https://www.mckinsey.com/capabilities/mckinsey-digital/our-insights/the-economic-potential-of-generative-ai-the-next-productivity-frontier
- تحليل شامل للأثر الاقتصادي المتوقع للذكاء الاصطناعي التوليدي.
- World Economic Forum. (2023). The Future of Jobs Report 2023. https://www.weforum.org/reports/the-future-of-jobs-report-2023/
- تقرير عن مستقبل الوظائف والتحولات المرتبطة بعلم البيانات والذكاء الاصطناعي.
- Rudin, C. (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence, 1(5), 206-215. https://doi.org/10.1038/s42256-019-0048-x
- دراسة تدعو إلى استخدام نماذج قابلة للتفسير في القرارات الحساسة.
- MIT Sloan Management Review. (2023). Expanding AI’s Impact With Organizational Learning. https://sloanreview.mit.edu/projects/expanding-ais-impact-with-organizational-learning/
- تقرير عن أسباب فشل مشاريع علم البيانات في الوصول إلى مرحلة الإنتاج.
- Bureau of Labor Statistics. (2024). Data Scientists: Occupational Outlook Handbook. U.S. Department of Labor. https://www.bls.gov/ooh/math/data-scientists.htm
- إحصائيات رسمية عن مستقبل مهنة علم البيانات في الولايات المتحدة.
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. https://www.deeplearningbook.org/
- المرجع الأشمل والأعمق في نظرية التعلم العميق ورياضياته.
- SDAIA. (2023). National Strategy for Data and AI. Saudi Data & AI Authority. https://sdaia.gov.sa/
- الإستراتيجية الوطنية السعودية للبيانات والذكاء الاصطناعي.
قراءات إضافية ومصادر للتوسع
- كتاب “The Elements of Statistical Learning” لهاستي وتيبشيراني وفريدمان
- لماذا نقترح قراءته؟ هذا الكتاب يُعَدُّ الإنجيل الرياضي للتعلم الإحصائي، ويقدّم أساساً نظرياً عميقاً لكل خوارزميات علم البيانات الكلاسيكية، وهو متاح مجاناً من موقع جامعة ستانفورد.
- ورقة “A Few Useful Things to Know About Machine Learning” لبيدرو دومينغوز
- لماذا نقترح قراءتها؟ ورقة موجزة لكنها تلخّص أهم الدروس العملية التي يستخلصها الباحثون بعد سنوات من العمل، وتكشف الفخاخ الشائعة التي يقع فيها المبتدئون في التعلم الآلي.
- كتاب “Human Compatible: AI and the Problem of Control” لستيوارت راسل
- لماذا نقترح قراءته؟ يقدّم أحد أبرز رواد الذكاء الاصطناعي رؤية فلسفية وعلمية لمستقبل العلاقة بين الإنسان والآلة، ويطرح أسئلة جوهرية حول تصميم أنظمة ذكية تخدم الأهداف البشرية دون أن تنقلب عليها.
موقع خلية لا يتحمل أي مسؤولية قانونية أو علمية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين.
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات