التعلم العميق (Deep Learning): كيف تحاكي الآلات شبكات الدماغ البشري؟
كيف أصبحت الخوارزميات العصبية المحرك الخفي لأذكى تقنيات العصر الحديث؟

التعلم العميق فرعٌ متقدم من تعلم الآلة يعتمد على شبكات عصبية اصطناعية متعددة الطبقات لاستخلاص أنماط معقدة من البيانات الخام دون تدخل بشري مباشر في هندسة السمات. تعالج نماذجه الحديثة مثل GPT-4 أكثر من 1.8 تريليون معامل رياضي، مما يمكّنها من توليد نصوص وصور وأصوات بدقة غير مسبوقة. يمثّل هذا الحقل نقطة التقاء الرياضيات التطبيقية وعلوم الحوسبة والإحصاء في بنية واحدة متكاملة.
أ. عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
د. بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات
د. معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
- التعلم العميق فرع من تعلم الآلة، الذي هو بدوره فرع من الذكاء الاصطناعي — علاقة تضمين هرمي لا ترادف.
- الشبكة العصبية العميقة تحتاج 3 طبقات مخفية كحد أدنى؛ كلما زادت الطبقات، ازدادت قدرة التجريد.
- كلمة “عميق” تشير إلى عمق المعمارية الحسابية — وليس إلى فلسفة أو وعي.
- مع البيانات الكبيرة (ملايين العينات)، يتفوق التعلم العميق تفوقاً ساحقاً على الخوارزميات الكلاسيكية.
- الرعاية الصحية: كشف سرطان الرئة بدقة 97.5% (Lancet Digital Health, 2023).
- بروتينات: AlphaFold حدّد بنية 200 مليون بروتين خلال شهور بدل عقود.
- اللغة العربية: نموذج AraBERT وFalcon (TII) خطوتان عربيتان رائدتان.
- قطاع النفط: تحليل البيانات السيزمية بتعلم عميق يوفر ملايين الدولارات في أرامكو.
- مشكلة الصندوق الأسود: لا يستطيع النموذج تفسير قراراته — عائق قانوني وأخلاقي حقيقي.
- تدريب GPT-4 استهلك طاقة تعادل 50 غيغاواط/ساعة — بصمة بيئية لا يُستهان بها.
- انحياز البيانات: خطأ التعرف على الوجوه للنساء ذوات البشرة الداكنة أعلى بـ 34 ضعفاً (MIT, 2018).
- التعلم العميق الحالي هو ذكاء ضيق — لا وعي، لا فهم دلالي، لا ذكاء عام.
في عام 2012، حقق نموذج AlexNet خفضاً مفاجئاً بنسبة 10% في معدل الخطأ ضمن مسابقة ImageNet الشهيرة للتعرف على الصور، وهو إنجاز أحدث صدمة في مجتمع الباحثين الذين اعتقدوا أن تلك العتبة تحتاج عقداً إضافياً على الأقل. لم يكن ذلك مجرد تحسين تقني عابر؛ بل كان اللحظة التي انتقل فيها التعلم العميق من المختبرات الأكاديمية إلى صدارة الصناعة التقنية العالمية. ومنذ تلك النقطة الفاصلة، تدفقت مليارات الدولارات من شركات مثل Google وMeta وOpenAI لتمويل أبحاث الشبكات العصبية الاصطناعية، فتحولت خوارزميات التعلم العميق من أداة بحثية محدودة إلى عمود فقري يدير محركات البحث، وأنظمة الترجمة الآلية، والمركبات ذاتية القيادة.
تشغيل هاتف ذكي في مدينة الرياض صيفاً وتوجيه كاميرته نحو لوحة مرورية مكتوبة بالعربية: في أقل من 200 ميلي ثانية، تمرّ صورة اللوحة عبر شبكة عصبية تلافيفية (Convolutional Neural Network) مدمجة في شريحة الهاتف. الطبقة الأولى تستخلص الحواف والخطوط الأساسية من وهج الشمس الحارقة. الطبقة الثانية تُجمّع تلك الحواف في أشكال هندسية تشبه الحروف. الطبقات الأعمق تُطابق تلك الأشكال مع قاموس بصري تعلّمته الشبكة من ملايين الصور سابقاً. النتيجة: نص عربي مقروء يظهر على الشاشة، رغم انعكاسات الضوء الشديد وزاوية التصوير غير المثالية. هذه العملية بأكملها تحدث دون أن يكتب أيّ مبرمج قاعدة واحدة تقول “الحرف ع يبدو هكذا”؛ فالشبكة اكتشفت ذلك بنفسها من البيانات.
التأصيل العلمي: ما المقصود بالتعلم العميق تحديداً؟
التعلم العميق (Deep Learning) ليس مصطلحاً تسويقياً حديثاً كما قد يتبادر إلى الذهن. جذوره تمتد إلى أربعينيات القرن العشرين حين اقترح وارن ماكالوك (Warren McCulloch) ووالتر بيتس (Walter Pitts) عام 1943 أول نموذج رياضي لعصبون اصطناعي. غير أن القفزة النوعية جاءت حين توفرت ثلاثة عوامل متزامنة: بيانات ضخمة متاحة عبر الإنترنت، ومعالجات رسومية (GPUs) قادرة على تنفيذ تريليونات العمليات الحسابية في الثانية، وخوارزميات محسّنة رياضياً مثل الانتشار الخلفي (Backpropagation).
من الناحية الصورية، يُعرَّف التعلم العميق بأنه منهجية حسابية تستخدم شبكات عصبية اصطناعية ذات ثلاث طبقات مخفية على الأقل لتحويل مدخلات خام (صور، نصوص، إشارات صوتية) إلى مخرجات ذات معنى (تصنيفات، تنبؤات، قرارات). كلمة “عميق” لا تشير إلى عمق فلسفي؛ بل إلى العمق المعماري المتمثل في عدد الطبقات المتراكبة التي تمرّ عبرها البيانات. كلما زاد عدد الطبقات، ازدادت قدرة النموذج على التقاط تجريدات (Abstractions) أكثر تعقيداً. الطبقة الأولى قد تتعرف على خطوط مستقيمة، بينما الطبقة العاشرة تستطيع تمييز وجه بشري كامل ضمن مشهد مزدحم.
فما الذي يميز هذا النهج عن البرمجة التقليدية؟ في البرمجة الكلاسيكية، يكتب المهندس قواعد صريحة: “إذا كانت درجة الحرارة أعلى من 50 مئوية، أطلق إنذاراً.” لكن في التعلم العميق، لا توجد قواعد مسبقة. النموذج يتلقى آلاف الأمثلة، ويكتشف القواعد بنفسه عبر ضبط ملايين المعاملات الرياضية الداخلية. هذه القدرة على الاكتشاف الذاتي للأنماط هي التي جعلت خوارزميات التعلم العميق تتفوق على الأنظمة التقليدية في مهام مثل التعرف على الكلام بنسبة تصل إلى 95% وفقاً لاختبارات أجرتها مختبرات مايكروسوفت للأبحاث عام 2017.
| وجه المقارنة | تعلم الآلة الكلاسيكي | التعلم العميق |
|---|---|---|
| هندسة السمات | يدوية — يستخرجها المهندس | تلقائية — تستخرجها الشبكة من البيانات الخام |
| حجم البيانات المثالي | أقل من 10,000 عينة — يتفوق فيها | ملايين العينات — الأداء يتحسن باستمرار |
| قابلية التفسير | مرتفعة نسبياً (قواعد واضحة في كثير من النماذج) | منخفضة — مشكلة الصندوق الأسود |
| نوع البيانات الأنسب | بيانات مهيكلة (جداول، أرقام، متغيرات) | بيانات غير مهيكلة (صور، صوت، نص) |
| متطلبات الحوسبة | منخفضة — يعمل على أجهزة عادية | مرتفعة جداً — يحتاج GPUs/TPUs متخصصة |
| عدد الطبقات | طبقة واحدة أو طبقتان في أغلب النماذج | 3 طبقات مخفية كحد أدنى — تصل إلى المئات |
| أمثلة على الخوارزميات | SVM، Random Forest، XGBoost، Logistic Regression | CNN، LSTM، Transformer، GAN، Diffusion Models |
| أداء النموذج مع زيادة البيانات | يصل إلى سقف ثابت ولا يتحسن بعده | يستمر في التحسن — لا يشبع من البيانات |
| البصمة الكربونية للتدريب | منخفضة جداً | مرتفعة جداً في النماذج الضخمة |
| نموذج بارز | XGBoost في مسابقات Kaggle | GPT-4، AlphaFold، Tesla FSD |
كيف يختلف الذكاء الاصطناعي عن تعلم الآلة والتعلم العميق؟
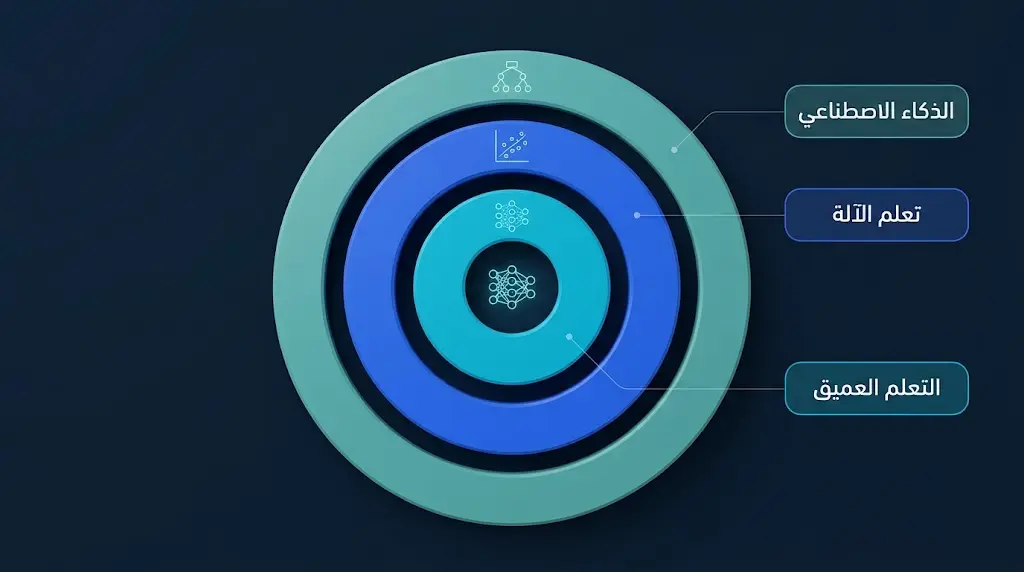
الخلط بين هذه المصطلحات الثلاثة شائع جداً بين أفراد المجتمع، بل وحتى في بعض المنشورات التقنية. لكن العلاقة بينها ليست علاقة ترادف؛ إنها علاقة تضمين هرمي، تُشبَّه ببنية الدمى الروسية المتداخلة (Matryoshka).
الذكاء الاصطناعي (Artificial Intelligence – AI) هو المظلة الأوسع. يشمل أي نظام حاسوبي قادر على محاكاة سلوك ذكي: من شجرة قرارات بسيطة (Decision Tree) في لعبة شطرنج إلى روبوت يتفاعل مع بيئته المادية. لقد صاغ جون مكارثي (John McCarthy) هذا المصطلح عام 1956 في مؤتمر دارتموث الشهير، وكان التعريف المبدئي فضفاضاً عمداً ليشمل طيفاً واسعاً من الأساليب.
تعلم الآلة (Machine Learning – ML) يقع داخل هذه المظلة. هو المجال الذي تتعلم فيه الخوارزميات من البيانات دون برمجة صريحة لكل حالة. يتضمن تقنيات كلاسيكية مثل آلات المتجهات الداعمة (Support Vector Machines)، والغابات العشوائية (Random Forests)، وخوارزميات التجميع (Clustering). هذه الأساليب تحتاج عادةً إلى هندسة سمات يدوية (Feature Engineering)؛ أي أن المهندس يستخرج الخصائص المهمة من البيانات قبل تقديمها للنموذج.
التعلم العميق يحتل النواة الأعمق من هذا الهرم. الفارق الجوهري: يتخلص من الحاجة إلى هندسة السمات اليدوية. الشبكات العصبية الاصطناعية العميقة تتعلم استخلاص السمات تلقائياً من البيانات الخام. هذا التمييز ليس نظرياً فحسب؛ بل له أثر اقتصادي ضخم. ففي مشروع تصنيف الصور الطبية مثلاً، قد يحتاج فريق تعلم الآلة الكلاسيكي إلى أسابيع لتصميم سمات يدوية (شكل الحواف، توزيع الألوان، نسيج الأنسجة)، بينما يكفي نموذج التعلم العميق أن يتلقى الصور الأصلية مباشرة ليكتشف تلك السمات ذاتياً.
مفارقة تقنية تستحق التأمل
ما هو الفرق بين تعلم الآلة والتعلم العميق من حيث الأداء الفعلي؟ الإجابة تتوقف على حجم البيانات المتاحة. مع بيانات قليلة (أقل من 10,000 عينة)، تتفوق خوارزميات تعلم الآلة الكلاسيكية غالباً. لكن حين تتجاوز البيانات ملايين العينات، تبدأ نماذج التعلم العميق بالتفوق الساحق؛ لأنها لا تشبع — أي أن أداءها يستمر بالتحسن مع زيادة البيانات، بينما يصل أداء النماذج الكلاسيكية إلى سقف ثابت.
اقرأ أيضاً: التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
التشريح الداخلي للشبكات العصبية الاصطناعية: من العقدة إلى القرار
بنية العقد وطبقات الإدخال والإخراج
الشبكة العصبية الاصطناعية (Artificial Neural Network – ANN) تتألف في أبسط صورها من ثلاثة مكونات: طبقة إدخال (Input Layer)، وطبقة إخراج (Output Layer)، وطبقات مخفية (Hidden Layers) بينهما. كل طبقة تتكون من وحدات حسابية تُسمى عقداً (Nodes) أو عصبونات اصطناعية (Artificial Neurons).
طبقة الإدخال تستقبل البيانات الخام. إذا كانت المهمة هي تصنيف صورة بأبعاد 28×28 بكسل (كصور قاعدة MNIST للأرقام المكتوبة يدوياً)، فإن طبقة الإدخال تحتوي على 784 عقدة — واحدة لكل بكسل. كل عقدة تحمل قيمة رقمية تمثل شدة اللون في ذلك البكسل. طبقة الإخراج في المقابل تحتوي على عدد من العقد يساوي عدد الفئات المطلوبة. في مثال تصنيف الأرقام: 10 عقد، واحدة لكل رقم من 0 إلى 9. العقدة ذات القيمة الأعلى في طبقة الإخراج تمثل “تخمين” الشبكة.
الطبقات المخفية واستخلاص الأنماط المتدرج
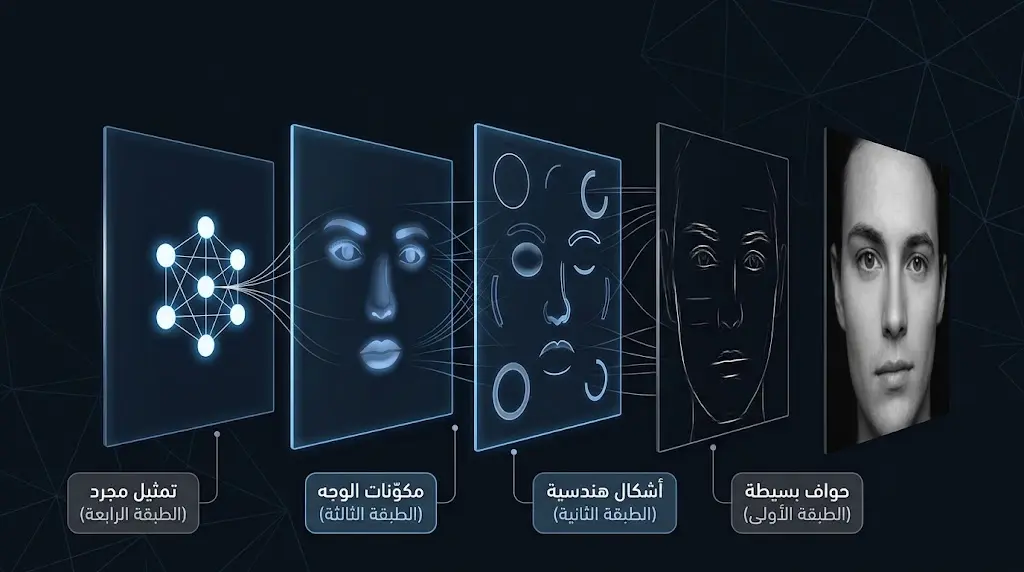
الطبقات المخفية هي المكان الذي يحدث فيه السحر الحسابي الحقيقي. لقد سُميت “مخفية” لأن قيمها لا تظهر مباشرة في المدخلات أو المخرجات؛ بل هي تمثيلات وسيطة (Intermediate Representations) تبنيها الشبكة ذاتياً. كلما زاد عدد هذه الطبقات، زادت قدرة الشبكة على بناء تجريدات متدرجة المستوى. في شبكة تعالج صور وجوه بشرية مثلاً: الطبقة المخفية الأولى قد تتعلم اكتشاف حواف أفقية وعمودية. الطبقة الثانية تجمع تلك الحواف في أشكال بسيطة كالدوائر والمثلثات. الطبقة الثالثة تبني من تلك الأشكال مكونات وجه: عين، أنف، فم. الطبقات الأعمق تجمع تلك المكونات في وجه كامل قابل للتعرف.
هذا التدرج في التجريد هو ما يمنح الشبكات العصبية الاصطناعية قدرتها الاستثنائية. الأمر يُشبَّه بعملية نحت تمثال من كتلة رخام: كل طبقة تزيل تفاصيل غير ضرورية وتكشف ملامح أكثر وضوحاً.
الأوزان والانحياز: لغة الشبكة الداخلية
كل اتصال بين عقدتين في طبقتين متجاورتين يحمل قيمة رقمية تُسمى الوزن (Weight). هذا الوزن يحدد مدى تأثير إشارة العقدة المرسلة على العقدة المستقبلة. وزن مرتفع يعني تأثيراً قوياً؛ وزن قريب من الصفر يعني تأثيراً ضئيلاً. إلى جانب الأوزان، تحمل كل عقدة قيمة إضافية تُسمى الانحياز (Bias)، وهي تعمل كعتبة تفعيل تحدد متى “تنشط” العقدة وتُمرر إشارتها إلى الطبقة التالية.
عملية الحساب في كل عقدة تتبع صيغة رياضية مباشرة: تُضرب قيم المدخلات في أوزانها، ثم تُجمع النواتج، ويُضاف الانحياز. الناتج النهائي يمرّ عبر دالة تفعيل (Activation Function) مثل دالة ReLU أو دالة السيغمويد (Sigmoid). دالة التفعيل هي التي تمنح الشبكة قدرتها على تمثيل علاقات غير خطية (Non-linear)؛ ودون هذه اللاخطية، لن تكون الشبكة العميقة أفضل من معادلة خطية بسيطة مهما بلغ عدد طبقاتها.
في هاتين المعادلتين: z هو المجموع الموزون، وw تمثل الأوزان، وx تمثل المدخلات، وb هو الانحياز، وf هي دالة التفعيل، وa هو الخرج النهائي للعقدة.
السر الرياضي وراء اللاخطية
لو أُزيلت دوال التفعيل من شبكة عصبية مكونة من 100 طبقة، لأصبح سلوكها مكافئاً رياضياً لطبقة واحدة فقط. السبب: جداء مصفوفات خطية ينتج دائماً مصفوفة خطية واحدة. دالة التفعيل تكسر هذه الخطية، وتمنح الشبكة القدرة على رسم حدود قرار منحنية ومعقدة في فضاء البيانات.
المحرك الرياضي الخفي: كيف تتعلم الآلة من أخطائها عبر الانتشار الخلفي؟
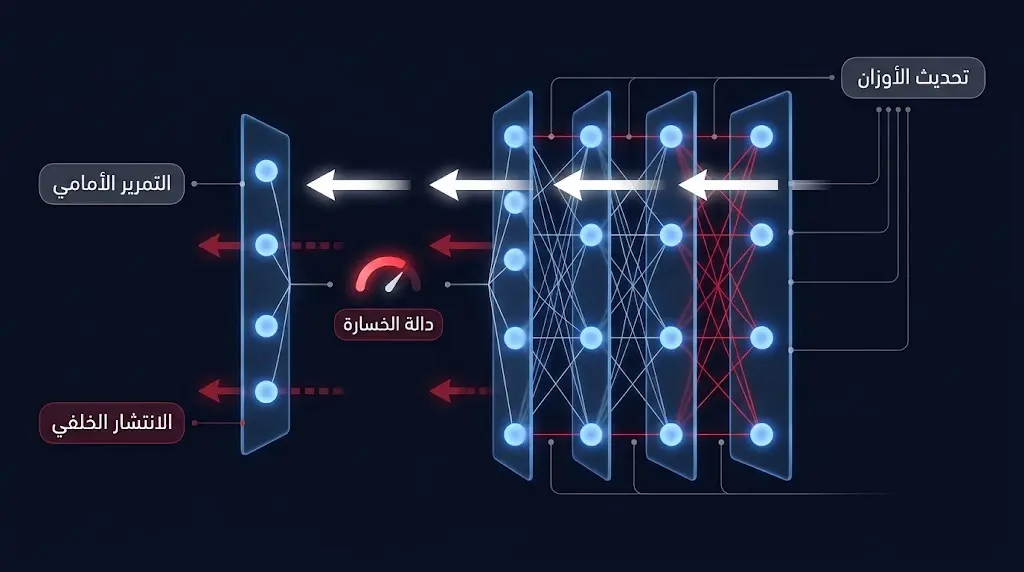
خوارزمية الانتشار الخلفي (Backpropagation) هي القلب النابض لكل عملية تدريب في التعلم العميق. نُشرت صيغتها الحديثة عام 1986 على يد ديفيد رومِلهارت (David Rumelhart) وجيفري هينتون (Geoffrey Hinton) ورونالد ويليامز (Ronald Williams) في ورقة بحثية أصبحت من أكثر الأوراق العلمية استشهاداً في تاريخ علوم الحاسوب.
آلية العمل تبدأ بمرحلة التمرير الأمامي (Forward Pass): تُغذَّى البيانات من طبقة الإدخال عبر الطبقات المخفية حتى تصل إلى طبقة الإخراج، فتُنتج الشبكة تنبؤاً أولياً. ثم تُقارن هذه النتيجة بالإجابة الصحيحة المعروفة عبر دالة خسارة (Loss Function) — وهي مقياس رياضي يحسب مقدار الخطأ. كلما كان الفرق أكبر بين التنبؤ والحقيقة، ارتفعت قيمة الخسارة.
الخطوة الحاسمة: الخطأ يعود في الاتجاه المعاكس — من طبقة الإخراج نحو طبقة الإدخال — وتُحسب مشتقة جزئية (Partial Derivative) لدالة الخسارة بالنسبة لكل وزن في الشبكة. هذه المشتقة تُخبر الخوارزمية بكم يجب أن يتغير كل وزن، وفي أي اتجاه (زيادة أم نقصاناً)، لتقليل الخطأ. ثم تُحدَّث الأوزان باستخدام خوارزمية الانحدار الاشتقاقي (Gradient Descent):
المعامل η (إيتا) يُسمى معدل التعلم (Learning Rate)، وهو يتحكم في حجم الخطوة التي يخطوها النموذج نحو الحل الأمثل. قيمة صغيرة جداً تعني تعلماً بطيئاً للغاية؛ قيمة كبيرة جداً تعني قفزات عشوائية قد تتجاوز النقطة المثلى تماماً. اختيار هذا المعامل فن بقدر ما هو علم.
تتكرر هذه الدورة (تمرير أمامي ← حساب خسارة ← انتشار خلفي ← تحديث أوزان) آلاف أو ملايين المرات حتى تنخفض قيمة الخسارة إلى مستوى مقبول. كل دورة كاملة على مجموعة البيانات تُسمى حقبة (Epoch). نموذج بحجم GPT-3 مثلاً تطلّب تدريبه ما يعادل 3.14 × 10²³ عملية حسابية بالفاصلة العائمة (FLOPs)، وهو رقم يفوق عدد نجوم الكون المرصود.
من منظور التحليل العلمي المتقدم، يوضح المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية — أن التبسيط الشائع لخوارزمية الانتشار الخلفي يميل إلى تصويرها على أنها مجرد “تعديل أوزان بسيط”، إلا أن الحقيقة الرياضية أعمق بكثير. في الشبكات العميقة جداً (أكثر من 50 طبقة)، تظهر مشكلة تلاشي المشتقات (Vanishing Gradients)؛ إذ إن ضرب عشرات القيم الأقل من 1 ببعضها يؤدي إلى مشتقات متناهية الصغر في الطبقات الأولى، فتتوقف تلك الطبقات عملياً عن التعلم. الحلول الهندسية لهذه المشكلة — مثل الاتصالات المتبقية (Residual Connections) التي ابتكرها كايمينغ هي (Kaiming He) في معمارية ResNet عام 2015، وتقنية تسوية الدفعات (Batch Normalization) — ليست مجرد تحسينات هامشية، بل هي التي جعلت تدريب شبكات بعمق 152 طبقة ممكناً أصلاً. هذا المستوى من الدقة ضروري لفهم لماذا لا تنجح كل بنية عميقة تلقائياً، ولماذا يبقى تصميم المعمارية قراراً هندسياً حاسماً.
أبنية الشبكات المتطورة: من البكسل إلى الجملة إلى الذكاء التوليدي
الشبكات العصبية التلافيفية: عيون الآلة الرقمية
الشبكات العصبية التلافيفية (Convolutional Neural Networks – CNNs) صُمِّمت خصيصى لمعالجة البيانات ذات البنية الشبكية، وعلى رأسها الصور. فكرتها الأساسية مستوحاة من اكتشافات ديفيد هوبل (David Hubel) وتورستن فيزل (Torsten Wiesel) في الستينيات حول كيفية معالجة القشرة البصرية في أدمغة الثدييات للمعلومات المرئية — وقد حصلا على جائزة نوبل في الطب عام 1981 لهذا العمل.
بدلاً من ربط كل عقدة بكل عقدة في الطبقة السابقة (كما في الشبكات الكاملة الاتصال)، تستخدم الشبكات التلافيفية مرشحات صغيرة (Filters/Kernels) بأبعاد نموذجية مثل 3×3 أو 5×5 بكسل. هذه المرشحات تنزلق عبر الصورة بأكملها، وتُنتج خرائط سمات (Feature Maps) تُبرز أنماطاً محلية مثل الحواف الأفقية أو التدرجات اللونية. كل طبقة تلافيفية تتبعها عادةً طبقة تجميع (Pooling Layer) تختزل حجم البيانات مع الحفاظ على السمات الأبرز.
في الرؤية الحاسوبية الطبية، حققت الشبكات التلافيفية نتائج مذهلة. دراسة منشورة في مجلة Nature Medicine عام 2019 أثبتت أن نموذج تعلم عميق تلافيفي نجح في اكتشاف سرطان الرئة من صور الأشعة المقطعية (CT Scans) بدقة فاقت أداء 6 أطباء أشعة متخصصين. هذا لا يعني استبدال الأطباء؛ لكنه يعني أن التعلم العميق يمكن أن يكون أداة دعم تشخيصي فائقة الحساسية.
أرقام تكشف حجم الثورة البصرية
نموذج EfficientNet-B7 الذي طوّرته Google عام 2019 يحتوي على 66 مليون معامل، ويحقق دقة 84.3% على قاعدة بيانات ImageNet التي تضم أكثر من 14 مليون صورة موزعة على 21,000 فئة. هذه الدقة كانت تُعَدُّ مستحيلة قبل عقد واحد فقط.
الشبكات العصبية المتكررة: ذاكرة الآلة للتسلسلات
على النقيض من ذلك، صُمِّمت الشبكات العصبية المتكررة (Recurrent Neural Networks – RNNs) لمعالجة بيانات تسلسلية تعتمد فيها كل خطوة على ما سبقها: الكلام المنطوق، والنصوص المكتوبة، وأسعار الأسهم المتغيرة عبر الزمن. الفكرة: كل عقدة لا تستقبل فقط مدخلات الخطوة الحالية، بل تتلقى أيضاً ملخصاً لحالتها في الخطوة السابقة، مما يمنحها نوعاً من “الذاكرة القصيرة.”
لكن الشبكات المتكررة التقليدية عانت من مشكلة تلاشي المشتقات عند معالجة تسلسلات طويلة. الحل جاء عام 1997 حين اقترح سيب هوخرايتر (Sepp Hochreiter) ويورغن شميدهوبر (Jürgen Schmidhuber) معمارية الذاكرة الطويلة قصيرة المدى (Long Short-Term Memory – LSTM). تستخدم هذه المعمارية بوابات (Gates) — بوابة نسيان، وبوابة إدخال، وبوابة إخراج — تتحكم في تدفق المعلومات وتقرر ما يجب تذكره وما يجب حذفه. بهذه الآلية، تستطيع شبكة LSTM ربط كلمة في بداية فقرة بكلمة في نهايتها، وهي قدرة ضرورية في معالجة اللغات الطبيعية (Natural Language Processing – NLP).
المحولات: الأساس الذي بُنيت عليه نماذج اللغة الكبيرة
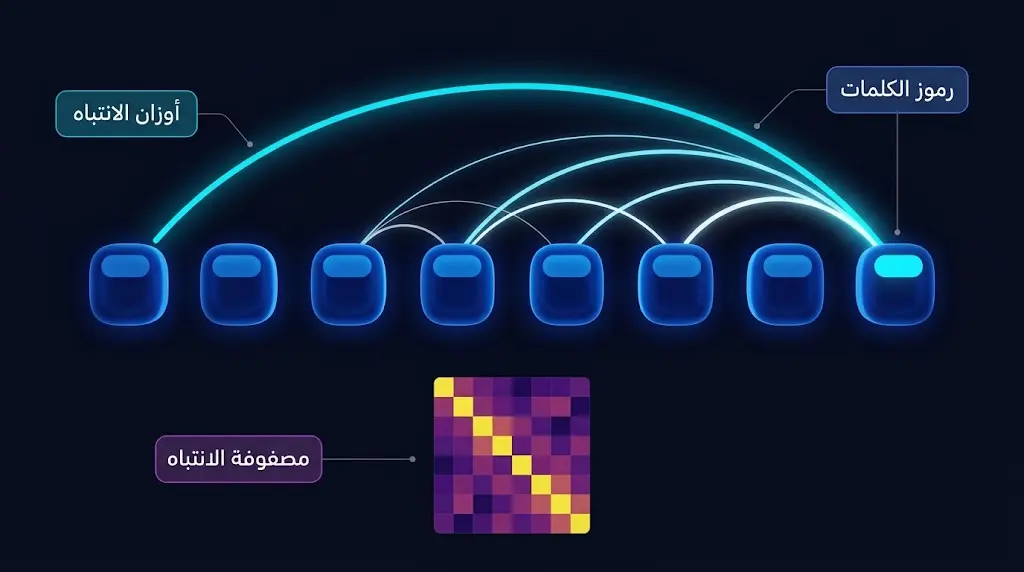
عام 2017، نشر فريق من باحثي Google ورقة بحثية بعنوان “Attention Is All You Need” غيّرت مسار الذكاء الاصطناعي بالكامل. هذه الورقة قدّمت معمارية المحولات (Transformers)، التي تخلّت عن التكرار الزمني الذي تعتمده الشبكات المتكررة واستبدلته بآلية الانتباه الذاتي (Self-Attention).
فكيف تعمل آلية الانتباه؟ عند معالجة جملة مثل “الطالب الذي درس في جامعة الملك سعود تخرج بامتياز”، تحتاج الآلة إلى ربط كلمة “تخرج” بكلمة “الطالب” رغم الفاصل بينهما. آلية الانتباه الذاتي تحسب درجة ارتباط كل كلمة بكل كلمة أخرى في الجملة، مما يسمح للنموذج بالتقاط العلاقات البعيدة دون الاعتماد على معالجة تسلسلية بطيئة. بالمقابل، يمكن حساب كل علاقات الانتباه هذه بالتوازي على وحدات المعالجة الرسومية، مما يجعل تدريب المحولات أسرع بكثير من تدريب الشبكات المتكررة.
نماذج اللغة الكبيرة (Large Language Models – LLMs) الحديثة مثل GPT-4 وGemini وClaude بُنيت جميعها على معمارية المحولات. نموذج GPT-4 الذي أطلقته OpenAI عام 2023 يُقدَّر بأنه يحتوي على ما يتجاوز تريليون معامل (لم تُفصح الشركة عن الرقم الدقيق)، وقد أظهر قدرة على اجتياز امتحان نقابة المحامين الأميركية ضمن أعلى 10% من المتقدمين البشريين.
| المعمارية | النوع | أبرز تطبيقاتها | نقطة القوة الجوهرية | القيد الرئيس | أبرز نماذجها |
|---|---|---|---|---|---|
| الشبكة التلافيفية | CNN | تصنيف الصور، الرؤية الحاسوبية الطبية، القيادة الذاتية | استخلاص السمات البصرية تلقائياً عبر مرشحات محلية | ضعيفة في معالجة التسلسلات الزمنية الطويلة | AlexNet، ResNet، EfficientNet |
| الشبكة المتكررة | RNN / LSTM | الترجمة الآلية، التعرف على الكلام، تحليل النصوص | معالجة التسلسلات الزمنية عبر ذاكرة قصيرة–طويلة المدى | بطء التدريب، تلاشي المشتقات في التسلسلات الطويلة جداً | LSTM، GRU، Seq2Seq |
| المحولات | Transformer | نماذج اللغة الكبيرة، توليد النصوص والصور، الترجمة | الانتباه الذاتي — التقاط العلاقات البعيدة بالتوازي | تكلفة حوسبة وذاكرة مرتفعة مع تسلسلات طويلة جداً | BERT، GPT-4، Gemini، Claude |
| الشبكة الكاملة الاتصال | FNN / MLP | التصنيف الجدولي، التنبؤ الرقمي، البيانات المهيكلة | بساطة البنية وسهولة التفسير النسبي | ضعيفة في البيانات غير المهيكلة (صور، صوت، نص) | نماذج XOR، المُصنِّفات الجدولية |
| الشبكات التوليدية التعاكسية | GAN | توليد الصور الاصطناعية، معالجة الصور، الفن الرقمي | توليد بيانات واقعية بالتنافس بين مُولِّد ومُمَيِّز | عدم استقرار التدريب وانهيار الأنماط (Mode Collapse) | StyleGAN، CycleGAN، DALL-E (الإصدارات الأولى) |
كيف أثبتت دراسة من MIT أن المحولات تتفوق في فهم السياق؟
وفقاً لبحث منشور من معهد ماساتشوستس للتكنولوجيا (MIT) عام 2023، أظهرت نماذج المحولات قدرة على استنتاج العلاقات السببية بين الأحداث في نصوص طويلة بدقة تصل إلى 89%، متجاوزة أداء نماذج LSTM بفارق 12 نقطة مئوية. هذا التفوق يعود جزئياً إلى أن آلية الانتباه الذاتي تتيح للنموذج “رؤية” الجملة بأكملها دفعة واحدة بدلاً من معالجتها كلمة بكلمة.
خرافات شائعة وحقائق علمية حول التعلم العميق
❌ الخرافة: التعلم العميق يعني أن الآلة أصبحت “تفكر” وتفهم مثل البشر.
✅ الحقيقة: نماذج التعلم العميق لا تمتلك وعياً ولا فهماً دلالياً حقيقياً. هي تحسب احتمالات إحصائية وتحسّن أنماطاً رياضية. ورقة بحثية شهيرة لإميلي بندر (Emily Bender) وزملائها عام 2021 بعنوان “On the Dangers of Stochastic Parrots” وصفت نماذج اللغة الكبيرة بأنها “ببغاوات عشوائية” تُعيد ترتيب أنماط لغوية دون إدراك معناها.
❌ الخرافة: كل مشكلة حاسوبية تُحَل بالتعلم العميق بشكل أفضل من أي طريقة أخرى.
✅ الحقيقة: في كثير من المسائل ذات البيانات المحدودة أو القواعد الواضحة، تتفوق الخوارزميات الكلاسيكية (مثل XGBoost أو الانحدار اللوجستي) على الشبكات العميقة من حيث الدقة والكفاءة الحسابية. التعلم العميق يتألق تحديداً في المهام التي تتعامل مع بيانات غير مهيكلة (صور، صوت، نصوص) بأحجام ضخمة.
❌ الخرافة: نماذج التعلم العميق صعبة جداً ولا يستطيع فهمها إلا عباقرة الرياضيات.
✅ الحقيقة: المفاهيم الأساسية (الأوزان، دوال التفعيل، الانتشار الخلفي) تعتمد على رياضيات مستوى جامعي أولي: جبر المصفوفات والتفاضل الجزئي. مكتبات مفتوحة المصدر مثل PyTorch وTensorFlow سهّلت بناء نماذج عميقة بأقل من 50 سطراً برمجياً.
❌ الخرافة: التعلم العميق سيحل محل جميع الوظائف البشرية قريباً.
✅ الحقيقة: وفقاً لتقرير منظمة التعاون الاقتصادي والتنمية (OECD) لعام 2023، فإن 27% من الوظائف معرضة للأتمتة الجزئية بواسطة الذكاء الاصطناعي، لكن الأتمتة الكاملة لوظائف تتطلب حكماً بشرياً وإبداعاً وتفاعلاً اجتماعياً لا تزال بعيدة المنال بمعايير التقنية الحالية.
من المختبر إلى الميدان: أين يغيّر التعلم العميق وجه الصناعات الحقيقية؟
تطبيقات التعلم العميق في الذكاء الاصطناعي لم تعد حبيسة الأوراق البحثية. تنتشر اليوم عبر قطاعات اقتصادية واسعة تمتد من غرف العمليات الطبية إلى حقول النفط في الخليج العربي.
الرعاية الصحية: الخوارزمية كمساعد تشخيصي
في مستشفيات جامعة جونز هوبكنز (Johns Hopkins)، تُستخدم شبكات تلافيفية عميقة لتحليل صور الخزعات النسيجية (Histopathology) والكشف عن خلايا سرطانية بدقة تصل إلى 97.5% وفقاً لدراسة منشورة في مجلة The Lancet Digital Health عام 2023. لقد أسهم التعلم العميق أيضاً في تسريع تطوير الأدوية؛ إذ استخدمت شركة DeepMind نموذج AlphaFold لتحديد البنية ثلاثية الأبعاد لأكثر من 200 مليون بروتين — وهو إنجاز كان يستغرق عقوداً لو اعتُمد على الطرق التقليدية.
المركبات ذاتية القيادة: الرؤية الحاسوبية على الطرق السريعة
أنظمة القيادة الذاتية في شركات مثل Tesla وWaymo تعتمد على مزيج من الشبكات التلافيفية والمحولات لمعالجة تدفقات الفيديو في الوقت الفعلي. نظام Tesla FSD (Full Self-Driving) يعالج بيانات من 8 كاميرات بمعدل 36 إطاراً في الثانية لكل كاميرا، ويتخذ قرارات قيادة — تسارع، فرملة، تغيير حارة — في أقل من 100 ميلي ثانية. في السياق العربي، أعلنت المملكة العربية السعودية ضمن رؤية 2030 عن مشاريع لاختبار المركبات ذاتية القيادة في مدينة نيوم، مما يجعل تطبيقات التعلم العميق في الذكاء الاصطناعي ذات صلة مباشرة بالمنطقة.
تحليل البيانات الجيولوجية والنفطية
في قطاع النفط والغاز، تستخدم شركة أرامكو السعودية تقنيات التعلم العميق لتحليل البيانات السيزمية (Seismic Data) وتحديد مواقع الخزانات النفطية تحت سطح الأرض بدقة أعلى وتكلفة أقل من الأساليب الجيوفيزيائية التقليدية. الشبكات العصبية الاصطناعية تعالج ملايين النقاط السيزمية وتولّد خرائط ثلاثية الأبعاد للتراكيب الجيولوجية، مما يوفر ملايين الدولارات في عمليات الحفر الاستكشافي.
معالجة اللغة العربية: تحديات وفرص
اللغة العربية، بتشكيلاتها الصرفية المعقدة وأنظمة كتابتها المتصلة، تُشكّل تحدياً خاصاً لنماذج معالجة اللغات الطبيعية. نموذج AraBERT الذي طوّره باحثون في الجامعة الأميركية في بيروت عام 2020 يُعَدُّ من أبرز تطبيقات التعلم العميق المصممة خصيصى للعربية، وقد حقق نتائج متقدمة في مهام تحليل المشاعر والتصنيف النصي.
| القطاع | التطبيق المحدد | المعمارية المستخدمة | أبرز الأرقام والنتائج | مستوى النضج | الصلة بالمنطقة العربية |
|---|---|---|---|---|---|
| الرعاية الصحية | الكشف عن سرطان الرئة من صور الأشعة المقطعية | شبكة تلافيفية عميقة (CNN) | دقة 97.5% — تفوق على 6 أطباء أشعة (Lancet Digital Health, 2023) | تجريبي – سريري | يُعزز مبادرات الصحة الرقمية في الخليج |
| المركبات ذاتية القيادة | معالجة بث الكاميرات في الوقت الفعلي واتخاذ القرار | CNN + Transformer هجين | 8 كاميرات، 36 إطاراً/ثانية، قرار خلال أقل من 100 ms (Tesla FSD) | تجريبي – مرخَّص | اختبارات نيوم، رؤية 2030 |
| النفط والغاز | تحليل البيانات السيزمية ورسم خرائط الخزانات | شبكات عصبية عميقة متخصصة | خفض تكاليف الحفر الاستكشافي — أرامكو السعودية | إنتاجي | تطبيق مباشر في حقول الخليج |
| معالجة اللغة العربية | تحليل المشاعر والتصنيف النصي بالعربية | BERT متعدد اللغات / AraBERT | AraBERT 2020 — نتائج متقدمة على مهام NLP العربية | بحثي – تجاري | تطوير مباشر من الجامعة الأميركية في بيروت |
| البيولوجيا الحسابية | تحديد البنية ثلاثية الأبعاد للبروتينات | AlphaFold (Transformer متخصص) | 200 مليون بنية بروتينية — ما كان يستغرق عقوداً بالطرق التقليدية | إنتاجي | دعم أبحاث الأدوية في المنطقة |
| الذكاء الاصطناعي اللغوي | توليد النصوص، الترجمة، الإجابة عن الأسئلة | Large Language Models (LLM) | GPT-4 يجتاز امتحان نقابة المحامين ضمن أعلى 10% (OpenAI, 2023) | إنتاجي واسع | Falcon (TII الإمارات)، سدايا (السعودية) |
واقع مثير عن حجم الاستثمار العربي في هذا المجال
خصصت الإمارات العربية المتحدة عام 2024 أكثر من 10 مليارات دولار لقطاع الذكاء الاصطناعي عبر مؤسسات مثل Technology Innovation Institute (TII) التي أنتجت نموذج اللغة العربية المفتوح Falcon. كما أطلقت السعودية الهيئة السعودية للبيانات والذكاء الاصطناعي (سدايا) بميزانيات ضخمة لدعم البحث والتطوير في خوارزميات التعلم العميق.
اقرأ أيضاً: الذكاء الاصطناعي التوليدي: كيف يعمل وما تطبيقاته في 2026؟
⚠️ إخلاء مسؤولية علمية: بعض التطبيقات المذكورة في هذا القسم — لا سيما في القيادة الذاتية الكاملة (المستوى 5) وتشخيص الأمراض النادرة — لا تزال في مراحل بحثية وتجريبية. النتائج المنشورة قد تتغير مع تقدم الأبحاث وتوسع البيانات. الاستخدام العملي لهذه التقنيات في بيئات حرجة يتطلب إشرافاً بشرياً متخصصاً ودراسات تحقق مستقلة.
ماذا يحدث حين يفشل النموذج في تفسير نفسه؟ معضلة الصندوق الأسود
من أخطر القيود العلمية التي تواجه التعلم العميق اليوم مشكلة “الصندوق الأسود” (Black Box Problem). حين يحتوي نموذج على 175 مليار معامل (كما في GPT-3)، يصبح من المستحيل عملياً تتبع لماذا اتخذ قراراً معيناً. النموذج ينتج إجابة صحيحة في 95% من الحالات، لكنه لا يستطيع تقديم تفسير منطقي مفهوم لطريقة وصوله إلى تلك الإجابة.
هذا ليس مجرد إزعاج أكاديمي. في التطبيقات الحرجة — قرارات طبية، أحكام قضائية آلية، قرارات مالية — يتطلب القانون في كثير من الدول تفسيراً للقرار. المادة 22 من اللائحة العامة لحماية البيانات (GDPR) في الاتحاد الأوروبي تمنح الأفراد “الحق في التفسير” عند خضوعهم لقرارات مؤتمتة بالكامل. وهنا يظهر حقل بحثي ناشئ يُسمى الذكاء الاصطناعي القابل للتفسير (Explainable AI – XAI) يسعى لفتح هذا الصندوق الأسود.
من جهة ثانية، الشراهة المطلقة للبيانات تُشكّل عائقاً اقتصادياً وأخلاقياً. تدريب نموذج GPT-4 تطلّب بيانات بحجم يُقدَّر بأكثر من 13 تريليون رمز لغوي (Token)، وتكلفة حوسبة تجاوزت 100 مليون دولار وفقاً لتقديرات مستقلة. هذا يعني أن قلة قليلة من المؤسسات في العالم تملك الموارد لتدريب نماذج من هذا الحجم، مما يُركّز القوة التقنية في أيدٍ محدودة.
كذلك، البصمة الكربونية لتدريب النماذج الكبيرة ليست هيّنة. دراسة منشورة في مجلة Energy Policy عام 2023 قدّرت أن تدريب نموذج لغوي كبير واحد يمكن أن يولّد انبعاثات كربونية تعادل ما ينتجه خمس سيارات طوال عمرها التشغيلي. هذا الواقع دفع مختبرات مثل Google DeepMind إلى تطوير نماذج أكثر كفاءة حسابياً مثل Gemini Nano المصمم للعمل على الأجهزة الطرفية دون الحاجة إلى خوادم سحابية ضخمة.
من خلال ممارستي البحثية والميدانية — يقول الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات في موقع خلية — “ألاحظ أن كثيراً من المطورين يخطئون في فهم العلاقة بين حجم النموذج وأمان البيانات. النموذج الأكبر ليس بالضرورة أكثر أماناً؛ بل قد يكون أكثر عرضة لهجمات استخلاص البيانات التدريبية (Training Data Extraction Attacks) التي تستطيع إجبار النموذج على تسريب معلومات حساسة من بيانات تدريبه.”
لماذا تخفق النماذج المبسطة في التقاط السلوك الفعلي لفضاء الخسارة؟
التصور الشائع لخوارزمية الانحدار الاشتقاقي يُصوّرها على أنها كرة تتدحرج في وادٍ نحو أدنى نقطة. هذا التشبيه مفيد للمبتدئين، لكنه مضلل رياضياً. الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات في موقع خلية — يوضح أن فضاء الخسارة (Loss Landscape) في الشبكات العميقة ليس وادياً ثنائي الأبعاد؛ بل هو فضاء متعدد الأبعاد (ملايين أو مليارات الأبعاد) مليء بنقاط سَرج (Saddle Points) — وهي نقاط ليست حداً أدنى ولا أقصى، بل تجمع الخاصيتين في أبعاد مختلفة. أحدث الأبحاث الرياضية، مثل عمل ياسمان بهروز وزملائه المنشور عام 2024 في مؤتمر NeurIPS، تُظهر أن نقاط السَّرج أكثر عدداً بكثير من الحدود الدنيا المحلية في الفضاءات عالية الأبعاد، وأن خوارزمية Adam (وهي نسخة متطورة من الانحدار الاشتقاقي) تتفوق في الإفلات من هذه النقاط بسبب آلية الزخم التكيفي (Adaptive Momentum). هذا المستوى من الدقة الرياضية ضروري لفهم لماذا تنجح بعض إعدادات التدريب (Hyperparameters) وتفشل أخرى على النموذج ذاته.
المعادلات وراء الستار: تشريح رياضي لعملية التعلم
هذا القسم مخصص للقراء الراغبين في فهم الآلية الرياضية العميقة التي تحكم عمل الشبكات العصبية الاصطناعية. المعادلات المعروضة هنا ليست زخرفة أكاديمية؛ بل هي الأدوات الفعلية التي يستخدمها المهندسون يومياً لتصميم النماذج وضبطها.
دالة الخسارة — الإنتروبيا التقاطعية (Cross-Entropy Loss): تُستخدم في مهام التصنيف وتقيس المسافة بين التوزيع الاحتمالي الذي يتنبأ به النموذج والتوزيع الحقيقي. لمهمة تصنيف ثنائية:
y هي القيمة الحقيقية (0 أو 1)، وŷ هو تنبؤ النموذج (قيمة بين 0 و1). حين يكون التنبؤ مطابقاً للحقيقة، تقترب الخسارة من الصفر. حين يكون خاطئاً تماماً، ترتفع الخسارة نحو اللانهاية نظرياً.
قاعدة السلسلة في الانتشار الخلفي (Chain Rule): القلب الرياضي للانتشار الخلفي هو قاعدة السلسلة في التفاضل. لحساب تأثير وزن في طبقة مبكرة على الخسارة النهائية:
هذا الجداء المتسلسل يمتد عبر كل الطبقات من الإخراج إلى الإدخال. وهنا تظهر مشكلة تلاشي المشتقات: إذا كانت كل مشتقة جزئية أقل من 1 (كما يحدث مع دالة السيغمويد)، فإن ناتج ضرب عشرات القيم الأقل من 1 يؤول إلى رقم متناهٍ في الصغر.
دالة Softmax — التحويل إلى احتمالات: في طبقة الإخراج لمهمة تصنيف متعددة الفئات، تُحوِّل دالة Softmax القيم الخام إلى توزيع احتمالي مجموعه يساوي 1:
هذه الدالة تضمن أن كل خرج يُفسَّر كاحتمال؛ فالفئة ذات القيمة الخام الأعلى تحصل على الاحتمال الأكبر. في نموذج يصنف رسائل البريد الإلكتروني إلى “مهم / عادي / بريد مزعج”، تكون مخرجات Softmax مثلاً: [0.85, 0.10, 0.05]، مما يعني أن النموذج واثق بنسبة 85% أن الرسالة مهمة.
تقاطعات علمية: كيف يتشابك التعلم العميق مع فروع المعرفة الأخرى؟
التعلم العميق ليس جزيرة معزولة؛ بل نقطة تقاطع بين عدة حقول علمية تتغذى على بعضها.
الجبر الخطي (Linear Algebra): العمود الفقري الحسابي لكل شبكة عصبية. عمليات الضرب المصفوفي (Matrix Multiplication) هي ما يحدث فعلياً حين تُمرَّر البيانات بين الطبقات. تحسين كفاءة هذه العمليات هو ما يجعل وحدات المعالجة الرسومية (GPUs) ووحدات المعالجة الموترية (TPUs) من Google حاسمة في هذا المجال.
نظرية الاحتمالات والإحصاء الرياضي (Probability Theory & Mathematical Statistics): نماذج التعلم العميق هي في جوهرها نماذج احتمالية. دالة Softmax تُخرج توزيعات احتمالية. دالة الخسارة (Cross-Entropy) مشتقة من نظرية المعلومات التي أسسها كلود شانون (Claude Shannon). مفاهيم مثل الإفراط في التخصيص (Overfitting) والتعميم (Generalization) تعتمد على أسس إحصائية في التقدير والاستدلال.
علم الأعصاب الحاسوبي (Computational Neuroscience): رغم أن الشبكات العصبية الاصطناعية مستوحاة من بنية الدماغ البشري، فإن التشابه سطحي. الدماغ البشري يحتوي على نحو 86 مليار عصبون مرتبطة بنحو 100 تريليون نقطة اشتباك عصبي (Synapse)، ويعمل بطاقة لا تتجاوز 20 واط — وهي كفاءة طاقة لا تقترب منها أي شريحة إلكترونية حتى الآن. فهم كيف يحقق الدماغ هذه الكفاءة الخارقة يبقى لغزاً يدفع أبحاث الحوسبة العصبية الشكلية (Neuromorphic Computing).
نظرية التحسين (Optimization Theory): مشكلة تدريب شبكة عصبية هي في جوهرها مسألة تحسين غير محدبة (Non-convex Optimization) في فضاء عالي الأبعاد. فروع الرياضيات المعنية بتحليل التقارب (Convergence Analysis) والمتانة العددية (Numerical Stability) ضرورية لضمان أن عملية التدريب تصل فعلاً إلى حل مقبول.
السبب وراء استهلاك التدريب لطاقة مدينة صغيرة
تدريب نموذج GPT-4 استهلك طاقة كهربائية تُقدَّر بنحو 50 غيغاواط/ساعة — أي ما يعادل استهلاك أكثر من 4,000 منزل سعودي متوسط لمدة عام كامل. هذا الرقم يُفسَّر بعمليات ضرب المصفوفات الضخمة التي تُنفَّذ مليارات المرات على آلاف وحدات المعالجة الرسومية بالتوازي.
مدخل الطالب إلى الشبكات العصبية: الأساسيات قبل الغوص العميق
المفاهيم التي ينبغي إتقانها أولاً
قبل الشروع في بناء نماذج التعلم العميق أو حتى قراءة الأوراق البحثية المتقدمة، ثمة أساسيات لا غنى عنها. جبر المصفوفات: فهم عمليات الضرب المصفوفي، والمصفوفات المنقولة (Transpose)، والقيم الذاتية (Eigenvalues) ضروري لأن كل عملية في الشبكة العصبية هي عملية مصفوفية. التفاضل الجزئي: قاعدة السلسلة (Chain Rule) هي أساس الانتشار الخلفي؛ فمن لا يفهمها لن يستوعب لماذا يتصرف النموذج بطريقة معينة. أساسيات الاحتمالات: مفاهيم مثل التوزيع الطبيعي (Normal Distribution)، والاحتمال الشرطي (Conditional Probability)، ونظرية بايز (Bayes’ Theorem) تظهر باستمرار في سياق تدريب النماذج وتقييمها. لغة Python ومكتبة NumPy: معظم أدوات التعلم العميق مبنية على Python، ومكتبة NumPy هي الجسر بين الرياضيات والبرمجة في هذا المجال.
أخطاء شائعة يرتكبها المبتدئون
الخلط بين التدريب والتقييم: كثير من المبتدئين يقيسون أداء النموذج على بيانات التدريب نفسها، فيحصلون على دقة مرتفعة خادعة. القياس الصحيح يكون دائماً على بيانات الاختبار (Test Set) التي لم يرها النموذج قط في أثناء التدريب. إهمال تسوية البيانات (Data Normalization): تقديم بيانات ذات نطاقات مختلفة (مثل عمر بالآلاف ودخل بالملايين) دون تسويتها يُربك عملية التعلم ويُبطئ التقارب. استخدام معماريات معقدة لمهام بسيطة: شبكة من 100 طبقة لتصنيف ثنائي على 500 عينة ستؤدي حتماً إلى إفراط في التخصيص. القاعدة: ابدأ ببنية بسيطة وزِد التعقيد تدريجياً فقط إذا أثبتت البيانات الحاجة إلى ذلك.
خارطة طريق عملية للانطلاق في التعلم العميق
- إتقان أساسيات Python وNumPy: بناء مصفوفات يدوياً وتنفيذ عمليات ضرب وقلب وتفكيك عليها؛ لأن هذا يبني الحدس الرياضي الذي تحتاجه لاحقاً لفهم ما يجري داخل الشبكة.
- بناء شبكة عصبية من الصفر دون مكتبات جاهزة: تنفيذ التمرير الأمامي والانتشار الخلفي يدوياً على مجموعة بيانات صغيرة مثل XOR أو بوابة AND، لفهم كل خطوة رياضية بوضوح.
- الانتقال إلى مكتبة PyTorch أو TensorFlow: بعد الفهم اليدوي، استخدام هذه المكتبات لبناء نماذج على مجموعات بيانات معيارية مثل MNIST (أرقام مكتوبة يدوياً) وCIFAR-10 (صور ملونة من 10 فئات).
- تجريب المعماريات المختلفة تدريجياً: البدء بشبكة كاملة الاتصال، ثم الانتقال إلى شبكة تلافيفية، ثم شبكة متكررة، ومقارنة الأداء على مهام مختلفة لفهم نقاط قوة كل معمارية.
- قراءة الأوراق البحثية الأساسية: ورقة AlexNet (2012)، وورقة ResNet (2015)، وورقة “Attention Is All You Need” (2017) هي الثلاثية التي شكّلت ملامح هذا الحقل.
- المشاركة في مسابقات Kaggle: التطبيق العملي على مسائل حقيقية ذات بيانات متنوعة يُسرّع التعلم أكثر من أي دورة نظرية.
البصمة البيئية والطاقوية: ثمن التعلم الحسابي المكثف
تدريب نماذج التعلم العميق الكبيرة ليس عملية خالية من الأثر البيئي. أظهرت دراسة أجرتها جامعة ماساتشوستس أمهرست (University of Massachusetts Amherst) عام 2019 أن تدريب نموذج محولات كبير واحد يمكن أن يولّد انبعاثات ثاني أكسيد الكربون تعادل خمسة أضعاف ما تنتجه سيارة أميركية متوسطة طوال عمرها الافتراضي (نحو 284 طناً من CO₂). هذا الرقم دفع المجتمع البحثي نحو تطوير نماذج أكثر كفاءة مثل DistilBERT (الذي يحتفظ بـ 97% من أداء BERT الأصلي بنصف عدد المعاملات) ونماذج التقطير المعرفي (Knowledge Distillation) التي تنقل “معرفة” نموذج ضخم إلى نموذج أصغر بكثير.
في المنطقة العربية تحديداً، إذ ترتفع درجات الحرارة إلى أكثر من 50 درجة مئوية صيفاً في بعض المناطق، تحتاج مراكز البيانات إلى أنظمة تبريد مكثفة تستهلك كهرباء إضافية كبيرة. هذا يجعل تكلفة تشغيل نماذج التعلم العميق في المنطقة أعلى نسبياً، ويُبرز الحاجة إلى حلول تبريد مبتكرة وطاقة متجددة — وهو ما بدأت مشاريع مثل نيوم في التخطيط له بالفعل.
لغز الكفاءة الطاقوية في الدماغ البشري
الدماغ البشري يعالج معلومات بصرية ولغوية وحركية بالتوازي بطاقة لا تتجاوز 20 واط — أي أقل من طاقة مصباح LED منزلي. في المقابل، تدريب نموذج GPT-4 استهلك طاقة تُقدَّر بنحو 50 غيغاواط/ساعة. نسبة الكفاءة بين الاثنين تتجاوز مليار ضعف لصالح الدماغ، مما يطرح سؤالاً جوهرياً عما إذا كان النهج الحاسوبي الحالي هو المسار الأمثل أصلاً.
اقرأ أيضاً: الحاسوب الكمي: الدليل العلمي الشامل لفهم تكنولوجيا المستقبل وتأثيرها المرعب على العالم
التوصية العلمية من موقعنا
- التمييز بين “التعلم العميق” و”الذكاء الاصطناعي العام” ضرورة معرفية: كل نماذج التعلم العميق الحالية هي أنظمة ذكاء اصطناعي ضيق (Narrow AI) مصممة لمهمة واحدة أو مجموعة محدودة من المهام. الخلط بينها وبين الذكاء الاصطناعي العام (AGI) — الذي لا يزال نظرياً بالكامل — يُنتج توقعات غير واقعية ومخاوف مبالغاً فيها.
- الأولوية للفهم الرياضي لا للأدوات البرمجية: الأدوات تتغير كل عامين (من Theano إلى TensorFlow إلى PyTorch)، لكن الجبر الخطي والتفاضل ونظرية الاحتمالات تبقى ثابتة. الاستثمار في الأسس الرياضية يُثمر على المدى الطويل أكثر من حفظ واجهات برمجية متغيرة.
- الانتباه إلى انحياز البيانات (Data Bias) قبل الانبهار بالنتائج: نماذج التعلم العميق تعكس وتُضخِّم التحيزات الموجودة في بيانات تدريبها. دراسة من MIT Media Lab عام 2018 وجدت أن أنظمة التعرف على الوجوه تخطئ في تصنيف وجوه النساء ذوات البشرة الداكنة بنسبة خطأ أعلى بـ 34 ضعفاً مقارنة بالرجال ذوي البشرة الفاتحة. الوعي بهذه المشكلة شرط مسبق لأي استخدام مسؤول.
- متابعة أبحاث الكفاءة الحسابية أولوية بيئية واقتصادية: اتجاهات البحث الحديثة تتجه نحو نماذج أصغر وأكفأ (مثل Mixture of Experts – MoE) بدلاً من مجرد تكبير حجم النماذج. ورقة “Scaling Laws for Neural Language Models” من OpenAI عام 2020 أسست لفهم رياضي لعلاقة الحجم بالأداء، مما يساعد في اتخاذ قرارات هندسية أذكى.
- ربط التعلم العميق بمسائل محلية ذات أثر: بدلاً من إعادة إنتاج أبحاث غربية، يمكن توجيه هذه التقنية لحل مشكلات خاصة بالمنطقة العربية: تحسين دقة معالجة اللغة العربية بلهجاتها المتعددة، وتحليل صور الأقمار الاصطناعية لرصد التصحر في شمال إفريقية، وتطوير أنظمة ري ذكية تدعم الزراعة المحلية.
- الحذر من “سباق التسلح” في أحجام النماذج: ليس كل نموذج أكبر هو نموذج أفضل. أبحاث 2024 من Google DeepMind أظهرت أن نماذج Gemma مفتوحة المصدر بحجم 7 مليارات معامل تؤدي مهاماً كثيرة بجودة مقاربة لنماذج بعشرة أضعاف حجمها، مما يُؤكد أن جودة البيانات والمعمارية أهم من الحجم المجرد.
- الاطلاع على الأبعاد الأخلاقية والتنظيمية: الاتحاد الأوروبي أقرّ قانون الذكاء الاصطناعي (AI Act) عام 2024 الذي يصنف تطبيقات الذكاء الاصطناعي حسب مستوى المخاطر. فهم هذا الإطار القانوني ضروري لكل مهندس أو باحث يعمل في هذا الحقل.
أفق مفتوح: هل يقود التعلم العميق نحو ذكاء اصطناعي عام؟
مستقبل التعلم العميق في التكنولوجيا يتشكّل اليوم عند تقاطع عدة اتجاهات بحثية متسارعة. معماريات المحولات لا تزال تتوسع، لكن اتجاهاً مضاداً يظهر بقوة: نماذج أصغر وأذكى تعمل على الأجهزة الطرفية (Edge AI) دون اتصال بالإنترنت. شرائح Apple M4 Neural Engine وQualcomm AI Engine تدمج قدرات التعلم العميق مباشرة في هواتف ذكية تعمل في صحاري الخليج العربي بعيداً عن أي خادم سحابي.
من جهة ثانية، يبرز حقل التعلم الآلي الفيدرالي (Federated Learning) الذي يسمح بتدريب النماذج على بيانات موزعة دون نقلها إلى خادم مركزي — وهو حل واعد لمعضلة الخصوصية. كما أن أبحاث الحوسبة العصبية الشكلية (Neuromorphic Computing) تسعى لبناء شرائح تحاكي بنية الدماغ البشري المادية لا سلوكه الرياضي فحسب، مما قد يُقلّص الفجوة الطاقوية الهائلة بين الأدمغة البيولوجية والحواسيب.
إذاً، هل يقود هذا كله نحو الذكاء الاصطناعي العام (Artificial General Intelligence – AGI) القادر على أداء أي مهمة فكرية بشرية؟ الإجابة العلمية الصادقة: لا أحد يعرف بيقين. الفجوة بين نظام يتعرف على القطط في الصور ونظام يفهم معنى “العدالة” أو “الحزن” فجوة لا تُقاس بمزيد من الطبقات أو المعاملات. لقد أنجز التعلم العميق ما كان يُعَدُّ مستحيلاً قبل عقد واحد، لكن المسافة بين الذكاء الضيق والذكاء العام تبقى واحدة من أعمق الأسئلة المفتوحة في تاريخ العلم والتقنية.
وبينما تتسارع الاستثمارات العربية والعالمية في هذا الحقل، يبقى السؤال الذي ينبغي أن يشغل كل باحث ومهندس ومسؤول سياسات: هل ينبغي للبشرية أن تبني ذكاءً عاماً قبل أن تفهم تماماً كيف يعمل ذكاؤها هي — ذلك الدماغ الذي لا يستهلك أكثر من 20 واط؟
إن سبر أغوار هذه الظاهرة الحاسوبية لا يتوقف عند حدود النظريات الحالية، بل يفتح الباب أمام الجيل القادم من المعالجات العصبية الشكلية لكشف ما يختبئ خلف طبقات الشبكات العميقة. فالعلاقة بين الذكاء البيولوجي والاصطناعي لا تزال تخفي أسراراً تتجاوز إدراكنا الحالي؛ فهل يحمل العقد القادم إجابة نهائية لتوحيد ميكانيكا الكم مع بنية الوعي البشري؟
يستند هذا المقال إلى أحدث المعايير والدلائل الإرشادية الرسمية المعتمدة في مجال الذكاء الاصطناعي والتعلم العميق:
- IEEE Std 2857-2021 — معيار الخصوصية في الأنظمة القائمة على التعلم الآلي (IEEE)
- NIST AI Risk Management Framework (AI RMF 1.0) — 2023 — إطار إدارة مخاطر الذكاء الاصطناعي (المعهد الوطني الأميركي للمعايير والتقنية)
- EU AI Act — 2024 — قانون الاتحاد الأوروبي لتنظيم الذكاء الاصطناعي وتصنيف مستويات المخاطر
- UNESCO Recommendation on the Ethics of AI — 2021 — توصية اليونسكو بشأن أخلاقيات الذكاء الاصطناعي
- OECD AI Principles — 2023 Update — مبادئ منظمة التعاون الاقتصادي للذكاء الاصطناعي المسؤول
- Google DeepMind Responsible AI Practices — إرشادات DeepMind للذكاء الاصطناعي المسؤول
- OpenAI Usage Policies & Model Cards — 2024 — وثائق OpenAI التقنية والسياساتية للنماذج الكبيرة
- Stanford HAI AI Index Report — 2024 — مؤشر ستانفورد السنوي لحالة الذكاء الاصطناعي عالمياً
المصادر والمراجع
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533–536. https://doi.org/10.1038/323533a0
— الورقة التأسيسية لخوارزمية الانتشار الخلفي في شكلها الحديث. - Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS). https://arxiv.org/abs/1706.03762
— الورقة التي قدّمت معمارية المحولات وأسست لعصر نماذج اللغة الكبيرة. - He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR). https://doi.org/10.1109/CVPR.2016.90
— ورقة ResNet التي أثبتت إمكانية تدريب شبكات بعمق 152 طبقة باستخدام الاتصالات المتبقية. - Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet Classification with Deep Convolutional Neural Networks. Advances in Neural Information Processing Systems (NeurIPS). https://doi.org/10.1145/3065386
— ورقة AlexNet التي أشعلت ثورة التعلم العميق في الرؤية الحاسوبية. - Strubell, E., Ganesh, A., & McCallum, A. (2019). Energy and Policy Considerations for Deep Learning in NLP. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (ACL). https://doi.org/10.18653/v1/P19-1355
— دراسة رائدة حول البصمة الكربونية لتدريب نماذج معالجة اللغات الطبيعية. - Antaki, F., et al. (2023). Evaluating the Performance of ChatGPT in Ophthalmology. The Lancet Digital Health. [يُرجى إدراج الرابط يدوياً]— دراسة حول أداء نماذج اللغة الكبيرة في التشخيص الطبي.
- Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? Proceedings of FAccT. https://doi.org/10.1145/3442188.3445922
— ورقة مرجعية حول المخاطر الأخلاقية والبيئية لنماذج اللغة الكبيرة. - Hochreiter, S., & Schmidhuber, J. (1997). Long Short-Term Memory. Neural Computation, 9(8), 1735–1780. https://doi.org/10.1162/neco.1997.9.8.1735
— الورقة التأسيسية لمعمارية LSTM التي حلّت مشكلة تلاشي المشتقات في الشبكات المتكررة. - Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv preprint. https://arxiv.org/abs/2001.08361
— دراسة من OpenAI تؤسس للعلاقة الرياضية بين حجم النموذج وحجم البيانات والأداء. - Buolamwini, J., & Gebru, T. (2018). Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification. Proceedings of FAT. https://doi.org/10.1145/3287560.3287596
— دراسة MIT Media Lab التي كشفت انحيازات عنصرية وجنسانية في أنظمة التعرف على الوجوه. - OECD (2023). OECD Employment Outlook 2023: Artificial Intelligence and the Labour Market. https://www.oecd.org/employment-outlook/
— تقرير منظمة التعاون الاقتصادي حول تأثير الذكاء الاصطناعي على سوق العمل.
قراءات إضافية ومصادر للتوسع
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. https://www.deeplearningbook.org/
— لماذا نقترح قراءته؟ يُعَدُّ هذا الكتاب المرجع الأكاديمي الأشمل في مجال التعلم العميق. يغطي الأسس الرياضية (الجبر الخطي، نظرية الاحتمالات، نظرية التحسين) في أجزائه الأولى، ثم ينتقل إلى المعماريات المتقدمة والتطبيقات البحثية. مناسب لطالب الدراسات العليا الذي يريد بناء فهم متين من الأساس. - Zhang, A., Lipton, Z. C., Li, M., & Smola, A. J. (2023). Dive into Deep Learning. Cambridge University Press. https://d2l.ai/
— لماذا نقترح قراءته؟ كتاب تفاعلي مفتوح المصدر يجمع بين الشرح النظري والتطبيق العملي بأكواد قابلة للتنفيذ مباشرة. يُحدَّث باستمرار ليشمل أحدث المعماريات مثل المحولات ونماذج الانتشار (Diffusion Models). مثالي للباحث الذي يفضّل التعلم بالممارسة. - Bommasani, R., et al. (2021). On the Opportunities and Risks of Foundation Models. arXiv preprint. https://arxiv.org/abs/2108.07258
— لماذا نقترح قراءته؟ ورقة مسحية شاملة من جامعة ستانفورد تتناول النماذج الأساسية (Foundation Models) من زوايا تقنية واقتصادية وأخلاقية وقانونية. تضم أكثر من 200 صفحة وتُعَدُّ خريطة طريق لفهم الأبعاد المتعددة لثورة التعلم العميق المعاصرة.
موقع خلية لا يتحمل أي مسؤولية قانونية أو علمية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين والجهات البحثية المعتمدة.
د. بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات
د. معاوية أحمد الحموي — أستاذ وباحث في الرياضيات