شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
ما الذي يجري فعلاً خلف واجهة الدردشة؟

تقنية ChatGPT هي منظومة حوسبة لغوية مبنية على نماذج عصبية توليدية، تحوّل المدخلات إلى رموز رقمية ثم تحسب احتمالات متتابعة للرمز التالي. تعتمد نماذج GPT الحديثة على بنية المحولات (Transformers) وآليات الانتباه الذاتي. ويستطيع GPT-4o معالجة النص والصوت والصورة والفيديو ضمن نموذج متعدد الوسائط، مع نافذة سياق تبلغ 128000 رمزاً.
الدكتور المهندس أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات
د. بلال الهندي — أستاذ الفيزياء النووية والنمذجة الحسابية
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
- ChatGPT ليس قاعدة بيانات: يحسب احتمالات الرمز التالي عبر مليارات المعلمات، لا يسترجع إجابات جاهزة.
- بنية Transformer: القلب الحسابي لنماذج GPT — تعتمد على الانتباه الذاتي لربط كل رمز بالرموز المحيطة به.
- التقطيع الرمزي (Tokenization): الخطوة الأولى — النص يتحول إلى أرقام قبل أي معالجة، وهذا يفسر تحديات اللغة العربية.
- التدريب المسبق + RLHF: مرحلتان لا غنى عنهما — الأولى تعلّم الأنماط، والثانية تحوّل النموذج إلى مساعد حواري مفيد.
- السياق الطويل ≠ الذاكرة الكاملة: نافذة 1,000,000 رمز لا تضمن استخدام جميع المعلومات بكفاءة متساوية.
- الهلوسة ظاهرة بنيوية: تنشأ من التوليد الاحتمالي لا من “الكذب” — الطلاقة لا تضمن الدقة.
- العربية تحتاج تقييماً مستقلاً: لا يصح نقل نتائج الإنجليزية — اللهجات والصرف والبيانات تحتاج اختبارات مخصصة.
- RAG يُضيف موثوقية: ربط النموذج بمصادر خارجية قابلة للتحقق يُقلل الهلوسة في التطبيقات الحساسة.
حين تبدو الرياضيات كأنها وعي
المفارقة الرئيسة في تقنية ChatGPT أن المظهر اللغوي شديد القرب من الحوار البشري، بينما البنية الحسابية لا تحتاج إلى وعي بشري لكي تنتج ذلك السلوك. لا توجد داخل النموذج مكتبة صغيرة تحمل جواباً جاهزاً لكل سؤال، ولا موظف رقمي يقرأ السؤال ثم يبحث عن رد مناسب. هناك شبكة عصبية ضخمة تضبط مليارات القيم العددية، ثم تحول التسلسل المدخل إلى توزيع احتمالي على الرموز المحتملة.
لقد أصبحت هذه الفكرة ذات أثر اقتصادي مباشر. فالواجهة الحوارية تخفي وراء بساطتها سلسلة من عمليات المصفوفات، وضربات المتجهات، وتطبيع الاحتمالات، ونقل البيانات بين الذاكرة والمعالجات المتوازية. ولهذا فإن الإجابة التي تبدو جملة طبيعية قد تكون النتيجة النهائية لعمليات حسابية واسعة تجري خلال أجزاء من الثانية. ويُشبَّه ذلك بمنظومة ترجمة فورية تعمل داخل صندوق أسود: النتيجة مفهومة بشرياً، أما الطريق إليها فرياضي في جوهرها.
مثال واحد يكشف الآلة من الداخل
تصل عبارة مثل «ارتفعت الحرارة لأن الضغط داخل الحجرة ازداد» إلى النموذج في صورة رموز، لا في صورة معنى إنساني جاهز. تُقسَّم العبارة إلى وحدات رمزية، وتتحول كل وحدة إلى تمثيل عددي، ثم تمر عبر طبقات متتابعة تبحث فيها الشبكة عن العلاقات بين الرموز. في طبقة معينة قد ترتبط كلمة «الضغط» بـ«الحجرة»، وفي طبقة أخرى يصبح الارتباط بين «ازداد» و«الحرارة» أكثر بروزاً.
عندما يبدأ التوليد، لا يكتب النموذج الجملة كلها دفعة واحدة. يحسب توزيعاً احتمالياً للرمز التالي، يختار منه رمزاً وفق آلية التوليد، ثم يعيد إدخال الرمز الجديد إلى السياق ويكرر العملية. وإذا كان آخر السياق هو «ارتفعت الحرارة لأن»، فقد تكون هناك احتمالات عديدة للرمز التالي. تحدد أوزان النموذج الاحتمالات من خلال الأنماط التي تعلمها أثناء التدريب. وهكذا يظهر السرد المتماسك من سلسلة قرارات محلية متتابعة.
مفارقة هندسية: الجملة الكاملة تبدو كوحدة فكرية واحدة، لكن النموذج التوليدي يبنيها فعلياً عبر سلسلة من تنبؤات الرموز، مع اعتماد كل خطوة على السياق المتاح في تلك اللحظة.
من الشبكات المتكررة إلى المحولات
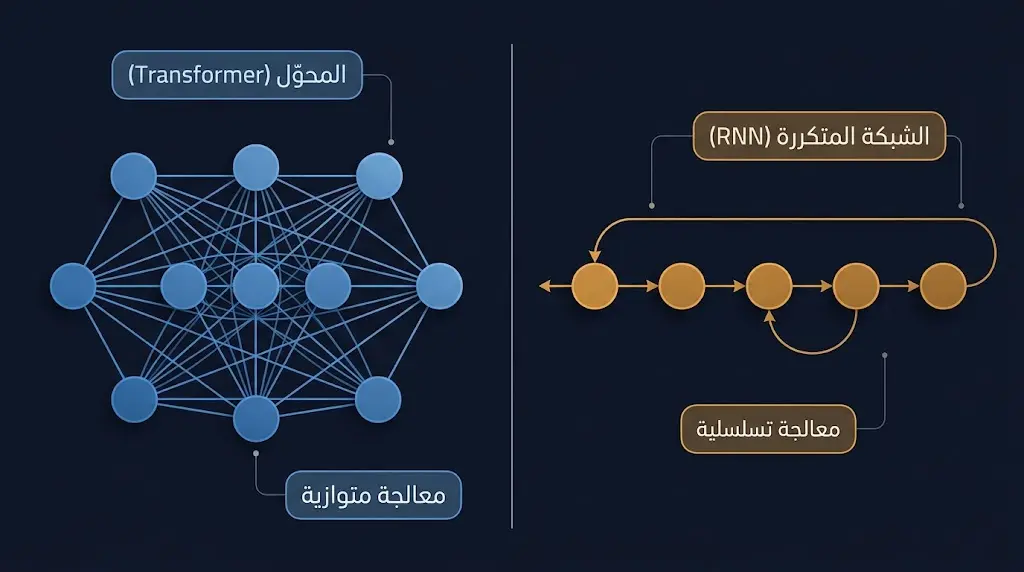
قبل ظهور المحولات، اعتمدت نماذج لغوية كثيرة على الشبكات العصبية المتكررة (RNN) وشبكات الذاكرة طويلة قصيرة الأجل (LSTM). كانت هذه البنى تعالج التسلسل خطوة بعد خطوة، وتحمل حالة داخلية تنتقل من موضع إلى آخر. هذه الفكرة نافعة، لكنها تجعل التوازي أثناء التدريب أكثر صعوبة؛ لأن الحساب في موضع لاحق يرتبط بحساب الموضع السابق.
جاءت ورقة Attention Is All You Need عام 2017 باقتراح مختلف جذرياً. قدمت بنية Transformer التي تعتمد على آليات الانتباه بدلاً من التكرار الزمني التقليدي. وبيّنت الورقة أن هذه البنية تستطيع تحقيق نتائج قوية في الترجمة مع قدرة أكبر على التوازي أثناء التدريب. كانت تلك النقلة من اللبنات التي قادت إلى سلسلة طويلة من نماذج اللغة الحديثة.
لكن المحول ليس مجرد «نظام انتباه». إنه منظومة تضم تمثيلات للرموز، وترميزاً للموقع، وطبقات انتباه، وشبكات أمامية، واتصالات متبقية، وآليات تطبيع. وفي نماذج GPT التوليدية يستخدم الاتجاه السببي (Causal) بحيث لا يستفيد الرمز الحالي من رموز مستقبلية غير متاحة في أثناء التنبؤ.
ما الذي يفعله الانتباه الذاتي فعلياً؟
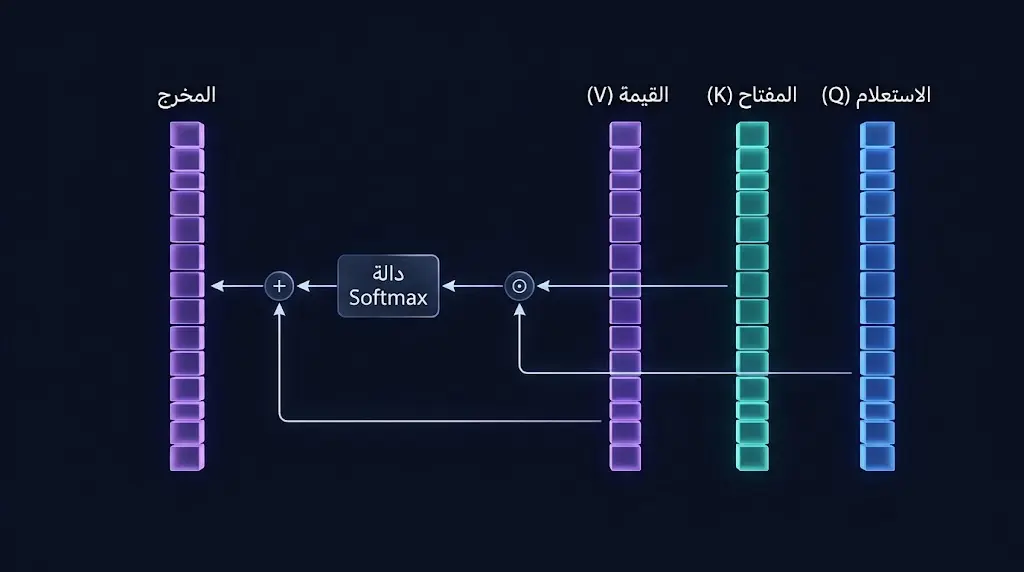
الانتباه الذاتي (Self-Attention) هو الآلية التي تمنح كل رمز القدرة على تقييم صلته بالرموز الأخرى داخل السياق. عندما تظهر كلمة متعددة الدلالة، لا تنظر الطبقة إلى الكلمة بمعزل عن بقية التسلسل. بل تستخدم تمثيلها وتفاعلاتها مع بقية الرموز لتكوين تمثيل جديد أكثر اعتماداً على السياق.
يمكن تمثيل الفكرة الأساسية للمكوّن عبر ثلاثة تحويلات تسمى الاستعلام (Query) والمفتاح (Key) والقيمة (Value). يُستخدم الاستعلام للبحث عن الصلات، ويحدد المفتاح قابلية كل عنصر للمقارنة، بينما تحمل القيمة المعلومات التي ستنتقل إلى التمثيل الناتج. الناتج لا يكون «فكرة» صريحة، بل مصفوفة أوزان عددية تتغير مع كل موضع وكل طبقة.
الصيغة المختصرة للنواة الرياضية للانتباه هي:
المعنى الهندسي بسيط نسبياً. تحسب الشبكة تشابهات بين الاستعلامات والمفاتيح، تقسمها على عامل مرتبط ببعد المتجهات، ثم تطبق دالة Softmax لتحويل القيم إلى أوزان نسبية. بعدها تُجمع القيم وفق تلك الأوزان. وفي المحولات الحديثة، تتكرر هذه العملية عبر رؤوس متعددة تسمى Multi-Head Attention، بحيث تستطيع الرؤوس التقاط أنواع مختلفة من العلاقات.
السر في المعادلة: عملية الانتباه لا «تقرأ المعنى» مثل إنسان؛ إنها تعيد توزيع الوزن الحسابي بين أجزاء السياق. المعنى الظاهر ينشأ من التركيب الكلي لهذه التحويلات عبر طبقات كثيرة.
كيف تَقرأ الآلة اللغة قبل أن تفهمها؟
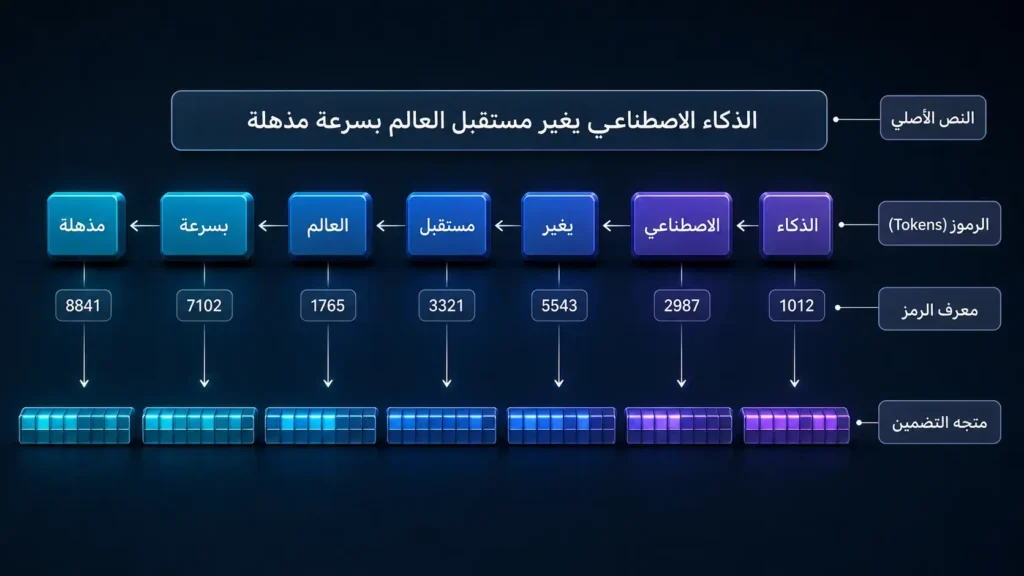
لا تبدأ معالجة اللغة الطبيعية (Natural Language Processing) داخل نموذج GPT من الكلمات كما تظهر في الصفحة. تبدأ من التمثيل العددي. الحروف والعلامات والمسافات والسلاسل الفرعية تتحول إلى رموز ضمن مفردات ذات أحجام محددة، ثم ترتبط هذه الرموز بمتجهات عددية.
هذه النقطة ضرورية لفهم سبب فشل بعض التصورات الشائعة. النموذج لا يستقبل جملة عربية ثم يضع بجانبها بطاقة معنوية تقول «هذا اسم» أو «هذه جملة شرطية». يدخل التسلسل إلى الشبكة كقيم عددية. ومع مرور هذه القيم في الطبقات، تتشكل تمثيلات موزعة (Distributed Representations) تحمل أنماطاً لغوية وسياقية يصعب اختزالها في قاموس بسيط.
التقطيع الرمزي يسبق الاستدلال
تسمى عملية تحويل النص إلى وحدات رمزية Tokenization. وقد يكون الرمز كلمة كاملة، أو جزءاً من كلمة، أو علامة ترقيم، أو مقطعاً أقصر من ذلك. وتختلف عملية التقطيع باختلاف المفردات المستخدمة في النموذج.
وهنا تظهر إحدى خصائص اللغة العربية. الكلمة العربية قد تحتوي على جذع ولواصق متعددة، كما أن المسافة لا تفصل دائماً بين كل وحدة صرفية بالطريقة نفسها الموجودة في الإنجليزية. لذلك يمكن أن تنتج الكلمة الواحدة عدة رموز، ما يؤثر في طول السياق والتكلفة وسلوك النموذج. ولا يصح اختزال الأمر في عبارة «النموذج لا يفهم العربية»؛ الأدق أن بنية اللغة العربية صرفياً ومورفولوجياً تفرض تحديات مختلفة على الترميز والتدريب والتقييم.
تُظهر دراسات حديثة في معالجة اللغة العربية أن الفجوة ليست لغوية صرفة، بل ترتبط كذلك بالبيانات والثقافة وتنوع اللهجات ومهام التقييم. أظهر مشروع LAraBench مثلاً الحاجة إلى تقييم النماذج عبر عشرات المهام والبيانات العربية بدلاً من افتراض أن أداء النموذج في الإنجليزية يساوي أداءه في العربية. كما ناقشت أعمال أخرى بناء نماذج عربية أكثر مواءمة لغوياً وثقافياً.
لماذا تبدو العربية أحياناً أصعب على النموذج؟
العربية تجمع خصائص تجعل تمثيلها تحدياً تقنياً واضحاً. التشكيل قد يتغير، واللهجات متعددة، والكتابة الحديثة تمزج بين العربية والإنجليزية والأرقام والعلامات، كما أن الكلمات المشتقة يمكن أن تحمل مقداراً كبيراً من المعلومات الصرفية في سلسلة واحدة.
يتجلى ذلك في أمثلة يومية من المحتوى العربي على الإنترنت. جملة باللهجة السعودية قد تمزج كلمات عربية مع اسم تطبيق باللغة الإنجليزية، ثم تضيف رقماً أو رمزاً، ثم تختصر بعض الحروف في الكتابة السريعة. بالنسبة للإنسان، يظل السياق الاجتماعي كافياً لفهم الجملة غالباً. بالنسبة للنظام، يدخل كل اختلاف إلى مساحة التمثيل الرمزي والتعلم الإحصائي.
| التحدي | وصف المشكلة التقنية | التأثير على الترميز | التأثير على الأداء | مستوى التأثير | الحل المقترح بحثياً |
|---|---|---|---|---|---|
| الإعراب والتشكيل | الكلمة تتغير بتغير الحركات دون تغير الهجاء | رموز مختلفة للكلمة ذاتها | ارتفاع معدل الالتباس الدلالي | مرتفع | تدريب مع بيانات مُشكَّلة وغير مُشكَّلة |
| تعدد اللهجات | اختلاف جذري في المفردات والنحو بين اللهجات | توزيع غير متوازن في بيانات التدريب | ضعف في اللهجات الأقل تمثيلاً | مرتفع | مجموعات بيانات لهجية مخصصة (LAraBench) |
| الإلصاقية الصرفية | كلمة واحدة تحمل جذراً ولواصق متعددة | كلمة واحدة = رموز متعددة | زيادة طول السياق وتكلفة المعالجة | مرتفع | مقسِّمات مخصصة للعربية (Arabic Tokenizers) |
| الكتابة المختلطة | دمج عربية + إنجليزية + أرقام + رموز | تعدد ترميزات في نص واحد | عدم استقرار في التمثيلات | متوسط | بيانات تدريب تعكس الواقع الرقمي العربي |
| شُح البيانات الجودية | نصوص عربية عالية الجودة أقل نسبياً | تحيز في التمثيلات نحو الإنجليزية | فجوة أداء ملحوظة في المهام التخصصية | مرتفع | مشاريع تجميع بيانات عربية (AceGPT) |
| الاتجاه من اليمين لليسار | اتجاه الكتابة عكس معظم بيانات التدريب | تأثير محدود على مستوى الرمز | تأثير على التقييم والواجهات | منخفض | ضبط الواجهات وأدوات التقييم |
| غياب معايير تقييم عربية | نقل معايير الإنجليزية مباشرة للعربية | لا يؤثر في الترميز | تقييم غير دقيق للأداء الفعلي | مرتفع | بناء معايير عربية مستقلة (LAraBench 2024) |
سر لغوي قليل الظهور: جودة العربية في النموذج لا تعتمد على «عدد الكلمات العربية» وحده. توزيع اللهجات، جودة النصوص، تمثيل الصرف، تنوع المجالات، وبيانات التعليمات كلها تؤثر في السلوك النهائي للنموذج.
المتجهات التي تمنح الرموز موقعها في الفضاء
بعد التقطيع، يحتاج النموذج إلى تمثيل عددي قابل للمعالجة. هنا تأتي التضمينات (Embeddings). يرتبط كل رمز بمتجه من الأعداد الحقيقية داخل فضاء ذي أبعاد كثيرة. هذه المتجهات ليست تعريفات قاموسية. إنها حالات عددية يتعلم النموذج ضبطها بحيث تصبح مفيدة للمهام التي يؤديها.
عندما تتكرر أنماط لغوية معينة، تتحرك التمثيلات أثناء التدريب نحو بنية عددية تسمح بتمييز العلاقات. هذه العلاقات ليست دائماً هندسية بسيطة من نوع «كلمة قريبة من كلمة». إنها موزعة عبر أبعاد كثيرة وعبر طبقات متتابعة. ومع مرور السياق، يصبح المتجه الخاص بالرمز مشبعاً بمعلومات جديدة عن موقعه وعلاقاته.
التضمين الأولي ليس نهاية المطاف. فطبقات المحول تعيد تشكيل التمثيلات مرات كثيرة. لذلك فإن كلمة واحدة قد تمتلك تمثيلاً مختلفاً بعد كل طبقة. هذا يفسر لماذا يصعب استخراج «معنى الكلمة في النموذج» في متجه واحد ثابت.
من الإنترنت إلى أوزان النموذج
التدريب المسبق (Pre-training) هو المرحلة التي يتعرض فيها النموذج لكمية ضخمة من النصوص والبيانات. المهمة الأساسية في نماذج GPT التوليدية هي التنبؤ بالرمز التالي في السياق. قد تبدو المهمة بسيطة، لكن تكرارها على نطاق هائل يجبر النموذج على التعلم من انتظامات معقدة في اللغة والبرمجة والمعلومات.
ورقة GPT-2 وصفت نموذجاً يتعلم من نصوص الإنترنت للتنبؤ بالكلمة التالية. ثم جاء GPT-3 بزيادة هائلة في الحجم، وبلغ عدد معلماته المعلن 175 مليار معلمة. أظهرت نتائج GPT-3 أن توسيع النماذج يمكن أن يحسن أداء التعلم من أمثلة قليلة داخل السياق، رغم بقاء قيود منهجية ومشكلات في موثوقية البيانات.
هذا يقود إلى مفهوم المعلمات (Parameters). كل معلمة هي قيمة عددية تتعلم الشبكة ضبطها أثناء التدريب. لا تعني المعلمة «معلومة واحدة». قد تساهم ملايين القيم في تمثيل نمط واحد، وقد تتداخل وظائفها بين اللغة والشفرة والاستدلال والتوليد.
الرقم الذي غيّر الصناعة: GPT-3 أُعلن بنحو 175 مليار معلمة، وهو ما ساعد على ترسيخ دراسة قوانين التوسع (Scaling Laws) في النماذج اللغوية واسعة النطاق.
لماذا لا يكفي التدريب المسبق لصناعة ChatGPT؟
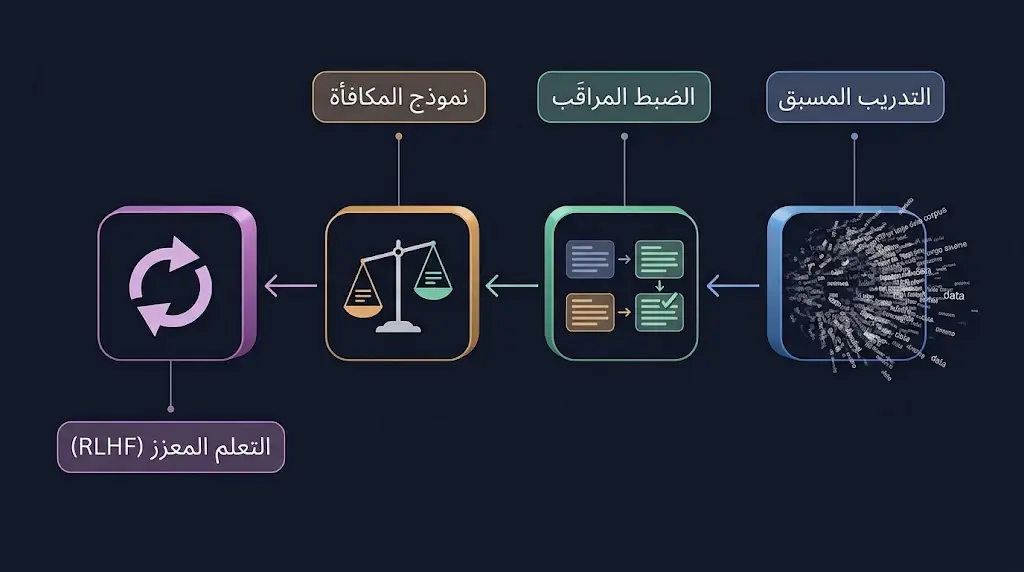
النموذج المسبق يتعلم انتظامات النص، لكنه لا يتعلم تلقائياً ما يريده المستخدم من محادثة مساعدة وآمنة. قد تكون الجملة التالية المتوقعة إحصائياً بذيئة، مضللة، أو غير مرتبطة بالمقصود. لذلك ظهرت مرحلة ما بعد التدريب (Post-training) التي تغير سلوك النموذج.
في InstructGPT، جمعت OpenAI أمثلة كتبها بشر، ثم جرى تدريب النموذج على تلك الأمثلة، وبعدها جُمعت مقارنات بشرية بين إجابات مختلفة. دُرّب نموذج مكافأة على تفضيلات المقيمين، ثم استُخدم التعلم المعزز من التقييم البشري (RLHF) لتحسين السياسة التوليدية. اللافت أن نموذجاً أصغر كثيراً يمكن أن يتفوق تفضيلياً على نموذج أكبر عندما يصبح أكثر التزاماً بالنية البشرية.
أما ChatGPT الذي أطلقته OpenAI عام 2022، فاعتمد أيضاً على RLHF مع اختلافات في جمع البيانات وتطبيق المنهج. لذلك لم يكن نجاح ChatGPT نتيجة زيادة المعلمات وحدها. كان تحسين السلوك الحواري جزءاً من المعادلة.
- الضبط المراقَب: يتعلم النموذج من أمثلة كتبها أو راجعها بشر، لتقريب سلوكه من الشكل المرغوب.
- نموذج المكافأة: يتعلم من تفضيلات المقيمين توقع أي إجابة أفضل من أخرى وفق معايير محددة.
- التعلم المعزز: يحسن النموذج سياسته عبر تعظيم إشارة المكافأة باستخدام خوارزميات مثل PPO في منهج InstructGPT المنشور.
- المشكلة المتبقية: تفضيلات البشر لا تعادل الحقيقة العلمية دائماً، وقد تكافئ أحياناً إجابة تبدو مقنعة أكثر من إجابة أقل أناقة لكنها أدق.
لماذا لا تعني كلمة «معلمات أكثر» نموذجاً أذكى دائماً؟
تكشف قوانين التوسع (Scaling Laws) أن أداء النماذج اللغوية يتبع علاقات منتظمة مع حجم النموذج وحجم البيانات وكمية الحوسبة، لكن حجم الشبكة ليس المتغير الوحيد. جودة البيانات، وصفة التدريب، توزيع المهام، وطرق ما بعد التدريب تؤثر كذلك.
وقد أوضح GPT-4 أن OpenAI لم تنشر عدد معلماته ولا تكوينه التفصيلي، لذلك فإن أي رقم متداول على الإنترنت عن «عدد معلمات GPT-4» لا ينبغي عرضه بوصفه حقيقة رسمية. التقرير التقني أكد أنه نموذج مبني على Transformer ومدرب مسبقاً على توقع الرمز التالي، ثم خضع لعملية مواءمة لاحقة.
هنا يجب الفصل بين المعلومة المعلنة والاستنتاج الهندسي. معرفة أن GPT-4 قائم على Transformer لا تكشف عدد الطبقات أو حجم كل طبقة أو تفاصيل مكونات البنية. وهذه الحدود ليست تفصيلاً تحريرياً صغيراً؛ إنها جوهر الدقة عند الحديث عن «تشريح» نماذج تجارية مغلقة.
من GPT-1 إلى GPT-4o: القفزات التي يمكن إثباتها
بدأ المسار الحديث مع GPT الأول الذي جمع بين Transformer والتدريب المسبق غير المراقَب ثم التكيف مع مهام متعددة. وفي GPT-2 أصبح الهدف الأوضح هو التنبؤ بالنص التالي على نطاق أكبر. وفي GPT-3 ظهرت قدرة ملحوظة على تنفيذ مهام عبر أمثلة قليلة داخل السياق من دون تحديث أوزان النموذج.
مع GPT-4 تغير نطاق الإدخال المعلن ليشمل الصور إلى جانب النص، بينما ظل الإخراج نصياً في النظام المعلن. ويؤكد التقرير التقني أن GPT-4 نموذج Transformer كبير متعدد الوسائط، مع عملية مواءمة لاحقة حسنت السلوك المرغوب. وفي عام 2024 قدمت OpenAI GPT-4o بوصفه نموذجاً «omni» يتعامل مع النص والصوت والصورة والفيديو ضمن منظومة متعددة الوسائط.
| النموذج | السنة | المعلمات المُعلَنة | المدخلات المدعومة | الإنجاز الرئيسي الموثَّق | منهج التدريب | ملاحظة |
|---|---|---|---|---|---|---|
| GPT-1 | 2018 | 117 مليون | نص | التدريب المسبق غير المراقَب + التكيف مع مهام متعددة | Transformer + Pre-training | موثق |
| GPT-2 | 2019 | 1.5 مليار | نص | التنبؤ بالنص التالي على نطاق أكبر — توليد نصوص طويلة متماسكة | تنبؤ اللغة الذاتي | موثق |
| GPT-3 | 2020 | 175 مليار | نص | التعلم من أمثلة قليلة داخل السياق (Few-Shot) | تنبؤ اللغة الذاتي بنطاق هائل | موثق |
| InstructGPT | 2022 | غير معلن رسمياً | نص | اتباع التعليمات البشرية عبر RLHF | SFT + Reward Model + PPO | مُوثَّق جزئياً |
| GPT-4 | 2023 | غير معلن رسمياً | نص + صور | نموذج Transformer متعدد الوسائط مع مواءمة متقدمة | Transformer كبير + مواءمة لاحقة | مُوثَّق جزئياً |
| GPT-4o | 2024 | غير معلن رسمياً | نص + صوت + صورة + فيديو | نموذج Omni — نافذة سياق 128,000 رمز | تدريب شامل متعدد الوسائط | Omni |
| GPT-4.1 | 2025 | غير معلن رسمياً | نص + صور | نافذة سياق تصل إلى 1,000,000 رمز في API | تحسينات السياق الطويل | API |
نافذة السياق ليست ذاكرة بشرية
يستخدم مصطلح نافذة السياق (Context Window) لوصف مقدار المعلومات التي يستطيع النموذج استقبالها ضمن سياق طلب معين. يبلغ السياق المعلن لـ GPT-4o في واجهة API نحو 128000 رمز. وفي 2025 رفعت GPT-4.1 السقف إلى مليون رمز في واجهة API، مع تحسينات مخصصة لاستخدام المعلومات داخل السياقات الطويلة.
لكن زيادة السعة لا تعني أن كل جزء من السياق يُستثمر بالفعالية نفسها. أظهرت دراسة «Lost in the Middle» أن أداء نماذج اللغة قد ينخفض عندما توجد المعلومة المطلوبة في منتصف سياق طويل، حتى عند النماذج التي تدعم نوافذ كبيرة. هذه النتيجة تميز بين القدرة على استقبال المعلومات والقدرة على استخدامها بموثوقية.
| وجه المقارنة | نافذة السياق (Context Window) | الذاكرة البشرية |
|---|---|---|
| الطبيعة الأساسية | مساحة حوسبة مؤقتة لكل طلب | نظام ديناميكي حيوي دائم |
| الاستمرارية | تُحذف فور انتهاء الجلسة | تتراكم وتُعاد هيكلتها عبر الزمن |
| السعة القصوى | محددة رقمياً (128,000 – 1,000,000 رمز) | غير محددة بدقة — تعتمد على السياق والتكرار |
| الوصول إلى المعلومات | يتراجع الأداء عند المعلومات الوسطى (Lost in the Middle) | تتأثر بالعواطف والأولويات والتكرار |
| التحديث | لا يتعلم من الجلسة الواحدة — الأوزان ثابتة | تتعلم وتُعاد هيكلتها أثناء النوم والتجربة |
| الموثوقية | حجم السعة لا يضمن جودة الاسترجاع | عرضة للتحريف والنسيان الانتقائي |
| الارتباط بالتجربة | لا تجربة ذاتية — معالجة رقمية بحتة | مرتبطة بالوعي والمشاعر والهوية |
| قابلية القياس | محددة بدقة بالرموز (Tokens) | يصعب قياسها بوحدات موحدة |
| الأداء في السياق الطويل | قد ينخفض مع ازدحام السياق | تعتمد على الترابط العاطفي والأهمية |
المفارقة الرقمية: يمكن أن تتسع نافذة السياق من عشرات الآلاف إلى مئات الآلاف أو مليون رمز، بينما يبقى ترتيب المعلومة داخل السياق عاملاً مؤثراً في استرجاعها. حجم الذاكرة لا يساوي جودة الذاكرة.
ماذا أضافت النماذج متعددة الوسائط؟
التحول من النص إلى الوسائط المتعددة لم يكن إضافة كاميرا إلى نموذج لغوي. في GPT-4o تصف OpenAI النموذج بأنه مدرب بصورة شاملة عبر النص والصورة والصوت، بحيث تمر المدخلات والمخرجات ضمن شبكة عصبية موحدة في التدريب المعلن للنموذج. كما أشارت الشركة إلى زمن استجابة صوتية يصل إلى 232 ميلي ثانية في بعض الحالات، ومتوسط يقارب 320 ميلي ثانية وفق اختبارات الإعلان.
هندسة هذه الأنظمة تفتح طبقة جديدة من مشكلات التعلم. فالنص يحمل البنية الرمزية، بينما يحمل الصوت خصائص زمنية وترددات، وتحمل الصورة علاقات مكانية. لذلك يصبح السؤال التقني أكثر تعقيداً: كيف تشترك تمثيلات مختلفة في مساحة واحدة بما يسمح لنموذج واحد بالانتقال بين الإدخال السمعي والبصري واللغوي؟
في التطبيقات العربية، يزداد التعقيد مع اللهجات والصوتيات والسياق الثقافي. وقد أظهرت أبحاث 2024 أن تقييم النماذج العربية يحتاج إلى مجموعات اختبار مخصصة للغة العربية ومجالاتها المختلفة، لا إلى اختبار ترجمة من معايير إنجليزية فقط.
هل «يفهم» ChatGPT اللغة فعلاً؟
السؤال أدق من أن يجيب عنه لفظ «نعم» أو «لا». إذا كان المقصود الفهم الوظيفي، فإن النموذج يكوّن تمثيلات داخلية تساعده على التنبؤ والشرح والترجمة والاستدلال ضمن نطاق واسع. أما إذا كان المقصود تجربة واعية للمعنى، فلا يقدم تركيب النموذج دليلاً على وجود وعي بشري داخلي.
الأنسب هندسياً هو الحديث عن تمثيل واستدلال احتمالي داخل الشبكة. النموذج يعالج علاقات بين الرموز ويكوّن حالات خفية (Hidden States)، ثم يستخدم تلك الحالات لإنتاج مخرجات. وكلما زاد تعقيد الشبكة، أصبحت العلاقات التي يمكن تمثيلها أكثر ثراءً، لكن ذلك لا يحول الحساب العددي تلقائياً إلى تجربة ذاتية.
من هنا تتضح إحدى أكثر سوءات الفهم شيوعاً. عبارة «النموذج فهم» قد تكون مفيدة في الحديث العملي، لكنها تصبح مضللة إذا استُخدمت لإثبات وجود وعي أو نية بشرية. اللغة البشرية تسمح بضغط مفاهيم تقنية شديدة التعقيد داخل أفعال بسيطة، لكنها لا تلغي البنية الرياضية التي تقف خلفها.
الحد الفاصل: قدرة النموذج على الحفاظ على حوار متماسك لا تثبت بذاتها وجود وعي أو تجربة ذاتية. السلوك اللغوي يمكن أن يكون شديد التعقيد مع بقاء الآلية الحسابية هي الأساس.
كيف تتكون الإجابة لحظة بلحظة؟
بعد وصول السياق، تبدأ السلسلة الحسابية عبر طبقات النموذج. يحصل كل رمز على تمثيل، وتضاف معلومات الموقع، ثم تعمل طبقات الانتباه والشبكات الأمامية. تُعاد النتيجة عبر طبقات متتابعة حتى يصل النموذج إلى تمثيل نهائي يمكن تحويله إلى درجات ترتبط بالمفردات المحتملة.
هذه الدرجات تسمى عادة Logits. بعد تحويلها إلى احتمالات، يمكن لنظام التوليد اختيار الرمز التالي. وإذا كانت الكلمة «الرياض» مثلاً مرشحة بقوة في سياق عربي معين، فقد تحصل على احتمال مرتفع مقارنة بخيارات أخرى. ثم تضاف إلى السياق، ويعاد الحساب.
يمكن تمثيل خسارة التدريب الأساسية بصورة مبسطة بالصيغة التالية:
المعادلة تعني أن التدريب يعاقب النموذج عندما يعطي احتمالاً منخفضاً للرمز الصحيح، ويشجعه عندما يرفع احتماله. ومع مليارات الأمثلة، تتغير المعلمات باستخدام الانتشار العكسي (Backpropagation) وخوارزميات التحسين.
هذه العملية لا تشكل «ذاكرة تسجيلية» لكل نص تدرب عليه النموذج. المعلمات تضغط انتظامات إحصائية في بنية موزعة، ولهذا لا يمكن افتراض أن كل حقيقة تعلمها النموذج مخزنة في مكان واحد يمكن فتحه بسهولة.
من أين تأتي الهلوسة؟
الهلوسة (Hallucination) لا تعني أن النموذج «قرر الكذب». في كثير من الحالات تكون النتيجة الطبيعية لنظام مُحسّن لإنتاج سلسلة رموز عالية الاحتمال، وليس محرك تحقق منطقي يرفض كل ادعاء غير مؤكد.
قد يعرف النموذج أن صيغة معينة شائعة في الإجابات، ثم ينتج اسماً أو تاريخاً أو مرجعاً لأن النمط اللغوي يبدو مناسباً. وقد لا توجد في لحظة التوليد آلية خارجية تجبره على العودة إلى قاعدة حقائق موثوقة. لذلك يمكن أن تكون الجملة ممتازة لغوياً وخاطئة موضوعياً.
أظهر مسح واسع للهلوسة في النماذج اللغوية أن الظاهرة متعددة الأسباب، وتشمل مشاكل في البيانات، وحدود النمذجة، وطبيعة المهام المفتوحة، كما درست أعمال أخرى طرقاً لتمييز حالات عدم اليقين الدلالي. وفي 2024 بحثت دراسة في Nature استخدام «الانتروبيا الدلالية» كمؤشر لتحديد بعض حالات الهلوسة.
الغرابة التي تستحق الانتباه: أفضل إجابة من حيث الصياغة ليست بالضرورة أفضل إجابة من حيث الحقيقة. الطلاقة اللغوية وموثوقية المحتوى مقياسان مختلفان.
المختبر العلمي – وراء سطور الإجابة
العنصر الحسابي الأثقل في المحول هو الانتباه، وخصوصاً عندما يزداد طول السياق. في الصيغة التقليدية، تتوسع كلفة الانتباه مع طول التسلسل بصورة تربيعية من حيث العلاقات الزوجية بين المواضع. لذلك فإن الانتقال من سياق قصير إلى سياق أطول بكثير يضغط على الذاكرة والحوسبة.
أدت هذه المشكلة إلى ظهور تحسينات هندسية مثل FlashAttention، التي تعيد تنظيم طريقة تنفيذ الانتباه داخل ذاكرة GPU دون تغيير النتيجة الرياضية الأساسية. ثم جاء FlashAttention-2 بتحسينات على توزيع العمل والتوازي، وحقق وفق الورقة سرعات أعلى مع استغلال أفضل لمعالجات A100. هذه الأعمال لا تغير مفهوم Transformer فقط؛ إنها تكشف أن نجاح النماذج الحديثة يعتمد على هندسة التنفيذ بقدر اعتماده على المعمارية النظرية.
ويمكن تشبيه الأمر بطريق سريع مزدحم. زيادة عدد السيارات وحدها لا تحل المشكلة. قد يحتاج النظام إلى توزيع المسارات، وتقليل الاختناقات، وتحسين حركة المرور بين أجزاء البنية. وفي الحوسبة العميقة، تعني هذه الاستعارة تحسين تخطيط العمليات والذاكرة والتوازي على العتاد.
لماذا لا تكشف المعلمات وحدها «عقل» النموذج؟
هناك ميل شائع إلى التعامل مع عدد المعلمات باعتباره مقياساً كاملاً للذكاء. هذه قراءة ناقصة. قد يحمل نموذجان العدد نفسه من المعلمات، لكنهما يختلفان في البيانات، وطريقة التدريب، ودقة الأعداد، وتركيب الطبقات، والتدريب اللاحق، والمواءمة، وتقنيات الاستدلال.
كما أن OpenAI لم تنشر بعض التفاصيل المعمارية الخاصة بـ GPT-4، ومنها عدد المعلمات وبنية الطبقات الكاملة. لذا فإن المقارنات التي تعرض جدولاً يضع رقماً مؤكداً لـ GPT-4 ثم تبني عليه تفسيراً للقدرات تتجاوز الأدلة المنشورة. هذه نقطة مهمة لأي كتابة علمية تريد أن تفرق بين المعرفة والتخمين.
من جهة ثانية، حتى مع معرفة جميع الأرقام، يبقى هناك سؤال أعمق. كيف تتوزع الوظائف داخل شبكة بهذا الحجم؟ لا توجد خريطة بشرية مباشرة تقول إن مجموعة معينة من المعلمات هي «مترجم العربية» وأخرى «محرك الرياضيات». بعض الظواهر يمكن تحليلها عبر ميكانيكا التفسير الآلي (Mechanistic Interpretability)، لكن فهم الشبكات الكبيرة لا يزال مجالاً بحثياً مفتوحاً.
خرافات شائعة وحقائق علمية
❌ الخرافة: ChatGPT ينسخ الإجابات من قاعدة بيانات جاهزة.
✅ الحقيقة: النموذج التوليدي يحسب احتمالات للرموز التالية اعتماداً على الحالات الخفية والمعلمات التي تعلمها. وقد تستخدم الأنظمة الخارجية أدوات أو قواعد بيانات أثناء التشغيل، لكن ذلك ليس تعريف النموذج اللغوي نفسه.
❌ الخرافة: كلما زادت المعلمات أصبح النموذج أذكى تلقائياً.
✅ الحقيقة: الحجم مهم، لكن البيانات والحوسبة والمنهجية التدريبية وما بعد التدريب تؤثر جميعها في الأداء. وتظهر أبحاث قوانين التوسع أن العلاقة أكثر تركيباً من مجرد عدّ المعلمات.
❌ الخرافة: نافذة سياق مليون رمز تعني ذاكرة دقيقة لمليون رمز.
✅ الحقيقة: السعة القصوى تحدد ما يمكن إدخاله، لكنها لا تضمن استخدام كل معلومة بالفعالية نفسها. أبحاث السياق الطويل وثقت تراجع الأداء عند وجود المعلومات في مواضع وسطية من السياق.
❌ الخرافة: الهلوسة تعني أن النموذج يكذب عمداً.
✅ الحقيقة: الهلوسة ظاهرة توليدية يمكن أن تنشأ من التنبؤ الاحتمالي، وحدود البيانات، وضعف التحقق الخارجي، ومشكلات تمثيل عدم اليقين.
❌ الخرافة: GPT-4o مجرد GPT-4 أسرع مع ميكروفون وكاميرا.
✅ الحقيقة: أعلنت OpenAI GPT-4o كنموذج متعدد الوسائط مدرب بصورة شاملة عبر النص والصورة والصوت، مع بنية تشغيلية مختلفة في تجربة التفاعل مقارنة بالنماذج النصية السابقة.
ماذا تكشف السنوات 2023–2025 عن الاتجاه القادم؟
ظهرت خلال هذه السنوات محاولات لتخفيف أحد أضعف جوانب المحولات: كلفة معالجة التسلسلات الطويلة. قدم بحث Mamba في 2023 بنية تعتمد على نماذج فضاء الحالة الانتقائية (Selective State Space Models)، وناقش قدرة هذه البنية على تحقيق تحجيم خطي مع طول التسلسل في بعض السيناريوهات، مع أداء قوي في مهام تسلسلية. لا يعني ذلك أن Transformer انتهى؛ بل يعني أن عائلة البدائل أصبحت أكثر جدية.
وفي الاتجاه نفسه، دفعت تحسينات تنفيذ الانتباه مثل FlashAttention-2 إلى زيادة كفاءة المحولات نفسها بدلاً من التخلي عنها. لذلك يبدو المستقبل أقرب إلى منافسة بين عائلات معمارية وتحسينات هجينة، لا إلى استبدال مفاجئ لنموذج واحد بآخر.
يمكن أن تشمل المنظومات المقبلة نماذج هجينة تجمع الانتباه مع حالات داخلية أكثر كفاءة، أو شبكات تستخدم خبراء متخصصين (Mixture of Experts)، أو آليات استرجاع خارجي، أو بنى متخصصة للاستدلال متعدد المراحل. ويبقى اختبار الفائدة الفعلية أهم من أناقة الاسم المعماري.
التطبيقات التي خرجت من المختبر إلى الواقع
تدخل تقنية ChatGPT في التعليم والتحرير والبرمجة وخدمة العملاء والتحليل والبحث الأولي. وفي الشركات العربية يمكن أن تظهر في تلخيص المستندات، وتصنيف الشكاوى، وبناء مسودات الردود، واستخراج معلومات من وثائق طويلة، والمساعدة في كتابة الشفرة البرمجية، وترجمة المواد بين العربية والإنجليزية.
في المناطق العربية، تصبح اللغة نفسها عنصراً اقتصادياً في التصميم. فالنظام الذي يتعامل جيداً مع العربية الفصحى قد يحتاج إلى تدريب وتقييم مختلفين عند التعامل مع اللهجة السعودية أو المصرية أو المغربية. وقد أظهرت أعمال عربية حديثة أن النماذج المفتوحة والمغلقة قد تختلف بوضوح بين المهام العربية، وهو ما يدعم الحاجة إلى اختبارات محلية بدلاً من الاكتفاء بمعايير عامة.
في التطبيقات البحثية، تُستخدم النماذج اللغوية داخل أدوات الاسترجاع والتلخيص وتحليل النصوص العلمية، لكن القيمة العملية ترتفع عندما يرتبط النموذج بمصدر خارجي يمكن التحقق منه. وهنا تظهر هندسة RAG، أي التوليد المعزز بالاسترجاع (Retrieval-Augmented Generation)، التي تضيف معلومات مسترجعة من قاعدة أو محرك بحث إلى سياق النموذج قبل التوليد.
أما في الحياة اليومية، فقد يظهر المبدأ في صياغة بريد، أو شرح قطعة كود، أو تحليل جدول، أو تلخيص ملف طويل. لكن كل استخدام يعتمد على طبيعة الخطأ المقبول. الخطأ في رسالة غير رسمية مختلف جذرياً عن الخطأ في تقرير قانوني أو مالي.
قيد علمي: بعض التطبيقات المتقدمة للنماذج متعددة الوسائط والوكلاء الذكيين لا تزال تتغير بسرعة، ولا يصح عرض نتائج البحث الأولية أو العروض التجريبية على أنها قدرات مستقرة في جميع البيئات.
اقرأ أيضاً:
- تطبيقات الذكاء الاصطناعي في علم الأدوية: التحديات والفرص
- الثورة الصناعية الرابعة: الدليل العلمي الشامل للتقنيات التي تعيد صياغة مستقبل البشرية
مدخل الطالب والهاوي: من أين تبدأ البنية الهندسية؟
فهم خوارزمية شات جي بي تي لا يحتاج إلى البدء بحفظ أسماء النماذج. المدخل الأقوى هو بناء أساس رياضي وبرمجي يسمح بفهم ما يجري داخل الطبقات.
- الجبر الخطي: المتجهات والمصفوفات وضرب المصفوفات ضرورية لفهم الانتباه والتضمينات.
- الاحتمالات: التوزيعات والاحتمال الشرطي وSoftmax ضرورية لفهم التنبؤ بالرمز التالي.
- التفاضل: المشتقات والانتشار العكسي يفسران كيف تتغير المعلمات أثناء التدريب.
- البرمجة: Python وأطر التعلم العميق مثل PyTorch تمنح مدخلاً عملياً إلى بناء نماذج مصغرة.
- معالجة اللغة: التقطيع والتضمين والسياق والتقييم تساعد على فهم المشكلة قبل النظر إلى المعمارية.
الخطأ الشائع بين المبتدئين هو البدء بالسؤال «كم عدد المعلمات؟». السؤال الأفضل هو «ما المهمة التدريبية؟ وما التمثيل الذي يستخدمه النموذج؟ وما الذي تغير في بيانات التدريب وما بعد التدريب؟». بهذا الترتيب يصبح الرقم جزءاً من القصة، لا القصة كلها.
الخطة العملية لفك شفرة المحول
- بناء Transformer صغير: تنفيذ نموذج بسيط على نص قصير يكشف عملياً كيف تتحرك الرموز عبر الطبقات.
- فحص الانتباه: عرض مصفوفات الانتباه يساعد على رؤية العلاقات العددية، مع الحذر من اعتبارها تفسيراً كاملاً لسلوك النموذج.
- تجربة Tokenization العربية: مقارنة الجملة نفسها بالفصحى واللهجة واللغة المختلطة تكشف أثر التقطيع على عدد الرموز.
- قياس السياق: وضع المعلومة نفسها في بداية النص ووسطه ونهايته يوضح مشكلة استرجاع المعلومات الطويلة.
- اختبار الهلوسة: بناء مجموعة صغيرة من الحقائق القابلة للتحقق ثم مقارنة الاستجابات يبيّن الفرق بين الطلاقة والدقة.
- إضافة RAG: ربط النموذج بمصدر موثوق يسمح بدراسة الفرق بين التوليد من الأوزان والتوليد المدعوم بمعلومات مسترجعة.
هذه الخطوات لا تكشف الأسرار التجارية لنماذج مغلقة، لكنها تبني نموذجاً ذهنياً قريباً من الآلية الفعلية. والأهم أنها تمنع الخلط بين سلوك الواجهة والبنية الرياضية التي تنتج السلوك.
كيف ترتبط تقنية ChatGPT بفروع علمية أخرى؟
يرتبط المجال بالرياضيات ارتباطاً مباشراً، لأن الانتباه والتحديث والتوليد كلها عمليات على متجهات ومصفوفات واحتمالات. وترتبط هندسة الذكاء الاصطناعي بعلم الحاسوب من خلال تصميم المترجمات، وإدارة الذاكرة، والتوازي، وجدولة المعالجة على وحدات GPU.
كما تدخل نظرية المعلومات في فهم عدم اليقين ومقاييس الخسارة والإنتروبيا. ويظهر الارتباط بمعالجة الإشارة في النماذج الصوتية متعددة الوسائط، بينما يتقاطع المجال مع علوم اللغة في الصرف والدلالة والنحو وتنوع اللهجات.
وفي البحث الحديث يظهر مسار آخر هو قابلية التفسير (Interpretability). هذا المجال يحاول معرفة كيف تنشأ الوظائف داخل الشبكات، وما إذا كان من الممكن تحديد دوائر حسابية أو تمثيلات داخلية مرتبطة بمهام معينة. وهو يربط التعلم العميق بالتحليل التجريبي للنظم المعقدة.
اقرأ أيضاً:
- أمن المعلومات: الدليل العلمي الشامل لحماية البيانات ومواجهة التهديدات السيبرانية
- تكنولوجيا المعلومات والاتصالات (ICT): المفهوم، المكونات، والدور
لماذا لا يكفي السياق الطويل؟
توسيع السياق يحل مشكلة واضحة: يمكن للنظام استقبال وثائق أطول. لكنه لا يضمن استخداماً مثالياً للمعلومات. وقد أظهرت دراسة منشورة في Transactions of the Association for Computational Linguistics أن دقة الاسترجاع يمكن أن تتراجع عندما توجد المعلومة المطلوبة في منتصف السياق الطويل.
هذا يفسر مشكلة تبدو مألوفة في المحادثات الطويلة. قد يظهر الرد الأول دقيقاً، ثم يبدأ النظام بدمج معلومات بعيدة بطريقة أقل كفاءة مع زيادة عدد الرسائل. ليس السبب دائماً «نسياناً» بالمعنى البشري، بل قد تكون المشكلة في توزيع الانتباه، أو ازدحام السياق، أو تضارب المعلومات، أو فقدان الإشارة إلى العناصر الأهم.
توسيع نافذة السياق يظل مفيداً، لكنه ليس حلاً وحيداً. ولذلك تستمر الأبحاث في تحسين الاسترجاع، وترتيب السياق، والضغط المعلوماتي، وطرق اختيار ما يجب إرساله إلى النموذج أصلاً.
الدرس الهندسي: زيادة الذاكرة دون تحسين آلية الوصول إليها تشبه توسيع مستودع ضخم دون تحسين نظام الفهرسة. السعة مهمة، لكن الوصول الموثوق أهم في كثير من التطبيقات.
التوصية العلمية من موقعنا
- التمييز بين النموذج والنظام: ChatGPT ليس دائماً نموذجاً واحداً يعمل منفرداً؛ قد تتضمن التجربة أدوات وطبقات استرجاع ومعالجة ومدخلات متعددة الوسائط.
- تتبع المصدر قبل الثقة: عند التعامل مع معلومة واقعية، يصبح وجود مصدر خارجي قابلاً للتحقق أقوى من الطلاقة اللغوية وحدها.
- دراسة العربية كمجال مستقل: لا يكفي نقل نتائج اختبارات الإنجليزية إلى العربية؛ اختلاف الصرف واللهجات والبيانات يحتاج إلى تقييمات مخصصة.
- عدم اختزال الذكاء في المعلمات: جودة التدريب والبيانات والمواءمة والتنفيذ الحاسوبي قد تغير النتيجة بصورة كبيرة.
- فهم حدود السياق: السياق الطويل ليس ذاكرة بشرية كاملة، ونتائج أبحاث «Lost in the Middle» تستحق الدراسة لأي مشروع يعتمد على ملفات طويلة.
- متابعة البدائل المعمارية: Mamba ونماذج فضاء الحالة تشير إلى أن مستقبل نمذجة التسلسلات قد يتضمن بدائل أو هياكل هجينة إلى جانب Transformer.
- تعلم التنفيذ لا النظرية فقط: فهم بنية GPU والذاكرة والتوازي يفسر لماذا يمكن لتحسينات مثل FlashAttention أن تغير تكلفة النموذج من دون تغيير مفهوم الانتباه نفسه.
ماذا يمكن أن يفعل الذكاء الاصطناعي العربي بصورة أفضل؟
المشكلة العربية ليست في نقص الكلمات فقط. هناك حاجة إلى بيانات تعليمات أصلية، ولهجات ممثلة بصورة متوازنة، نصوص قانونية وتقنية وأدبية عالية الجودة، واختبارات تقيس الدقة الثقافية واللغوية معاً.
أظهرت AceGPT مثلاً توجهاً إلى تدريب إضافي على النصوص العربية، وضبط مراقَب بتعليمات عربية، واستخدام ملاحظات مرتبطة بالسياق الثقافي، بهدف بناء نموذج أكثر ملاءمة للمستخدم العربي. لا يعني ذلك أن منهجاً واحداً حُسمت صلاحيته، لكنه يوضح اتجاهاً بحثياً مهماً: التخصيص اللغوي والثقافي قد يحتاج إلى أكثر من مجرد زيادة حجم النموذج.
وهناك جانب آخر يتعلق بالشفافية. في المنطقة العربية، ستحتاج الجهات التي تستخدم النماذج في التعليم والقانون والخدمات العامة إلى قواعد واضحة للتحقق، لأن الاعتماد على نموذج لغوي وحده قد ينقل أخطاء تبدو احترافية إلى قرارات واقعية. وفي المقابل، يمكن لاستخدام النموذج كطبقة مساعدة فوق مصادر موثوقة أن يقدم مكاسب كبيرة في السرعة والوصول إلى المعرفة.
اقرأ أيضاً:
أين يقف GPT-4o داخل هذا المسار؟
GPT-4o مهم هندسياً لأنه أبرز انتقالاً من نموذج يتعامل مع النص بوصفه الوسيط الرئيس إلى منظومة متعددة الوسائط بواجهة أقرب إلى المحادثة الطبيعية. تصف OpenAI النموذج بأنه يستقبل مجموعات من النص والصوت والصورة والفيديو وينتج مخرجات عبر هذه الوسائط ضمن نموذج omni واحد في التدريب المعلن. كما أبلغت الشركة عن تحسينات في اللغات غير الإنجليزية مقارنةً بالنماذج السابقة.
لكن أهمية GPT-4o لا تعني أن بنيته الداخلية أصبحت مكشوفة. ما هو منشور عن الأداء والبيانات العامة وبعض خصائص النظام لا يكفي لإعادة بناء المعمارية الكاملة، ولا يبرر اختلاق عدد المعلمات أو عدد الرؤوس أو حجم كل طبقة. وهذه نقطة يجب أن تبقى واضحة في أي «تشريح» تقني للنماذج التجارية.
في المقابل، قدمت GPT-4.1 عام 2025 مؤشراً واضحاً على أحد محاور المنافسة المستمرة: القدرة على التعامل مع سياق يصل إلى مليون رمز في واجهة API وتحسين استخدام ذلك السياق. هذا يعكس اتجاه الصناعة نحو الذاكرة الطويلة وفهم الوثائق الكبيرة، لا مجرد زيادة جودة الإجابة في محادثة قصيرة.
هل وصل Transformer إلى سقف هندسته؟
يصعب الدفاع عن فكرة أن Transformer وصل إلى نهاية الطريق. السبب الأول أن المعمارية ما زالت تتحسن على مستوى التنفيذ. والسبب الثاني أن مشكلات السياقات الطويلة والكفاءة والطاقة والاستدلال لم تُحل بصورة نهائية. والسبب الثالث أن ظهور بدائل مثل نماذج فضاء الحالة يعني أن البحث لا يزال مفتوحاً على مستويات مختلفة.
في المقابل، لا يوجد دليل علمي يفرض أن Transformer سيُستبدل بالكامل في جيل واحد. قد يكون المسار الأكثر واقعية هو الهجنة: انتباه حيث يكون الوصول المرن ضرورياً، وآليات خطية أو متكررة عند التعامل مع تسلسلات شديدة الطول، واسترجاع خارجي عندما تكون المعرفة المتغيرة أكثر ملاءمة لقاعدة بيانات، وربما وحدات تخصصية للنص والصوت والرؤية.
قد تنتقل المنافسة القادمة من سؤال «من لديه نموذج أكبر؟» إلى أسئلة أكثر هندسية: من يحقق أفضل كفاءة؟ من يستخدم الذاكرة الطويلة بثبات؟ من يراقب مصادر المعرفة؟ من يستطيع تفسير الأخطاء؟ ومن يبني نظاماً يستطيع فصل المعرفة عن التخمين؟
وهنا تظهر الحدود الحقيقية لتقنية ChatGPT. القوة ليست في أن النموذج «يعرف كل شيء»، بل في أن بنية حسابية واسعة استطاعت تعلم أنماط شديدة التعقيد من البيانات، ثم تحويلها إلى سلوك لغوي مفيد. والضعف المقابل هو أن النظام نفسه قد ينتج إجابة متماسكة عندما تكون الأدلة ناقصة، ما لم تضبطه أدوات التحقق أو مصادر خارجية.
المفارقة الأخيرة: كلما أصبحت النماذج أكثر إقناعاً في الكلام، ازدادت أهمية آليات التحقق خارج الكلام نفسه. الطلاقة تخفف المسافة بين الآلة والإنسان لغوياً، لكنها لا تلغي الفرق بين التنبؤ الاحتمالي والمعرفة الموثقة.
إن مستقبل النماذج اللغوية لا يبدو محصوراً في مضاعفة عدد المعلمات، بل في هندسة منظومات تجمع بين التمثيل، والاستدلال، والذاكرة، والاسترجاع، والكفاءة الحاسوبية، والتعامل متعدد الوسائط. وعندما تصبح هذه العناصر أكثر ترابطاً، قد يتغير تعريف «النموذج» نفسه من شبكة عصبية منفردة إلى نظام حسابي واسع يعمل حولها. ويبقى السؤال المفتوح: أي بنية ستكون الأقدر على الجمع بين المرونة اللغوية، وكفاءة الحوسبة، والموثوقية التي لا تسمح للطلاقة بأن تتقدم على الحقيقة؟
اقرأ أيضاً:
- الحاسوب الكمي: الدليل العلمي الشامل لفهم تكنولوجيا المستقبل وتأثيرها المرعب على العالم
- أشباه الموصلات: العصب الخفي للتكنولوجيا وكيف تقود مستقبل البشرية
يستند هذا المقال إلى أحدث الأوراق البحثية والتقارير التقنية والمعايير الرسمية المعتمدة في مجال نماذج اللغة الكبيرة:
- OpenAI Technical Reports (2023–2025) — التقارير التقنية الرسمية لنماذج GPT-4 وGPT-4o وGPT-4.1
- IEEE Standards for AI Systems — معايير IEEE P7000 الخاصة بأنظمة الذكاء الاصطناعي والشفافية
- ACL / NeurIPS / ICML Proceedings — المؤتمرات الدولية المحكّمة لمعالجة اللغات الطبيعية والتعلم الآلي
- NIST AI Risk Management Framework (AI RMF 1.0) — إطار إدارة مخاطر الذكاء الاصطناعي الصادر عن المعهد الوطني للمعايير والتقنية
- EU AI Act (2024) — اللائحة الأوروبية للذكاء الاصطناعي وتصنيف المخاطر
- Hugging Face Model Cards Standards — معايير توثيق النماذج وبطاقات النماذج المفتوحة
- LAraBench Framework (EACL 2024) — إطار التقييم العربي الشامل لنماذج اللغة الكبيرة
المصادر والمراجع
- Vaswani, A., Shazeer, N., Parmar, N., et al. (2017). Attention Is All You Need. arXiv. الورقة البحثية الأصلية للمحولات
الفكرة الأساسية: تقديم بنية Transformer المعتمدة على الانتباه بدلاً من التكرار. - Radford, A., et al. (2018). Improving Language Understanding by Generative Pre-Training. OpenAI. مصدر OpenAI عن التدريب المسبق التوليدي
الفكرة الأساسية: الجمع بين المحولات والتدريب المسبق غير المراقَب للنماذج اللغوية. - Radford, A., et al. (2019). Language Models are Unsupervised Multitask Learners. OpenAI. مصدر OpenAI عن GPT-2
الفكرة الأساسية: استخدام التنبؤ بالنص التالي لتعلم مهام لغوية متعددة دون تدريب منفصل لكل مهمة. - Brown, T. B., et al. (2020). Language Models are Few-Shot Learners. NeurIPS 2020. الورقة في NeurIPS
الفكرة الأساسية: توضيح أثر التوسع في GPT-3 وقدرته على التعلم من أمثلة قليلة داخل السياق. - Ouyang, L., et al. (2022). Training Language Models to Follow Instructions with Human Feedback. arXiv. الورقة العلمية حول InstructGPT وRLHF
الفكرة الأساسية: وصف منهج التدريب بالتغذية الراجعة البشرية لتحسين اتباع التعليمات. - OpenAI. (2023). GPT-4 Technical Report. arXiv. التقرير التقني لـ GPT-4
الفكرة الأساسية: توثيق GPT-4 كنموذج Transformer متعدد الوسائط مع تفاصيل محدودة عمداً حول البنية الداخلية. - Liu, N. F., Lin, K., Hewitt, J., et al. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, 12, 157–173. الدراسة في ACL Anthology
الفكرة الأساسية: إظهار أن موضع المعلومات داخل السياق الطويل يؤثر في قدرة النموذج على استخدامها. - Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting Hallucinations in Large Language Models Using Semantic Entropy. Nature, 630, 625–630. الدراسة في Nature
الفكرة الأساسية: بحث منهج لقياس عدم اليقين الدلالي للكشف عن بعض حالات الهلوسة. - Huang, H., Yu, F., Zhu, J., et al. (2024). AceGPT, Localizing Large Language Models in Arabic. Proceedings of NAACL 2024. الدراسة في ACL Anthology
الفكرة الأساسية: دراسة تكييف النماذج الكبيرة مع العربية وسياقاتها الثقافية. - Abdelali, A., Mubarak, H., Chowdhury, S. A., et al. (2024). LAraBench: Benchmarking Arabic AI with Large Language Models. Proceedings of EACL 2024. الدراسة في ACL Anthology
الفكرة الأساسية: بناء إطار واسع لتقييم النماذج على مهام عربية متعددة. - Dao, T. (2023). FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. arXiv. البحث حول تحسين تنفيذ الانتباه
الفكرة الأساسية: تحسين التنفيذ الحاسوبي للانتباه لرفع السرعة والكفاءة. - Gu, A., & Dao, T. (2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces. arXiv. البحث حول نماذج فضاء الحالة الانتقائية
الفكرة الأساسية: تقديم بنية بديلة للمحولات تستهدف الكفاءة في التسلسلات الطويلة. - OpenAI. (2024). GPT-4o System Card. OpenAI. بطاقة نظام GPT-4o
الفكرة الأساسية: توثيق قدرات GPT-4o وبيانات التدريب والمخاطر والتقييمات المعلنة. - OpenAI. (2025). Introducing GPT-4.1 in the API. OpenAI. إعلان GPT-4.1 وسياقه الطويل
الفكرة الأساسية: توثيق نافذة سياق تصل إلى مليون رمز وتحسينات فهم السياقات الطويلة.
قراءات إضافية ومصادر للتوسع
Jared Kaplan et al. (2020), Scaling Laws for Neural Language Models. الورقة حول قوانين التوسع
لماذا نقترح عليك قراءته؟ لأنها تقدم الأساس الكمي لفهم العلاقة بين حجم النموذج والبيانات والحوسبة والأداء.
Javier Ferrando et al. (2023), Explaining How Transformers Use Context to Build Predictions. الدراسة في ACL Anthology
لماذا نقترح عليك قراءته؟ لأنها تنتقل من سؤال «ماذا يفعل النموذج؟» إلى سؤال أكثر دقة: كيف تؤثر الكلمات والسياقات في التنبؤ عبر طبقات Transformer؟
Nelson F. Liu et al. (2024), Lost in the Middle: How Language Models Use Long Contexts. النص الكامل في ACL Anthology
لماذا نقترح عليك قراءته؟ لأنه يقدم تجربة مباشرة لفهم الفارق بين امتلاك نافذة سياق طويلة والقدرة الفعلية على استغلالها بكفاءة.
موقع خلية لا يتحمل أي مسؤولية قانونية أو مهنية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين أو الوثائق الرسمية للجهات المعنية.
د. بلال الهندي — أستاذ الفيزياء النووية والنمذجة الحسابية
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات