رؤية الحاسوب: كيف تفهم الآلات الصور والعالم المرئي؟
من تحليل البكسلات واكتشاف الأجسام إلى فهم المشاهد وتتبع الحركة وإعادة بناء العالم ثلاثي الأبعاد.

رؤية الحاسوب (Computer Vision) مجال علمي يُعنى باستخلاص معلومات من الصور ومقاطع الفيديو وغيرها من البيانات المرئية: ما الذي يظهر فيها، وأين يقع، وما حدوده، وكيف يتحرك، وما علاقته بما حوله، وفي بعض المهام ما بعده عن الكاميرا وكيف يمكن إعادة بناء شكله في الفضاء. حين تلتقط كاميرا صورة لشارع، يميّز الإنسان السيارات من المشاة، ويقرأ إشارة المرور، ويقدّر أن سيارة قريبة من ممر المشاة وأن أخرى أبعد في المسار المجاور. الحاسوب لا يتلقى هذا المعنى جاهزًا. يتلقى مصفوفة أرقام تصف شدة الضوء في كل موضع. عمل رؤية الحاسوب هو تحويل تلك الأرقام إلى أوصاف يمكن لنظام آخر أن يستخدمها: اسم فئة، أو مربع يحيط بجسم، أو قناع يرسم حدوده، أو مسار حركة، أو تقدير للعمق.
هذا الفرق بين استقبال صورة وبين تفسيرها هو مدار المجال كله. والكلمة «رؤية» هنا لا تعني أن الآلة تبصر كما يبصر الإنسان، بل أن لديها إجراءات حسابية تستنتج معلومات عن مشهد من بيانات بصرية. والمجال متعدد التخصصات؛ فهو يجمع معالجة الصور، وتعلم الآلة، والهندسة الرياضية للكاميرا، وأحيانًا الروبوتات والاستشعار عن بُعد. يمكن بناء بعض أنظمته بقواعد هندسية من دون تعلم عميق، بينما تعتمد أنظمة حديثة كثيرة على شبكات تتعلم أنماطها من بيانات موسومة.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات
- حوّل الصورة إلى أرقام: الآلة لا ترى مشهداً، بل مصفوفة قيم (pixels) تستخرج منها المعنى.
- ميّز المهام السبع: التصنيف، الاكتشاف، التقسيم، التتبع، تقدير الوضعية، قراءة الحروف، فهم المشاهد.
- اتبع المسار: جمع الصور، معالجة مسبقة، استخراج الخصائص، تحليل، ثم النتيجة.
- قارن النموذجين: CNN يلتقط الأنماط المحلية، وViT يقسم الصورة إلى رقع 16×16 ويربطها بالانتباه الذاتي.
- استنتج العمق: التفاوت بين كاميرتين يكشف المسافة، لأن صورة واحدة لا تكفي.
- قِس الاكتشاف: معيار IoU يقارن مربع الحقيقة بمربع التنبؤ.
- قسّم الصور والفيديو: نموذج SAM 2 مثال حديث.
- في 2012 خفّض AlexNet الخطأ إلى 15.3% مقابل 26.2% للمنافس التالي، فبدأ عصر التعلم العميق في الرؤية.
- تضم SA-V نحو 35.5M قناع في 50.9K فيديو.
- لا تعمّم الأرقام خارج مجموعات بياناتها وظروفها، واستشر مختصاً قبل استخدامها في السلامة أو المراقبة أو تحديد الهوية.
رؤية الحاسوب باختصار
رؤية الحاسوب تمكّن الحاسوب من استخلاص معلومات عن الأشياء والخصائص والعلاقات من الصور والفيديو. تبدأ المنظومة عادة من كاميرا أو مستشعر يحوّل الضوء، أو إشعاعًا آخر، إلى بيانات رقمية، ثم تعالج خوارزميات هذه البيانات بحسب المهمة: تصنيف صورة، أو اكتشاف أجسام وتحديد مواضعها، أو رسم حدودها، أو تتبعها عبر الزمن، أو قراءة نص ظاهر فيها، أو وصف علاقات داخل مشهد.
يرتبط المجال بالذكاء الاصطناعي وتعلم الآلة والتعلم العميق ارتباطًا وثيقًا في أنظمته الحديثة، لكنه لا يُختزل فيها. ما زالت أساليب معالجة الصور والهندسة البصرية تُستخدم وحدها في مهام مضبوطة، أو تُدمَج مع النماذج المتعلمة حين يلزم قياس أو إعادة بناء ثلاثية الأبعاد. وتظهر التطبيقات في المركبات، والروبوتات، وخطوط الإنتاج، والزراعة، وتحليل الصور الفضائية، والهاتف، والبحث العلمي.
الأنظمة المتقدمة قد تقدّر العمق والحركة وتعيد بناء أجسام وبيئات، غير أن الصورة الواحدة تفقد جزءًا من المعلومات المكانية، والنتيجة تتأثر بجودة الالتقاط والإضاءة وما تدرب عليه النموذج. النجاح على مجموعة اختبار لا يضمن الدقة نفسها في شارع أو مصنع أو حقل لم يُمثَّل في التدريب.
اقرأ أيضاً:
- علم البيانات: الركيزة العلمية لقيادة الذكاء الاصطناعي وصناعة القرار
- كيف ترى الحيوانات العالم؟ مشاهد مختلفة وراء العيون
نقاط جوهرية
- الاستخلاص لا العرض: رؤية الحاسوب تجعل الحاسوب قادرًا على استخلاص معلومات ذات معنى من البيانات المرئية، لا على تحسين الصورة فحسب.
- ما بعد الاسم: المجال لا يتوقف عند التعرف على الأشياء، بل يشمل مواضعها وأشكالها وحركتها وعلاقاتها المكانية، وقد يمتد إلى العمق والبنية الثلاثية.
- معالجة الصور غير التفسير: معالجة الصور تهتم غالبًا بتحويل الصورة وتحسينها، بينما تسعى رؤية الحاسوب إلى استنتاج معلومات عن محتواها.
- التعلم العميق ليس شرطًا: ليست كل أنظمة رؤية الحاسوب مبنية على شبكات عميقة، وإن كانت هذه الشبكات قد غيّرت أداء مهام كثيرة.
- بنيتان بارزتان: الشبكات العصبية الالتفافية والمحولات البصرية من أهم البنى في الأنظمة الحديثة، ولكل منهما ظروف تتفوق فيها.
- البيانات جزء من النظام: جودة بيانات التدريب وتنوعها وتوازن فئاتها تؤثر في قدرة النموذج على التعميم، إلى جانب تصميم الشبكة.
- الاختبار ليس العالم: نتيجة مرتفعة على مجموعة اختبار محددة لا تعني أن النظام سيصمد في كل إضاءة وكل كاميرا وكل بلد.
- البعد الثالث ممكن ومشروط: يمكن استنتاج معلومات ثلاثية الأبعاد من الصور، لكن ذلك يحتاج إلى هندسة كاميرا، أو مناظر متعددة، أو حركة، أو فروض تعلمية، ولا ينتج تلقائيًا من تصنيف الصورة.
ما رؤية الحاسوب، وكيف تستطيع الآلات فهم الصور؟
تعريف رؤية الحاسوب
في الأدبيات المعاصرة، تُعالَج رؤية الحاسوب بوصفها علمًا وهندسة لاستعادة معلومات عن العالم من صوره، لا بوصفها فرعًا واحدًا من تصنيف الصور. كتاب Foundations of Computer Vision الذي أصدرته مطبعة معهد ماساتشوستس للتقانة عام 2024، من تأليف أنطونيو تُورالبا وفيليب إيسولا وويليام فريمان، يضع المسألة على هذا الاتساع: جذورها أقدم من التعلم العميق، ومناهج اليوم تمتد إليها، والرؤية نفسها ليست مجرد تطبيق لتعلم الآلة على مصفوفات. والمعنى المقصود بكلمة الرؤية في هذا السياق هو الاستدلال البصري: استخراج وصف يمكن استخدامه، من إشارة التقطها مستشعر.
استقبال صورة رقمية يحدث لحظة تحويل الضوء إلى قيم. تفسير المحتوى يبدأ بعد ذلك، حين نسأل إن كانت هذه القيم تدل على سيارة أو على ظل، وإن كان الجسم كاملًا أم محجوبًا، وإن كان قريبًا أم بعيدًا. لذلك تُعَدّ رؤية الحاسوب متعددة التخصصات. الرياضيات تصف الإسقاط والعدسات، ومعالجة الإشارة تنظف القياس، وتعلم الآلة يربط الأنماط بالفئات، والهندسة تربط الصورة بحركة روبوت أو بمركبة. لا يكفي تخصص واحد لتغطية السلسلة من المستشعر إلى القرار.
ماذا يعني أن يفهم الحاسوب صورة؟
الحاسوب لا يرى الصورة بالطريقة البشرية. ليست لديه خبرة جسدية بالشارع، ولا يدرك المعنى الاجتماعي لإشارة حمراء إلا إذا صِيغت تلك المعرفة مهمة قابلة للحساب. ما يفعله هو معالجة تمثيل رقمي، واستخراج أنماط وخصائص تُستخدم للاستدلال. «الفهم» هنا اسم عملي لنجاح مهمة محددة، لا مرادف للوعي.
يمكن للنظام، بحسب ما صُمم له، أن يخرج بهوية فئة ينتمي إليها جسم، وبموضع هذا الجسم وحدوده داخل الصورة، وبشكله وحجمه الظاهري لا حجمه المتري بالضرورة، وبلونه وملمسه، وبموقعه بالنسبة إلى أجسام أخرى، وبحركته بين إطارات فيديو، وبتقدير للمسافة عن الكاميرا إذا توفرت الهندسة أو النموذج المناسب. كل مخرج من هذه المخرجات إجابة عن سؤال مختلف. معرفة أن الصورة «تحتوي سيارة» لا تقول إن السيارة خلف مركبة أخرى، ولا إنها على بُعد ثلاثة أمتار من أحد المشاة. هذا الفرق بين اكتشاف الجسم وفهم المشهد هو ما يمنع اختزال المجال في التعرف على الأسماء.
ما المدخلات والمخرجات؟
المدخل الأكثر شيوعًا صورة رقمية أو سلسلة إطارات فيديو. وقد تأتي الصور من كاميرا واحدة، أو من كاميرات متعددة العدسات تعطي مناظر مختلفة للمشهد نفسه، أو من مستشعر عمق يقيس المسافة مباشرة، أو من تصوير متعدد الأطياف أو فائق الأطياف يسجل نطاقات ضيقة من الإشعاع، أو من كاميرا حرارية تسجل الأشعة تحت الحمراء. رؤية الحاسوب لا تشترط أن تكون الصورة ملونة ومألوفة للعين.
والمخرجات تتبع السؤال. قد تكون تسمية لصورة كاملة، أو إحداثيات مربع إحاطة حول جسم مع اسم فئته ودرجة ثقة، أو قناعًا يُسند إلى كل بكسل فئة أو هوية جسم، أو نقاطًا مفتاحية تصف وضعية، أو مسارًا يربط الجسم عبر الزمن، أو خريطة عمق وتمثيلًا ثلاثي الأبعاد، أو نصًا استُخرج من لافتة أو وثيقة. الخلط بين هذه المخرجات هو مصدر كثير من سوء الفهم عند الحكم على نظام بأنه «يعرف الصور».
ما الفرق بين رؤية الحاسوب والمجالات القريبة منها؟
الحدود بين هذه المجالات ليست جدرانًا. نظام صناعي واحد قد يضيء قطعة، ويزيل التشويش، ثم يقيس حافة، ثم يرفض القطعة. ومع ذلك يبقى التمييز مفيدًا حتى لا يُظن أن كل معالجة لصورة هي فهم لمشهد، أو أن كل رسم حاسوبي هو تحليل للواقع.
| المجال | السؤال الذي يجيب عنه في الأغلب | اتجاه العمل |
|---|---|---|
| معالجة الصور الرقمية | كيف نحوّل الصورة أو نحسّنها أو نزيل تشويشها أو نستخرج منها خصائص أولية؟ | من صورة إلى صورة أو إلى وصف رقمي منخفض المستوى |
| رؤية الحاسوب | ماذا يوجد في المشهد، وأين، وكيف يتحرك، وما هندسته؟ | من بيانات مرئية إلى معلومات عن المحتوى والفضاء |
| رؤية الآلة | هل اجتازت هذه القطعة الفحص، وما قياسها، وكيف يوجَّه الروبوت في خط الإنتاج؟ | منظومة تصوير وإضاءة وتحليل وقرار داخل عملية صناعية |
| الرسوميات الحاسوبية | كيف نولّد صورة أو مشهدًا من نموذج؟ | من وصف هندسي إلى صورة، وهو اتجاه معاكس لتحليل صور العالم |
| التعرف على الأنماط | كيف نكتشف نمطًا ونصنفه في بيانات قد تكون بصرية أو غير بصرية؟ | مجال أوسع، والبيانات المرئية حالة منه |
رؤية الآلة، في الاستعمال الصناعي، منظومة متكاملة: عدسة، وإضاءة ثابتة غالبًا، وكاميرا، وحاسوب، وقرار في زمن دورة الآلة. رؤية الحاسوب اسم للعلم والخوارزميات، وقد تعمل في شارع تتغير إضاءته. أما الرسوميات فتبني الصورة من نموذج، ورؤية الحاسوب تحاول في كثير من مهامها عكس هذه الطريق: من الصورة إلى شيء من وصف العالم. هذه العلاقة تُسمى أحيانًا الرؤية العكسية للرسوميات، وهي أصعب لأن الإسقاط يُسقط معلومات.
اقرأ أيضاً: ابن الهيثم: مؤسس علم البصريات الحديث
كيف تتعامل الحواسيب مع الصور الرقمية؟
كيف تتكون الصورة الرقمية؟
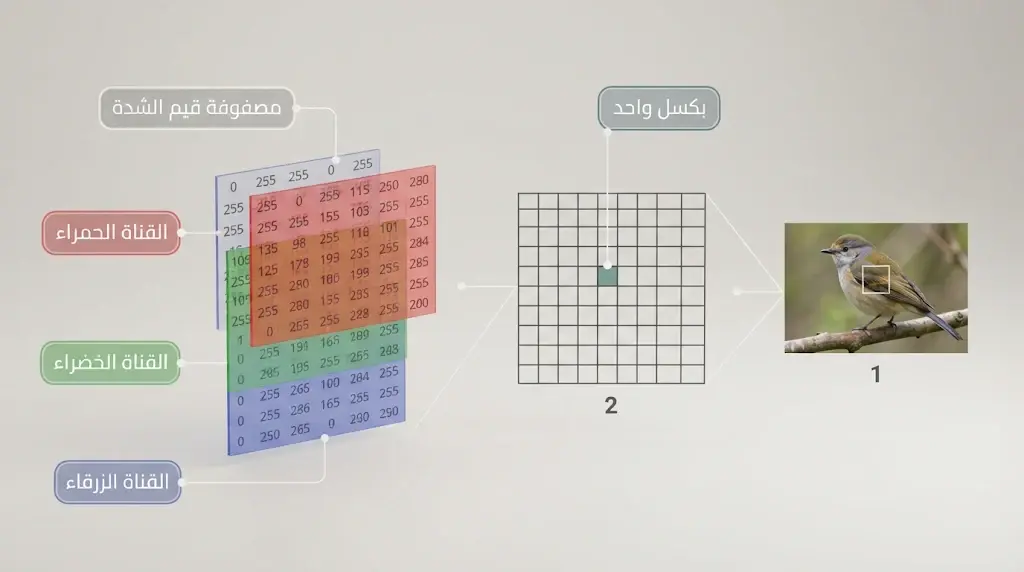
المشهد الذي نراه ضوء منعكس أو صادر عن السطوح، يدخل عدسة فيُجمع على مستشعر. المستشعر يحوّل الطاقة الضوئية إلى إشارة كهربائية، ثم إلى أرقام. أصغر عنصر في هذا التمثيل هو البكسل (Pixel)، وهو عينة من المشهد لا «نقطة معنى». الصورة إذًا مصفوفة. في الصورة الرمادية تحمل كل خلية قيمة شدة واحدة. في الصورة الملونة الشائعة بنظام RGB هناك ثلاث قنوات، للأحمر والأخضر والأزرق، فتُخزَّن الصورة كمصفوفة ثلاثية الأبعاد: ارتفاع وعرض وقنوات.
دقة الصورة هي عدد البكسلات في العرض والارتفاع. صورة 1920×1080 فيها أكثر من مليوني بكسل في كل قناة، وهذا يرفع تفصيل المشهد، لكنه لا يرفع وحده صحة التعرف إذا كان الجسم صغيرًا أو الإضاءة سيئة. عمق اللون أمر آخر: عدد المستويات التي تُمثَّل بها الشدة. في الترميز الشائع بثماني بتات لكل قناة، تتدرج القيمة من 0 إلى 255. رفع الدقة المكانية ورفع عمق اللون يزيدان حجم البيانات، ولا يعنيان تلقائيًا فهمًا أفضل.
لا حاجة هنا إلى تفصيل إلكترونيات المستشعر. يكفي أن المشهد الثلاثي الأبعاد صار جدول أرقام، وأن كل ما سيأتي من حواف وفئات ومسافات يُبنى على هذا الجدول وعلى ما سقط منه في أثناء الإسقاط.
كيف تُستخرج المعلومات من البكسلات؟
الخوارزميات تبدأ عادة من تغيرات الشدة واللون. الحافة موضع تتغير فيه الشدة سريعًا، وقد توافق حد جسم أو حد ظل. الزاوية نمط تتغير فيه الشدة في أكثر من اتجاه، فتصلح علامة يمكن تتبعها. النسيج يصف تكرارًا محليًا، كسطح طريق أو أوراق شجر. بعض الطرق تصف جوار كل نقطة وصفًا محليًا، ثم تجمع هذه الأوصاف في تمثيل للصورة كلها.
قبل انتشار الشبكات العميقة كانت هذه الخصائص تُصمَّم يدويًا: يختار المهندس ما الذي يُقاس، ثم يُدخِل الأرقام إلى قاعدة أو إلى مصنّف. الشبكات الالتفافية تتعلم مرشحاتها من البيانات، فتظهر في طبقاتها الأولى أنماط شبيهة بالحواف، ثم تتراكب في طبقات أعلى أنماط أعقد. في الحالتين المبدأ واحد: البكسل المفرد فقير، والعلاقة بين البكسلات هي ما يحمل الشكل.
كيف تؤثر جودة الصورة في التحليل؟
الصورة التي تصل إلى الخوارزمية ليست وصفًا محايدًا للعالم. الدقة المنخفضة تجعل جسمًا بعيدًا بضعة بكسلات، فلا يبقى فيه ما يكفي للتمييز. الإضاءة الضعيفة تُغرق التفاصيل في الضوضاء، والإضاءة الشديدة تقص القيم العليا فتُمحى الحواف. التباين المنخفض يخلط الجسم بالخلفية. الضبابية من حركة أو من خلل في التركيز تمحو الزوايا التي تعتمد عليها المطابقة الهندسية. تغيير زاوية التصوير يغيّر الشكل الظاهر للجسم نفسه، والاقتراب أو الابتعاد يغيّر حجمه في الصورة من دون أن يتغير حجمه الحقيقي. وحجب جسم لجسم آخر يحذف جزءًا من الحدود، فيضطر النظام إلى تخمين ما لا يراه.
لهذا تفشل أنظمة تبدو دقيقة في المختبر حين تُنقل إلى مطر، أو إلى غبار، أو إلى كاميرا مختلفة، أو إلى مشهد مزدحم. البيانات المتاحة للخوارزمية تغيّرت، لا المعادلة وحدها.
هل يقتصر الأمر على كاميرات التصوير المألوفة؟
لا. المنهج نفسه يُطبَّق على صور رمادية وملونة، وعلى الأشعة تحت الحمراء والصور الحرارية التي تُظهر فروق الحرارة لا الألوان التي تألفها العين، وعلى الصور متعددة الأطياف وفائقة الأطياف المستخدمة في الزراعة والجيولوجيا ورصد الأرض، وعلى خرائط العمق القادمة من مستشعرات مخصصة. ما يتغير هو معنى القناة: قد تكون شدة انعكاس في طول موجي ضيق، لا مقدار أحمر. وتبقى المهمة استخلاص معلومات من هذا التمثيل، مع قيود كل مستشعر.
اقرأ أيضاً:
- النظام العشري: كيف يُترجم الحاسوب أرقامنا اليومية إلى لغة الآلة؟
- معدل البت (Bitrate): الأهمية، القياس، ودوره في جودة الوسائط
ما المهام الأساسية التي تنفذها رؤية الحاسوب؟
المستخدم يبحث غالبًا عن اسم مهمة، لا عن تعريف المجال. وهذه المهام تختلف في سؤالها ومخرجها ومقياس نجاحها. الخلط بينها يؤدي إلى اختيار نموذج غير مناسب، أو إلى قراءة نتيجة اختبار قراءة خاطئة.
| المهمة | السؤال الذي تجيب عنه | المخرج | حدّها |
|---|---|---|---|
| تصنيف الصور | ما فئة هذه الصورة؟ | فئة للصورة أو لمنطقة منها | لا يحدد الموضع ولا يفصل سيارتين |
| اكتشاف الأجسام | ما الأجسام الظاهرة وأين تقع؟ | مربع إحاطة + فئة + درجة ثقة | لا يرسم الحدود الدقيقة للجسم |
| تقسيم الصور | أي فئة أو أي جسم يخص كل بكسل؟ | قناع على مستوى البكسل | الدلالي لا يفصل الأفراد، وقناع الكائنات قد لا يصف الطريق |
| تتبع الأجسام | هل هذا الجسم هو نفسه عبر الإطارات؟ | مسار بهوية ثابتة عبر الفيديو | ينقطع أو يضطرب إذا انقطع الاكتشاف |
| تقدير الوضعية | ما هيئة الجسم أو اتجاهه؟ | نقاط مفتاحية على بنية معروفة | وصف هندسي للحركة الظاهرة لا تشخيص طبي |
| التعرف الضوئي على الحروف | ماذا يقول النص الظاهر؟ | نص رقمي | الاكتشاف وحده يرسم المربع ولا يقرأ اللافتة |
| فهم المشاهد | ما العلاقات بين الأجسام؟ | علاقات أو مخطط مشهد | تسمية الأجسام وحدها لا تعني فهم المشهد |
تصنيف الصور
تصنيف الصور (Image Classification) يُسند إلى الصورة، أو إلى منطقة منها، فئة من قائمة فئات. في التصنيف أحادي التسمية تُختار فئة واحدة، كأن يُقال إن الصورة كلّها «عصفور». وفي التصنيف متعدد الفئات قد تُذكر أكثر من صفة إذا كان التدريب كذلك. هذا مختلف عن اكتشاف عدة أجسام: المصنّف قد يقول «في الصورة سيارة» من دون أن يحدد أين، ومن دون أن يفصل سيارتين. مثاله الواضح صورة تُقرر أنها لطائر أو لمبنى أو لشارع. إذا كانت الحاجة معرفة الموقع، فالتصنيف وحده لا يكفي.
تحديد المواقع واكتشاف الأجسام
تحديد الموقع (Object Localization) يضع جسمًا داخل إطار، غالبًا مربع إحاطة (Bounding Box) يُوصف بإحداثيات أضلاعه. اكتشاف الأجسام (Object Detection) يجمع بين هذا الموضع وبين فئة الجسم، ويكرر ذلك لكل جسم ظاهر. في صورة شارع قد يُخرج النظام مربعات للسيارات وللمشاة ولإشارات المرور، مع اسم كل فئة ودرجة ثقة.
الفرق العملي عن تصنيف الصورة أن المخرج هنا مجموعة اكتشافات لا تسمية واحدة. اكتشاف خاطئ قد يكون خطأ في الفئة رغم صحة المربع، أو مربعًا واسعًا رغم صحة الاسم. التقييم الجيد يفصل هذين الخطأين، كما سيظهر عند الحديث عن التقاطع على الاتحاد.
تقسيم الصور
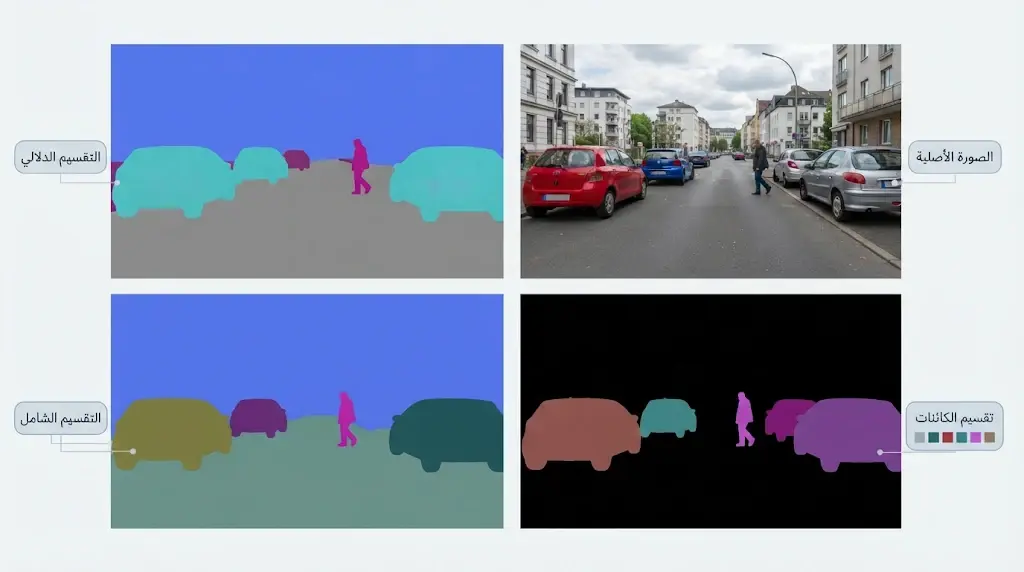
تقسيم الصور (Image Segmentation) يُصنّف وحدات البكسل لا الصورة كلها. النتيجة قناع يتبع الشكل، لا مجرد مستطيل يضم الجسم مع خلفية داخله.
ثلاثة مستويات يختلط أمرها:
| النوع | ماذا يُسند إلى كل بكسل؟ | ماذا لا يفعله؟ |
|---|---|---|
| التقسيم الدلالي (Semantic Segmentation) | فئة المنطقة: طريق، سماء، سيارة، إنسان | لا يفصل سيارة عن سيارة أخرى؛ كل ما هو «سيارة» قد يأخذ اللون نفسه |
| تقسيم الكائنات (Instance Segmentation) | هوية جسم فردي داخل فئته | لا يهتم بالضرورة بمناطق «الخلفية» كالسماء والطريق بالطريقة الدلالية نفسها |
| التقسيم الشامل (Panoptic Segmentation) | فئة للمناطق الدلالية، وهوية مستقلة لكل جسم يُعدّ من الأشياء القابلة للعد | أصعب حسابيًا لأنه يجمع المهمتين |
التقسيم الشامل، كما صاغه كيريلوف وزملاؤه في عملهم عام 2019، محاولة لتوحيد وصف «الأشياء» التي تُعدّ فردًا فردًا و«المواد» التي تمتد كمناطق، في مخرج واحد. معرفة الفرق تغيّر توقع المستخدم: قناع دلالي لمستودع سيارات لا يعطي عدد السيارات، وقناع كائنات قد لا يصف سطح الطريق.
تتبع الأجسام في الفيديو
اكتشاف الجسم يعمل على إطار. التتبع (Object Tracking) يحافظ على هوية الجسم عبر الإطارات: هذه السيارة هي نفسها التي كانت على اليسار قبل ثانية، لا سيارة جديدة. التتبع قد يخص جسمًا واحدًا أو أجسامًا كثيرة (Multiple Object Tracking). الصعوبات تظهر حين يختفي الجسم خلف حافلة ثم يعود، أو حين يتشابه شخصان، أو حين تتغير سرعته وحجمه الظاهري لأنه اقترب من الكاميرا.
عمليًا كثير من أنظمة التتبع تعيد الاكتشاف في كل إطار ثم تربط الاكتشافات بمسارات، باستخدام الموضع والحركة والمظهر. إذا انقطع الاكتشاف انقطع التتبع أو اضطرب. لذلك لا يُستبدل أحدهما بالآخر؛ الاكتشاف يزوّد بالملاحظات، والتتبع يبني الاستمرار.
تقدير الوضعية
تقدير الوضعية (Pose Estimation) يحدد نقاطًا مفتاحية (Keypoints) على بنية معروفة، كمفاصل جسم إنسان أو زوايا قطعة ميكانيكية، ثم يستنتج وضع الأطراف أو اتجاه الجسم في الصورة أو في الفضاء. اكتشاف الشخص بمربع لا يقول إن ذراعه مرفوعة. تقدير الوضعية يجيب عن شكل الهيئة لا عن اسم الفئة فقط. والمبدأ واحد سواء رُسم هيكل مبسط لإنسان يمشي أو وُصفت زوايا أداة يمسكها روبوت. هذا وصف هندسي للحركة الظاهرة، لا تشخيص طبي.
التعرف على النصوص داخل الصور
التعرف الضوئي على الحروف (Optical Character Recognition) يحوّل كتابة ظاهرة في صورة إلى نص رقمي. المسار المعتاد يكتشف أولًا مناطق النص، ثم يتعرف على الحروف والكلمات والأسطر. الاكتشاف من دون تعرف يرسم المربع حول اللافتة ولا يقرأها. التعرف يتأثر بالخط، والميل، والظل، والانعكاس، والضبابية، وبلغة الكتابة واتجاهها. وثيقة مسحوبة ضوئيًا بجودة عالية أسهل من لوحة سيارة في مطر ليلي. لذلك تُنشر أرقام دقة التعرف مع وصف لنوع الصور، لا كرقم مطلق.
فهم المشاهد
فهم المشهد (Scene Understanding) ينتقل من قائمة الأشياء إلى العلاقات: سيارة أمام ممر، شخص يعبر، إشارة تخص هذا الاتجاه لا ذاك. قد يشمل تعرف الأنشطة، وسياق المكان (شارع، غرفة، حقل)، وبناء تمثيل علائقي يُسمى أحيانًا مخطط مشهد (Scene Graph): عقد للأجسام وحواف للعلاقات.
تسمية كل الأجسام لا تعني فهم المشهد. صورة فيها «إنسان» و«سيارة» تحتمل أن الإنسان يركب أو يعبر أو يقف بعيدًا. العلاقات المكانية والزمانية هي مستوى آخر من السؤال، وأخطاؤه أخطر في القيادة والروبوتات لأن القرار يعتمد على العلاقة لا على الاسم.
اقرأ أيضاً: الباريدوليا: رؤية الأشكال المألوفة في الأشياء العشوائية
كيف تعمل منظومة رؤية الحاسوب من البداية إلى النتيجة؟
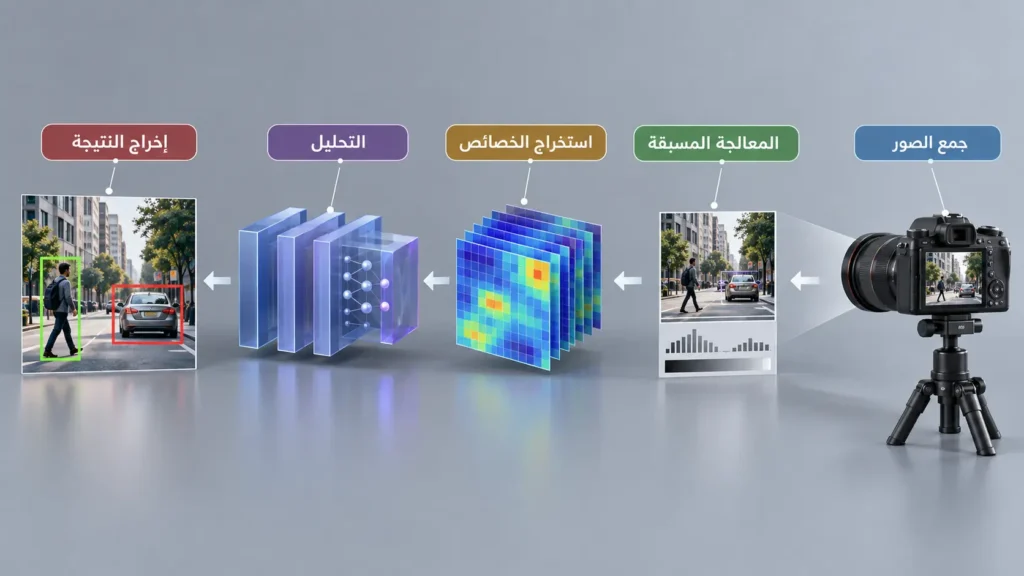
جمع الصور
العمل يبدأ بتحديد المهمة تحديدًا يفرض شكل البيانات. فحص خدش على معدن يحتاج إضاءة ثابتة ودقة تكفي لرؤية الخدش. رصد مركبات في صورة فضائية يحتاج دقة أرضية يظهر فيها الجسم. بعد اختيار الكاميرا أو المستشعر تُلتقط الصور أو الفيديو في ظروف قريبة من الاستخدام الفعلي، لا في ظروف مثالية فقط، ثم تُنظم وتُوثق: أين التُقطت، وبأي إعداد، وما الذي يُعدّ مثالًا صحيحًا.
المعالجة المسبقة
المعالجة المسبقة (Preprocessing) تجهّز المدخل لما تتوقعه الخوارزمية. قد تُغيَّر الأبعاد، وتُطبَّع قيم البكسلات (Normalization) إلى مدى موحّد، وتُخفف بعض الضوضاء، ويُرفع التباين، أو تُنقل الصورة إلى فضاء لوني آخر. ليست هناك سلسلة ثابتة. نموذج مدرَّب على صور ضلعها 224 بكسلًا سيُساء استخدامه إن أُدخلت إليه صورة خام بحجم مختلف من دون الإجراء نفسه الذي استُعمل في التدريب.
استخراج الخصائص والتمثيلات
هنا يتحول الجدول إلى وصف يمكن تحليله. في الأساليب التقليدية تُستخرج حواف وزوايا وأوصاف محلية. في الشبكات العميقة تتعلم الطبقات تمثيلًا تتغير أبعاده من بكسلات إلى متجهات تحمل أنماطًا. الفرق جوهري: الخاصية المصممة يدويًا مفهومة ويمكن ضبطها، لكنها محدودة بما توقعه المصمم. التمثيل المتعلم يتكيف مع البيانات، وقد يلتقط اختصارات غير مقصودة، كلون الخلفية الذي صادف أنه ملازم لفئة في مجموعة التدريب.
التحليل وإنتاج النتيجة
تدخل الصورة، أو تمثيلها، إلى النموذج. في التصنيف تُحسب درجات للفئات. في الاكتشاف تُقترح مواضع وتُصفّى. في التقسيم يُسند إلى البكسلات وصف. النموذج هنا دالة ضخمة مُقدَّرة من بيانات، لا قاعدة واحدة يقرأها الإنسان. درجة الثقة التي يخرجها مقياس داخلي لشدة التنبؤ، ولا تساوي دائمًا احتمالًا حقيقيًا بأن التنبؤ صحيح في الشارع.
معالجة النتائج وإخراجها
نادرًا ما تُعرض مخرجات النموذج الخام. تُحذف الصناديق الضعيفة أو المكررة، وتُربط الاكتشافات بين الإطارات، وتُرسم الأقنعة، ويُمرر النص إلى نظام أرشفة، أو يُرسل موضع عائق إلى متحكم في روبوت. هذه المرحلة جزء من السلوك الفعلي. منظومة قد تفشل لأن الربط بين الإطارات أخطأ، لا لأن المصنّف أخطأ.
ما الفرق بين تدريب النموذج وتشغيله؟
التدريب (Training) يعدل معاملات النموذج حتى تقترب تنبؤاته من التسميات على بيانات التدريب. التحقق (Validation) يُستخدم في أثناء التطوير لضبط خيارات التصميم ومراقبة فرط التكيّف. الاختبار (Testing) يقيس الأداء على بيانات لم تُستخدم في التدريب ولا في ضبط الخيارات. الاستدلال (Inference) هو تشغيل النموذج بعد تثبيته على صور جديدة.
نجاح التدريب يعني أن النموذج استطاع تقليل خطئه على ما رآه، أو على مجموعة تشبهه. لا يعني أن كل كاميرا وكل طقس داخلان في هذا الشبه. لذلك يُفصل تقرير التدريب عن تقرير الاختبار، ويُفصل الاثنان عن تجربة ميدانية على موقع حقيقي.
اقرأ أيضاً:
- هندسة البيانات: الشريان المعماري لبناء منظومات الذكاء الاصطناعي
- تحليل البيانات: المنهجية العملية لتحويل الأرقام إلى قرارات إستراتيجية
ما التقنيات والخوارزميات التي تقوم عليها رؤية الحاسوب؟
الأساليب التقليدية
قبل الشبكات العميقة بُنيت أنظمة كثيرة على عمليات رياضية صريحة. اكتشاف الحواف يبرز مواضع التغير. اكتشاف الزوايا والنقاط المميزة يحدد معالم يمكن مطابقتها بين صورتين. تحليل الحدود يحيط بالأشكال. تحليل القوام يصف السطح. ثم جاء وصف الخصائص المحلية القابلة للمطابقة، وأشهرها تحويل الخصائص غير المتغير مع المقياس (SIFT) الذي نشره ديفيد لو عام 2004: نقاط تبقى قابلة للتعرف رغم تغير المقياس والدوران، وضمن مدى من تغير الإضاءة وزاوية النظر. هذه الأساليب لم تُلغَ. ما زالت تُستخدم في المطابقة الهندسية، وفي تقدير الحركة، وفي أنظمة لا تتوفر لها بيانات تدريب كبيرة، وفي مواضع يُشترط فيها تفسير الخطوة لا مجرد درجة ثقة.
تعلم الآلة
تعلم الآلة أضاف طبقة تربط الخصائص بقرار يُتعلم من أمثلة، بدل قاعدة تُكتب باليد لكل حالة. يُستخرج وصف للصورة، ثم يتعلم مصنّف حدًا فاصلًا بين الفئات، أو تُجمع الأنماط من دون تسميات. القيد أن جودة القرار مرهونة بجودة الخصائص اليدوية. إذا لم يُصمم الوصف لالتقاط الفرق بين عيبين متشابهين، فلن يخترعه المصنّف الخطي. هذا هو الحد الذي دفع البحث نحو تمثيلات تتعلم من البكسلات نفسها.
التعلم العميق
الشبكات العصبية العميقة تتعلم تمثيلات على مراحل: أنماط محلية بسيطة، ثم تركيبات منها، ثم أنماط أقرب إلى أجزاء الأجسام. التدريب على مجموعات كبيرة، وحساب التدرجات على وحدات معالجة الرسوميات (GPU)، جعلا هذا المسار عمليًا. التحول ليس أن الشبكة «صارت ترى»، بل أن البحث عن الخصائص لم يعد كله على عاتق المصمم. في مقابل ذلك صارت النتائج أشد ارتباطًا بتوزيع بيانات التدريب، وأصعب تفسيرًا خطوة بخطوة.
الشبكات العصبية الالتفافية
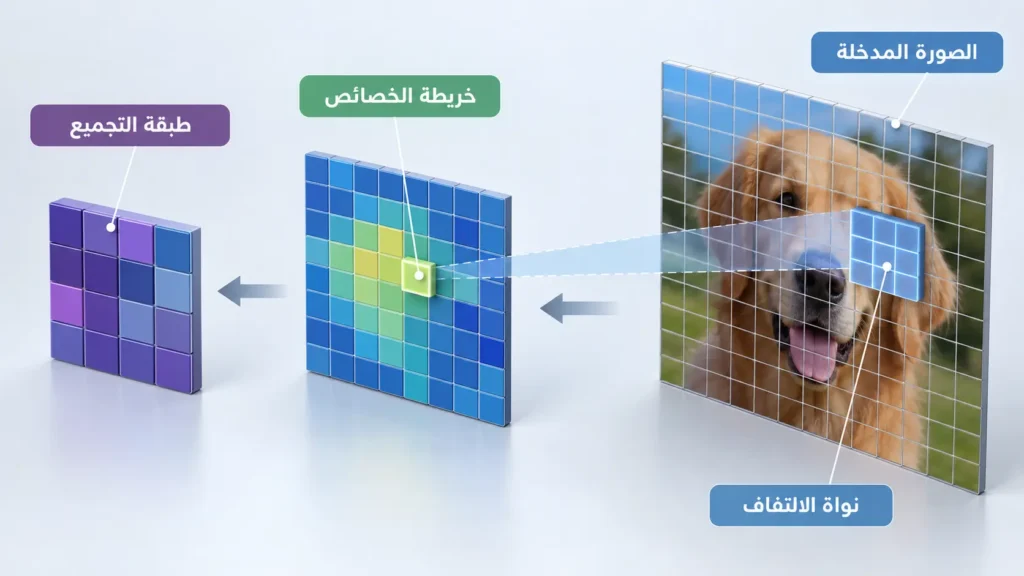
الشبكة العصبية الالتفافية (Convolutional Neural Network, CNN) تبني قرارها من طبقات التفاف. الالتفاف (Convolution) يمرر مرشحًا صغيرًا، أو نواة (Kernel)، على الصورة. في كل موضع يُحسب مجموع موزون للجوار. الناتج خريطة خصائص (Feature Map). طبقات التجميع (Pooling) تقلل الأبعاد وتمنح قدرًا من الثبات تجاه إزاحة صغيرة. في النهاية قد تجمع طبقات متصلة القرار، أو يُستغنى عنها بحسب التصميم.
قوة هذه البنية أن المرشح نفسه يُعاد استعماله في كل مكان، فالشبكة تبحث عن النمط أينما ظهر، وأن القرار المحلي يُبنى قبل القرار العام. القيد أن العلاقة بين طرفي صورة كبيرة لا تظهر إلا بعد طبقات عديدة، ما لم تُضف آليات توسع المجال. كما أن ما تتعلمه الشبكة يبقى مشروطًا بالأمثلة. مرشح حافة ليس قاعدة هندسية مضمونة خارج توزيع التدريب.
المحولات البصرية
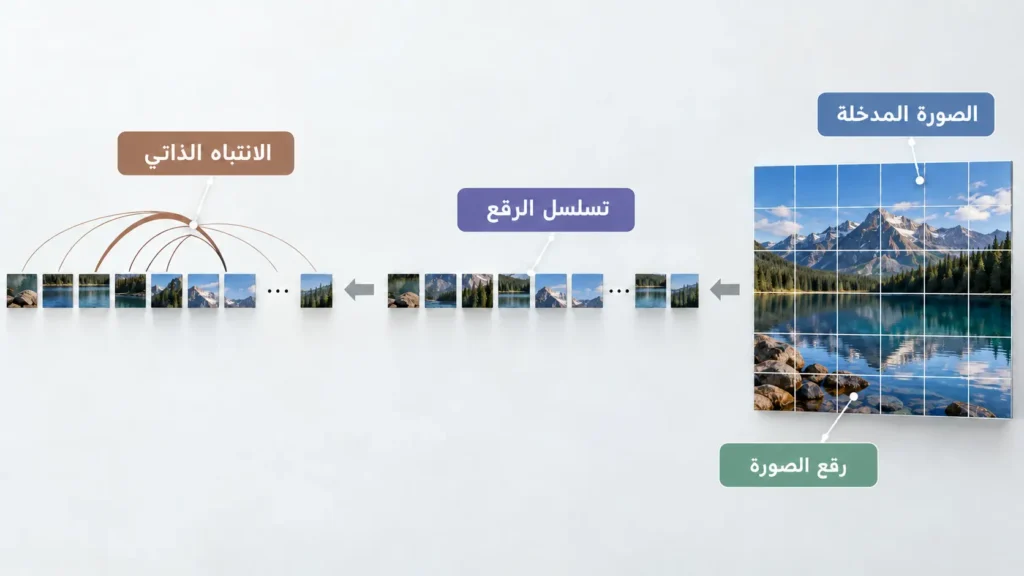
المحوّل (Transformer) بنية اعتمدت أولًا في اللغة، قوامها الانتباه الذاتي (Self-Attention): كل عنصر في السلسلة يستطيع أن يزن علاقته ببقية العناصر. المحول البصري (Vision Transformer, ViT) يقسم الصورة إلى رقع (Patches)، ويعاملها كسلسلة، ثم يتعلم العلاقات بينها. في الورقة المؤسسة لدوسوفيتسكي وزملائه عام 2020 كانت الرقعة الشائعة 16×16 بكسلًا، ومن هنا عبارة أن الصورة تُعامل كسلسلة من «كلمات» بصرية.
الفرق عن الشبكة الالتفافية أن الانتباه قادر، من طبقات مبكرة، على ربط رقعتين متباعدتين. والثمن أن البنية لا تحمل في تصميمها الفرض القوي بأن الجوار أهم من البعيد، وهو فرض يناسب الصور. لذلك تحتاج المحولات عادة إلى بيانات أكثر حتى لا تفرط في التكيّف. تجارب المؤلفين أوضحت المسار: عند التدريب على ImageNet وحدها، بلغ أفضل محول بصري ذكرته مدونة غوغل البحثية 77.9% دقة من الفئة الأولى، بينما بلغ أفضل شبكة التفافية مقارنة آنذاك 85.8%، أي بفارق 7.9 نقطة مئوية لصالح الشبكة الالتفافية. وعلى بيانات أوسع تقاربت النتائج، ثم تفوقت المحولات حين صار التدريب على مئات الملايين من الصور. أفضل نموذج ذكروه بعد تدريب على مجموعة JFT بلغ 88.55% على ImageNet.
رقم يستحق الانتباه: فارق 7.9 نقطة على ImageNet وحدها ليس تفصيلًا عابرًا. هو الدليل على أن تفوق بنية في أوراق البيانات الضخمة لا يُنقل إلى موقع قليل الصور. المحول البصري لم يُلغِ الشبكة الالتفافية، والنماذج الهجينة تجمع الالتفاف والانتباه لهذا السبب.
اقرأ أيضاً:
- شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
- البيانات الضخمة (Big Data): كيف تحرك الأرقام العالم وتصنع مستقبل التكنولوجيا؟
| وجه المقارنة | الشبكة الالتفافية (CNN) | المحول البصري (ViT) |
|---|---|---|
| الآلية الأساسية | مرشح صغير (نواة) يمر على الصورة | انتباه ذاتي بين الرقع |
| تمثيل الصورة | خريطة خصائص من جوار كل موضع | سلسلة رقع (16×16 بكسلًا في الورقة المؤسسة) |
| الربط بين منطقتين متباعدتين | بعد طبقات عديدة ما لم تُضف آليات توسع المجال | ممكن من الطبقات المبكرة |
| الفرض المدمج في التصميم | الجوار أهم من البعيد، والمرشح نفسه يُعاد استعماله | لا يحمل فرض الجوار في تصميمه |
| الحاجة إلى البيانات | أقل، وميزتها ظاهرة عند قلة الصور | أكثر، حتى لا يفرط في التكيّف |
| الدقة على ImageNet وحدها | 85.8% (أفضل شبكة التفافية مقارنة آنذاك) | 77.9% (أفضل محول بصري) |
| عند التدريب على مئات الملايين من الصور | تقاربت النتائج على بيانات أوسع | تفوق؛ أفضل نموذج بلغ 88.55% بعد التدريب على JFT |
| الاستعمال الأنسب | قلة البيانات أو الحاجة إلى فرض محلي | توفر تدريب واسع وحساب كافٍ |
| الجمع بينهما | نماذج هجينة تجمع الالتفاف والانتباه | |
نماذج الرؤية واللغة والنماذج الأساسية
النموذج الأساسي (Foundation Model) يُدرَّب على بيانات واسعة جدًا، ثم يُكيَّف لمهام لم يُصمم كل منها من الصفر. في الرؤية ارتبط ذلك بنماذج تربط الصورة بالنص. يمكن للنظام أن يبحث عن فئة تُوصف بكلمات حتى لو لم تكن تلك الفئة رأسًا مستقلًا في تدريب مغلق، وهذا ما يُسمى تصنيفًا مفتوح المفردات (Open-Vocabulary Classification). ويمكن أن يُطلب منه تقسيم شيء عبر إشارة أو عبارة، أي تقسيم موجه بالمطالبة (Promptable Segmentation).
النموذج المتخصص لمهمة واحدة أسهل تقييمًا وأحيانًا أدق حين تتوفر بيانات تلك المهمة. النموذج العام أوسع استعمالًا وأصعب في ضمان سلوكه على فئة نادرة. وربط صورة بجملة صحيحة لا يثبت أن النظام يمتلك نموذجًا كاملًا للعالم الفيزيائي. قد ينجح التطابق اللغوي–البصري وتفشل العلاقة المكانية الدقيقة. هذا حد ينبغي أن يبقى ظاهرًا عند قراءة عروض «الفهم».
نموذج Segment Anything وتطور التقسيم
نموذج Segment Anything (SAM) مثال على التقسيم القابل للتوجيه: إشارة بنقرة أو مربع تكفي لطلب قناع جسم، بدل تدريب شبكة جديدة لكل فئة. الإصدار التالي، SAM 2، الذي نشره فريق في ميتا عام 2024 (arXiv:2408.00714)، يوسّع الفكرة إلى الفيديو عبر ذاكرة تتدفق مع الإطارات. الورقة تصف بنية محولات مع هذه الذاكرة، وتذكر أن النموذج في تقسيم الصور أدق وأسرع بست مرات من SAM السابق، وأن تقسيم الفيديو بلغ دقة أفضل بعدد تفاعلات أقل بثلاث مرات من أساليب سابقة. مجموعة البيانات المصاحبة SA-V وُصفت بأنها تضم 35.5 مليون قناع في 50.9 ألف فيديو.
الذاكرة الزمنية تساعد على متابعة جسم يغيب ثم يظهر، لأن النموذج يحتفظ بوصف له لا بصورة الإطار الأخير فقط. هذا تقدم موثق في التقسيم الموجه، لا حل لكل مسائل التقسيم. الأداء يبقى مرتبطًا بنوع المشهد، وبنوع الإشارة، وبمدى الشبه بين صور الاستخدام وصور التدريب. الجسم الشفاف، والازدحام الشديد، والحدود الدقيقة في صورة طبية أو صناعية، ليست مضمونة لأن النموذج نجح في عرض عام.
اقرأ أيضاً:
- الدليل الشامل إلى النماذج مفتوحة المصدر (Open Source Models): كيف تقود ثورة الذكاء الاصطناعي؟
- الذكاء الاصطناعي التوليدي: كيف يعمل وما تطبيقاته في 2026؟
كيف تتعلم أنظمة رؤية الحاسوب من البيانات؟
مجموعات البيانات
مجموعة البيانات صور، وأحيانًا فيديو أو خرائط عمق، مع وصف يراد للنموذج أن يتعلمه. التنوع شرط: إضاءات، ومسافات، وكاميرات، وخلفيات. الحجم وحده لا يكفي إن كانت الصور كلها من مدينة واحدة وطقس واحد. ويُفرَّق بين البيانات الخام والبيانات الموسومة. الوسم هو ما يحوّل الصورة إلى مثال تدريب، وهو مكلف لأنه يحتاج حكمًا بشريًا أو إجراءً يُنتج إشارة موثوقة. هناك مجموعات عامة للمقارنة بين البحوث، ومجموعات خاصة بمصنع أو بمزرعة لا تعني خارج سياقها.
مجموعة ImageNet، في نسختها المستخدمة في تحدي ILSVRC، تضم نحو 1.2 مليون صورة تدريب و50 ألف صورة تحقق و150 ألف صورة اختبار، في 1000 فئة. المجموعة الأوسع التي وُصفت في ورقة أليكس نت تضم أكثر من 15 مليون صورة في نحو 22 ألف فئة. أما مجموعة COCO فقد قُدمت عام 2014 بوصفها 328 ألف صورة و2.5 مليون حالة موسومة و91 نوعًا من الأشياء في مشاهد يومية، مع أقنعة للأشياء الفردية لا تسميات للصورة كلها فقط. بروتوكول تقييم الاكتشاف الشائع اليوم يحسب متوسطه على 80 فئة. الاختلاف بين 91 و80 ليس تناقضًا في الرواية، بل فرق بين وصف المجموعة في الورقة المؤسسة وبين الفئات المعتمدة في بروتوكول التقييم.
كيف تُوسم الصور؟
شكل الوسم يتبع المهمة. التصنيف يحتاج اسمًا. الاكتشاف يحتاج مربعًا واسمًا. التقسيم يحتاج قناعًا. الوضعية تحتاج نقاطًا. التتبع يحتاج الهوية نفسها عبر الإطارات، لا مربعات منفصلة كل إطار. المراجعة البشرية تدخل في وضع الوسوم وفي تصحيح ما تقترحه أدوات نصف آلية. الخطأ في الوسم يُعلَّم كما تُعلَّم الإشارة الصحيحة. لذلك تُراجع عينات من الوسوم، ولا يُفترض أن الحجم يعوّض الضوضاء.
طرق التعلم
التعلم الخاضع للإشراف يتعلم من صور مقرونة بوسم يُعدّ صحيحًا، وهو المسار الأوضح عندما يتوفر وسم جيد. التعلم غير الخاضع للإشراف يبحث عن بنية في البيانات من دون ذلك الوسم الصريح. التعلم شبه الخاضع للإشراف يخلط القليل الموسوم بالكثير غير الموسوم، فيفيد حين يكون الوسم هو الكلفة الكبرى. التعلم الذاتي الإشراف يصنع إشارة من الصورة نفسها، كالتنبؤ بجزء محجوب أو بتقريب تمثيلين لتحويلين من الصورة ذاتها، ثم يُستخدم التمثيل الناتج في مهمة لاحقة. التعلم بالنقل يأخذ نموذجًا سبق تدريبه على مهمة واسعة ويعيد ضبطه على مهمة أضيق، وهذا شائع لأن تدريب شبكة عميقة من الصفر يحتاج بيانات وحسابًا قد لا يتوفران. التعلم قليل الأمثلة يحاول تعرّف فئة جديدة من عدد صغير من الصور، ونتائجه أشد حساسية لاختيار الأمثلة.
لا يوجد أسلوب أفضل بإطلاق. المهمة وكلفة الوسم ودرجة الشبه بين المصدر والهدف هي ما يرجح الاختيار.
كيف يُمنع النموذج من حفظ الصور بدل تعلم الأنماط؟
التعميم (Generalization) هو أن يصدق الأداء على صور لم تُر في التدريب. الحفظ هو إعادة ما شوهد. فرط التكيّف (Overfitting) يظهر حين ينخفض خطأ التدريب ويستمر خطأ التحقق في الارتفاع. نقص التكيّف (Underfitting) يظهر حين يعجز النموذج حتى عن تدريب نفسه لأن سعته أو خصائصه لا تكفي. التقسيم إلى تدريب وتحقق واختبار هو الحد الأدنى من الانضباط. زيادة البيانات (Data Augmentation) تولّد تنويعات بالقص والقلب وتغيير الإضاءة، فتوسّع التنوع الظاهر، بشرط ألا تصنع حالات مستحيلة تشوّش المعنى. البيانات الاصطناعية مفيدة حين تحاكي الهندسة والإضاءة بما يكفي، ومضللة حين يتعلم النموذج بصمة المولّد لا بصمة العالم.
الاختبار على مصدر مختلف عن مصدر التدريب أقسى وأصدق. نموذج ينجح على صور هاتف واحد قد يسقط على هاتف آخر.
لماذا تكثر الحاجة إلى البيانات والحساب؟
الصور عالية الأبعاد: مئات الآلاف من القيم، وتتغير بالضوء والوضع والحجب. النماذج العميقة فيها ملايين المعاملات، وأحيانًا أكثر بكثير. معالجة الدقة العالية ترفع كلفة كل خطوة. التدريب يُعاد على البيانات مرات، أما التشغيل فتمرير أمامي واحد أو عدد محدود، لذلك تكون كلفة التدريب هي الغالبة عند بناء النموذج، بينما تصبح كلفة التشغيل هي الغالبة عند نشره على أسطول مركبات أو كاميرات.
وحدات الرسوميات والمسرّعات جعلت التدريب العميق ممكنًا زمنيًا. وتقليل الحاجة إلى البيانات يمر عبر النقل، والتعلم الذاتي الإشراف، والنماذج الأصغر، لا عبر تكبير الشبكة دائمًا. نقطة تغيب عن المقارنات الدعائية: بنية أحدث لا تعوّض نقص البيانات، ولا اختلال توازن الفئات، ولا ضوضاء التسميات. هذه العوامل قادرة على إفساد النتيجة مع أحدث تصميم.
ماذا يظهر حين تُختبر النماذج خارج جغرافيا التدريب؟
في أيار/مايو 2025 نشرت نورا الأمادي وإنغمار فيبر ويين يانغ وفيردا أوفلي ورقة بعنوان VME عن اكتشاف المركبات في صور الأقمار الصناعية للشرق الأوسط (arXiv:2505.22353). المجموعة مأخوذة من صور ماكسار، وتغطي 54 مدينة في 12 دولة، وفيها أكثر من 4000 بلاطة صورة وأكثر من 100 ألف مركبة، وُسمت يدويًا وشبه آلي. الدافع المصرح به أن مجموعات الاكتشاف الفضائي الشائعة منحازة جغرافيًا، وأن النماذج المدربة عليها ضعيفة على صور المنطقة، وأن التدريب على VME حسّن الدقة هنا. وأضافوا مجموعة أوسع للمقارنة العالمية سُميت CDSI.
إذا قسمنا الحد الأدنى المذكور للمركبات على الحد الأدنى المذكور للبلاطات، كان الناتج 25 مركبة للبلاطة. ولأن عبارة الورقة في الملخص هي «أكثر من» في الطرفين، فهذا الرقم ترتيب عِظَم يستند إلى الأرقام المدوّرة في الملخص، لا متوسطًا محسوبًا من جداول البحث. دلالته أن الوسم كثيف بما يكفي ليكون خطأ التعميم الجغرافي مسألة عملية لا نظرية: عشرات المركبات في البلاطة، على امتداد عشرات المدن، تعني أن هبوط الدقة عند نقل نموذج أجنبي يتكرر على نطاق واسع.
الاستنتاج الذي تسمح به الورقة، من دون ادّعاء نسبة مئوية لم ينشرها الملخص، أن الفشل هنا فشل توزيع لا فشل «وجود سيارات في الصورة». شكل العمران، وحجم المركبة في المقياس الفضائي، والظل، وكثافة الشوارع، تختلف بين المناطق. نموذج يُعلَن متفوقًا على مجموعة عالمية قد يخيب في مدينة شرق أوسطية لأن تلك المدينة لم تدخل توزيع التدريب. هذا هو تغير التوزيع (Distribution Shift) بصورة ملموسة، لا كمصطلح مجرد.
اقرأ أيضاً:
- تنقيب البيانات: الفن العلمي لاكتشاف الأنماط الخفية في الكتل الرقمية
- قواعد البيانات: البنية التحتية لحفظ المعلومات وإدارة الأنظمة الرقمية
كيف تفهم رؤية الحاسوب العمق والحركة والبعد الثالث؟
كثير من الشروح تتوقف عند تسمية الأشياء. غير أن جزءًا أصيلًا من المجال يسأل عن الهندسة: أين كان الجسم في الفضاء، لا في جدول البكسلات فقط.
من العالم الثلاثي إلى الصورة الثنائية
العالم ثلاثي الأبعاد، والصورة إسقاط له على مستوى. في نموذج الكاميرا ذات الثقب، وهو النموذج الذي تُبنى عليه أكثر التصحيحات العملية، تُسقط نقطة في إحداثيات الكاميرا ((X, Y, Z)) إلى موضع في الصورة بحسب المثلثات المتشابهة. البعد البؤري (f) يتحكم في التكبير ومجال الرؤية: زيادته تكبّر الجزء المركزي وتضيّق ما يُرى من الأطراف.
x = f · X / Z , y = f · Y / Z
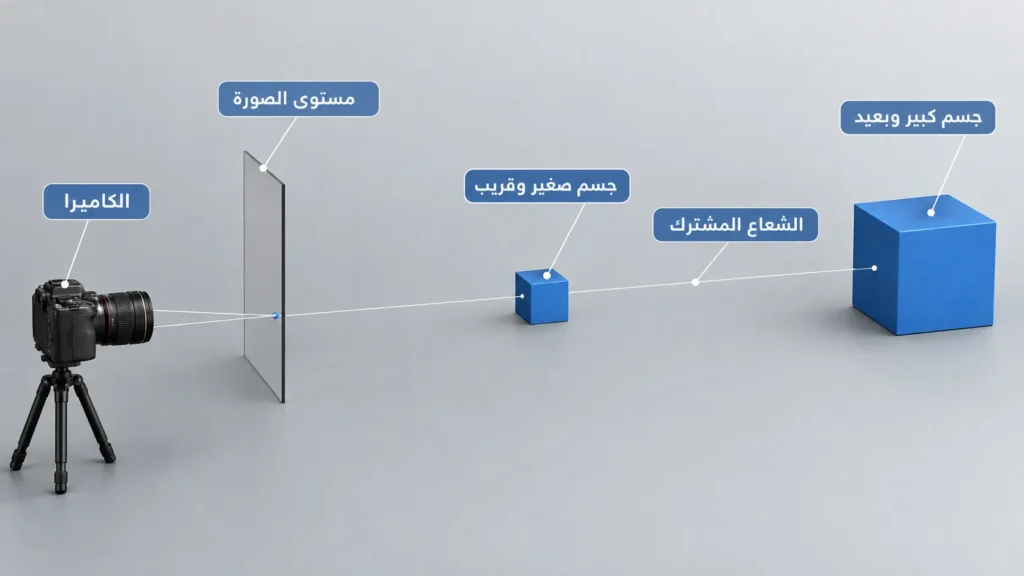
القسمة على العمق (Z) هي لب المسألة. الإسقاط المنظوري ليس تكبيرًا خطيًا بسيطًا. جسم بعيد وكبير قد يرسم أثرًا يشبه أثر جسم قريب وصغير. معلومة المقياس المطلق تسقط، ولا تستعاد من صورة واحدة إلا بقيد إضافي: جسم معروف الحجم، أو حركة كاميرا معروفة، أو كاميرا ثانية، أو مستشعر عمق، أو فرض إحصائي تعلمه نموذج وقد يخطئ.
لماذا لا تكفي صورة واحدة لاستعادة المسافة؟
التفسير التمهيدي يعرض تقدير العمق كأنه امتداد طبيعي للتعرف على الأشياء: الشبكة «تنظر» فتخرج خريطة مسافات. عند مستوى الهندسة يتبين أن الصورة الواحدة توافق عددًا غير محدود من المشاهد الثلاثية التي تقع نقاطها على الأشعة نفسها. مشهد مُضاعَف الحجم وموضوع عند ضعف المسافة يمكن أن ينتج الإسقاط ذاته إذا بقيت العلاقات على الشعاع. لذلك تُعَدّ استعادة البنية من صورة منفردة مسألة ناقصة التحديد. تقدير العمق الأحادي الشائع في التعلم العميق يعتمد على قرائن المظهر والمنظور والحجم المألوف، ويغلب أن ينتج عمقًا نسبيًا أو عمقًا بمقياس غير مضمون. المتر الحقيقي يتطلب معايرة، أو قاعدة معروفة بين كاميرتين، أو رصدًا حركيًا مضبوطًا، لا اسم الفئة. هذا الحد لا يلغي فائدة النماذج الأحادية في الرسم والتقريب، لكنه يمنع معاملة مخرجاتها كقياس مساحي من دون فحص المقياس.
اقرأ أيضاً: الجبر الخطي المتقدم: المفهوم، الفروع، والتطبيقات
معايرة الكاميرا
المعايرة (Camera Calibration) تقدير الخصائص التي تربط الشعاع بالبكسل. المعلمات الداخلية (Intrinsic Parameters) تشمل البعد البؤري ونقطة المركز، وأحيانًا معامل الميل، وتصف الكاميرا نفسها. المعلمات الخارجية (Extrinsic Parameters) تصف دوران الكاميرا وموضعها بالنسبة إلى العالم. يُضاف تشوه العدسة الذي يحني الخطوط المستقيمة قرب الأطراف. من دون هذه المعرفة يمكن اكتشاف سيارة، ولا يمكن تحويل موضعها في الصورة إلى موضع بالأمتار على الطريق. القياس وإعادة البناء يبدآن من المعايرة، لا من المصنّف.
استنتاج المسافة والعمق
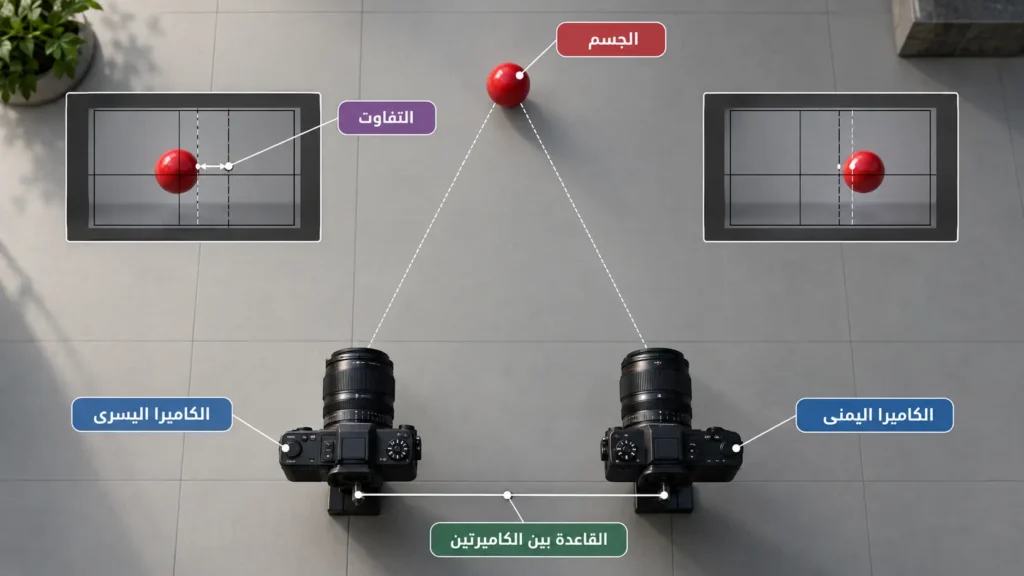
خريطة العمق (Depth Map) صورة موازية تحمل لكل بكسل مسافة لا لونًا. الرؤية المجسمة (Stereo Vision) تحسب هذه المسافة من كاميرتين تفصل بينهما قاعدة معلومة. بعد تصحيح الصورتين، يظهر الجسم منزاحًا بين الصورتين بمقدار التفاوت (Disparity). في النموذج المبسط لكاميرتين مصححتين تكون العلاقة:
Z = f · B / d
حيث (B) القاعدة بين الكاميرتين و(d) التفاوت. التفاوت الصغير يعني بعدًا كبيرًا، ولذلك يضعف تمييز المسافات البعيدة إذا كانت القاعدة قصيرة أو الدقة منخفضة. تقدير العمق من كاميرا واحدة يستخدم الحركة بين الإطارات، أو المنظور، أو الحجم المألوف للأشياء، أو شبكة مدربة. القيد الذي تفرضه المعادلة السابقة يظل قائمًا: من دون (f) و(B) أو ما يعادلهما، يبقى المقياس حرًا.
إعادة البناء الثلاثي الأبعاد
إعادة البناء الثلاثي الأبعاد (3D Reconstruction) تنتج نقاطًا أو سطوحًا في الفضاء من صور. مطابقة الخصائص بين زوايا متعددة، ثم تقدير مواضع الكاميرات والبنية معًا، هو جوهر استعادة البنية من الحركة (Structure from Motion). المطابقة المجسمة متعددة المناظر (Multi-View Stereo) تكثف هذه البنية إلى سحابة نقطية (Point Cloud) أو سطح. بناء جسم واحد على طاولة، مع خلفية بسيطة وصور كثيرة، أسهل من بناء حي بكامله فيه زجاج وأشجار متحركة وإضاءة متغيرة. إعادة بناء البيئة ليست تضخيمًا لإعادة بناء الجسم؛ عناصرها تتحرك، وتمتد خارج الإطار، وتتكرر فيها أنسجة فقيرة المعالم كالجدران الملساء التي تفشل فيها المطابقة.
تحديد الموقع ورسم الخرائط
نظام التحديد المتزامن للموقع ورسم الخرائط (SLAM) يحل مسألتين معًا بينما تتحرك الكاميرا: أين أنا، وما شكل المكان. الحركة البصرية (Visual Odometry) تقدّر الانتقال بين لقطات متتالية من تغير الصورة. SLAM يضيف خريطة يجري تحديثها، ويحاول إغلاق الحلقة حين يعود الروبوت إلى مكان رآه من قبل حتى لا يتراكم الانحراف. الرؤية المجسمة تقدّر العمق من منظرين في لحظة، وإعادة البناء المتعددة المناظر قد تُنفذ لاحقًا على صور مخزنة، أما SLAM فيقيدّه الزمن الحقيقي وحركة المنصة. الفرق عملي: مركبة تحتاج موضعًا الآن لا نموذجًا جميلًا بعد انتهاء الجولة.
الحركة في الصور
الفيديو ليس صورًا مستقلة. التدفق البصري (Optical Flow) يقدّر أين انتقل كل بكسل بين إطارين. هذا الانتقال أثر ظاهر، وقد ينتج عن حركة الجسم أو عن حركة الكاميرا أو عن الاثنين. فصل الحركتين شرط لقراءة المشهد: إن كانت الكاميرا هي التي دارت، فالأجسام الثابتة تتحرك في الصورة أيضًا. تتبع الأجسام يركب على هذا الفهم، لأنه يربط هوية جسم رغم حركة الخلفية. وتحليل الأنشطة يحتاج مدى أطول من إطارين: الحدث علاقة زمنية، لا إزاحة بكسل واحدة.
اقرأ أيضاً:
- الحوسبة المكانية: الدليل العلمي الشامل لثورة دمج العالمين الرقمي والمادي
- أنظمة التموضع الفضائية العالمية: كيف تعمل وما علاقتها بـ GNSS وGPS؟
كيف تطورت رؤية الحاسوب؟
في الستينيات كانت المحاولات تسأل إن كان الحاسوب يستطيع استنتاج أشكال ثلاثية من خطوط الصورة. رسالة لورنس روبرتس في معهد ماساتشوستس للتقانة عام 1963، Machine Perception of Three-Dimensional Solids، من النصوص المؤسسة: إدراك أجسام ثلاثية من صورها، في عالم من متعددات سطوح واضحة الحدود. الخطوط والحواف والهندسة كانت المادة. الصعوبة التي ظهرت بعد ذلك أن المشهد الواقعي ليس كتلة على خلفية نظيفة؛ فيه نسيج وظل وحجب وإضاءة لا تُختصر إلى حواف مثالية.
العقود التالية طورت كواشف الحواف والزوايا والأوصاف المحلية، وأدخلت الإحصاء وتعلم الآلة على خصائص مصممة، وبنت هندسة متعددة المناظر صارت أساس المعايرة وإعادة البناء. ثم عادت الشبكات العصبية إلى الواجهة حين اجتمعت بيانات كبيرة وحساب على وحدات الرسوميات. في 30 أيلول/سبتمبر 2012 فازت شبكة أليكس نت، التي صممها أليكس كريجفسكي مع إيليا سوتسكيفر وجيفري هينتون، بتحدي ImageNet. في ورقة البحث بلغ خطأ أفضل خمس فئات 15.3% مقابل 26.2% لثاني أفضل مشاركة. ويجب تقييد الرقم: 15.3% تعود إلى تشغيل استُخدمت فيه بيانات ImageNet الإضافية من إصدار خريف 2011، بينما بلغ خطأ التشغيل على بيانات المسابقة وحدها 16.4%. في الحالتين كان الفارق عن الأساليب المنافسة كبيرًا، وانتقل التعلم العميق بعد ذلك إلى الاكتشاف والتقسيم لا إلى التصنيف فقط.
إذا حُسب الفارق على الرقم الأكثر تداولًا: 26.2 ناقص 15.3 يساوي 10.9 نقطة مئوية. ونسبة هذا الفارق إلى خطأ الوصيف 10.9 ÷ 26.2، أي قرابة 41.6% انخفاضًا نسبيًا في الخطأ. وعلى المقارنة الأضيق ببيانات المسابقة وحدها: 26.2 ناقص 16.4 يساوي 9.8 نقطة، أي قرابة 37.4% انخفاضًا نسبيًا. الحسابان مشتقان هنا من الرقمين المنشورين في الورقة وسجلات المسابقة، وهما يوضحان لماذا عُدّ عام 2012 انعطافًا: التحسن لم يكن جزءًا من نقطة كما في الأعوام السابقة. لا يجوز قراءة 15.3% على أنها دقة أنظمة اليوم، ولا على أنها أداء بشري. حين قدّر روسكوفسكي وزملاؤه الخطأ البشري على المهمة نفسها، بلغ خطأ أفضل خمس فئات لدى شارح خبير 5.1% على 1500 صورة اختبار، بعد تدريب على 500 صورة، بينما بلغ الخطأ لدى شارح آخر 12% على عينة أصغر، وقدّروا حدًا متفائلًا قرب 2.4%. الرقم إذًا مشروط بطريقة القياس، ومهمة الألف فئة ليست بدهية حتى للإنسان لأن الفئات تتداخل.
بعد ذلك اتسع الانتباه الذاتي إلى الصورة، ثم النماذج التي تُدرَّب ذاتيًا على بيانات غير موسومة، ثم نماذج تربط الرؤية باللغة وتقبل مطالبات لتقسيم الصور والفيديو. الخط التاريخي المهم ليس قائمة الأسماء، بل تبدل السؤال المنهجي: من قاعدة هندسية، إلى خاصية يدوية مع مصنّف، إلى تمثيل يتعلم من البيانات، إلى نموذج عام يُكيَّف. ولا تلغي مرحلة ما قبلها حين تكون الهندسة هي المطلوبة.
اقرأ أيضاً: التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
| المرحلة الزمنية | المرحلة العلمية | الحدث أو الاكتشاف | الأدوات المستخدمة | التحديات | الأثر العلمي |
|---|---|---|---|---|---|
| 1963 | هندسة الأجسام | رسالة لورنس روبرتس في معهد ماساتشوستس للتقانة عن إدراك المجسمات ثلاثية الأبعاد | خطوط وحواف وهندسة لمتعددات سطوح واضحة الحدود | المشهد الواقعي فيه نسيج وظل وحجب وإضاءة لا تُختصر إلى حواف مثالية | نص مؤسس لإدراك أجسام ثلاثية من صورها |
| العقود التالية حتى 2004 | خصائص مصممة يدويًا | تطوير كواشف الحواف والزوايا، ونشر ديفيد لو تحويل الخصائص SIFT عام 2004 | كواشف الحواف والزوايا، وأوصاف محلية، ومصنّفات إحصائية، وهندسة متعددة المناظر | جودة القرار مرهونة بجودة ما صممه المهندس يدويًا | أساس المعايرة والمطابقة الهندسية وإعادة البناء |
| 2012 | التعلم العميق | فوز أليكس نت بتحدي ImageNet بخطأ أفضل خمس فئات 15.3% (16.4% ببيانات المسابقة وحدها) مقابل 26.2% للوصيف | شبكة التفافية، ومجموعات بيانات كبيرة، ووحدات معالجة الرسوميات (GPU) | نتائج أشد ارتباطًا بتوزيع بيانات التدريب وأصعب تفسيرًا خطوة بخطوة | انتقال التعلم العميق إلى الاكتشاف والتقسيم لا إلى التصنيف فقط |
| 2020 | المحولات البصرية | الورقة المؤسسة للمحول البصري ViT التي تعامل الصورة كسلسلة رقع 16×16 بكسلًا | الانتباه الذاتي ورقع الصورة | يحتاج بيانات أكثر ولا يحمل فرض الجوار في تصميمه | بلغ أفضل نموذج 88.55% على ImageNet بعد التدريب على JFT |
| 2024 | النماذج الأساسية والتقسيم الموجه | SAM 2 من ميتا: تقسيم موجه للصور والفيديو بذاكرة تتدفق مع الإطارات | بنية محولات مع ذاكرة زمنية، ومجموعة SA-V (35.5 مليون قناع في 50.9 ألف فيديو) | الجسم الشفاف والازدحام الشديد والحدود الدقيقة غير مضمونة | تقدم موثق في التقسيم الموجه، لا حل لكل مسائل التقسيم |
أين تُستخدم رؤية الحاسوب؟
القيمة ليست في اسم القطاع، بل في المهمة البصرية داخل القطاع.
في المركبات ذاتية القيادة وأنظمة النقل، تكتشف الرؤية السيارات والمشاة والراكبين، وتقرأ الإشارات والخطوط، وتقدر العوائق، وتتابع الأجسام المتحركة، وتسهم في فهم مشهد الطريق. هي جزء من منظومة إدراك تضم غالبًا رادارًا أو ليدارًا وخرائط، لا عينًا وحيدة يُعلَّق عليها الأمان كله. فشل كاميرا في شمس منخفضة أو مطر ليس فشلًا هامشيًا إن لم يكن هناك حساس آخر يعوّض.
في الروبوتات، تربط الرؤية الإدراك بالفعل: التعرف على قطعة، وتقدير موضعها واتجاهها من أجل المسك، وتجنب العوائق، وبناء خريطة أثناء الحركة. الخطأ في الموضع بالميليمتر قد يفسد الإمساك وإن كانت الفئة صحيحة.
في المصانع تُستخدم منظومات رؤية الآلة لفحص العيوب، وقياس الأبعاد، والتحقق من التجميع، وقراءة الرموز، وفرز القطع، وتوجيه الذراع. كثير من هذه المهام يعمل بإضاءة مصممة وقاعدة هندسية لأن المطلوب قياسًا قابلاً للتدقيق لا تسمية تقريبية.
في الزراعة يساعد التحليل على تمييز المحصول من العشب الضار، ومراقبة النمو، وتقدير الغطاء النباتي، وقراءة صور الحقول الملتقطة من طائرات مسيّرة. التغير في مرحلة النمو ولون التربة بين المناطق يجعل نقل نموذج من مزرعة إلى مزرعة مسألة تعميم لا مجرد تشغيل.
في الاستشعار عن بُعد تُصنَّف أغطية الأرض، وتُرصد الغابات والمياه والمباني والطرق، وتُقارن الصور عبر الزمن لاكتشاف التغير. مجموعة VME مثال بحثي حديث على أن اكتشاف المركبات من الفضاء في مدن الشرق الأوسط احتاج بيانات من المنطقة نفسها، لأن النماذج المدربة في جغرافيا أخرى تراجعت. الاستخدام العربي هنا ليس شعارًا؛ فشل التعميم الجغرافي موثق في مسألة محددة: مركبات في صور عالية الدقة.
وفي المملكة العربية السعودية تعمل منصة «سواهر» ضمن منظومة الهيئة السعودية للبيانات والذكاء الاصطناعي (سدايا)، وللهيئة قطاع لتقنيات الرؤية الحاسوبية وقطاع لأنظمة المراقبة الذكية تتبعه الإدارة العامة للمنصة. وصفت عرب نيوز المنصة بأنها تحلل تدفقات الصور والفيديو بالذكاء الاصطناعي والرؤية الحاسوبية لاستخلاص مؤشرات مرورية آنية، من مستوى المدينة إلى الشارع، بما في ذلك مواضع الحوادث وتغير أنماط التنقل. وفي تشرين الثاني/نوفمبر 2026 نقلت العربية عن نائب مساعد وزير الداخلية لشؤون التقنية أن أكثر من خمسة آلاف كاميرا في ثمانين موقعًا رُبطت بست عشرة خوارزمية وإحدى وثلاثين لوحة بيانات عبر المنصة لمتابعة كثافة الحشود في الحج ودعم القرار الميداني، مع استخدام الرؤية الحاسوبية وطائرات من دون طيار لتوسيع الرصد. هذه الأرقام أرقام نشر وتشغيل كما أوردها التصريح الصحفي، لا نتائج دقة لنموذج على مجموعة اختبار. والقدرة على تحليل حشود وأجسام في فضاء عام تثير مباشرة سؤال المشروعية: من يُصوَّر، وما مدة الاحتفاظ، وما القرار الذي يُبنى على التنبيه الآلي، وأين تتوقف الآلة ليبدأ مراجعه إنسان.
في الهواتف تدخل الرؤية في التعرف على الوجوه والأشياء، وفي التصوير الحاسوبي الذي يدمج عدة لقطات، وفي قراءة النص عبر الكاميرا، وفي البحث البصري، وفي الواقع المعزز الذي يضع عنصرًا رسوميًا على سطح تقدّره الكاميرا. النتيجة التي يراها المستخدم ملساء، لكنها تعتمد على المهام نفسها: اكتشاف، وتتبع، وتقدير مستوى.
في الأمن والمراقبة تُستخدم الرؤية لاكتشاف الحركة، وتتبع جسم في مشهد، وتنبيه عند اقتراب منطقة، ورصد أنماط غير معتادة. القدرة التقنية لا تساوي جواز الاستخدام. التعرف على الوجه والبيانات البيومترية يتصلان بهوية الشخص لا بجسم مجهول، ويتطلبان سندًا قانونيًا وحدود احتفاظ وسبل طعن، وإلا أصبح الخطأ في المطابقة ضررًا على شخص حقيقي.
وفي البحث العلمي تُحلل الصور الفلكية والجيولوجية والمجهرية وصور التجارب، وتُؤتمت أجزاء من الرصد والتصنيف. الشرط العلمي أن يُعرَف خطأ الأداة، لأن اكتشافًا آليًا في صورة علمية قد يدخل استنتاجًا إن لم تُراجع حدود النموذج.
اقرأ أيضاً:
- الثورة الصناعية الرابعة: الدليل العلمي الشامل للتقنيات التي تعيد صياغة مستقبل البشرية
- الجراحة الروبوتية عن بُعد: كيف يجري طبيب في لندن عملية في نيروبي؟
كيف نقيس دقة أنظمة رؤية الحاسوب؟
ماذا تعني الدقة هنا؟
التنبؤ يُقارن بحقيقة مرجعية (Ground Truth) هي الوسم الذي اتُفق على أنه المرجع في ذلك الاختبار. إذا اختلف المرجع عن الواقع، صار القياس دقيقًا في اتباع الخطأ. الدقة الكلية، أي نسبة الحالات الصحيحة، تخدع حين تكون فئة واحدة غالبة: نظام يقول دائمًا «لا عيب» في خط إنتاج نادر العيوب قد تتجاوز دقته 99% وهو لا يكتشف عيبًا واحدًا.
مقاييس التصنيف
الإحكام (Precision) يسأل: من بين ما أعلن النظام أنه إيجابي، كم كان إيجابيًا فعلًا؟ الاستدعاء (Recall) يسأل: من بين الإيجابيات الحقيقية، كم التقطه النظام؟ المقياس F1 يجمعهما في متوسط توافقي، فيفيد حين نريد التوازن. مصفوفة الالتباس تعرض أين تذهب أخطاء كل فئة: هل يختلط المشاة براكبي الدراجات أم بالخلفية؟ اختيار المقياس يتبع الكلفة. في بعض تطبيقات السلامة يكون تفويت جسم أغلى من إنذار زائد، فيُرفع الاستدعاء وتُراجع الإنذارات. وفي فحص يوقف خط الإنتاج، قد يكون الإنذار الكاذب مكلفًا فيُراعى الإحكام.
كيف يُقاس اكتشاف الأجسام؟
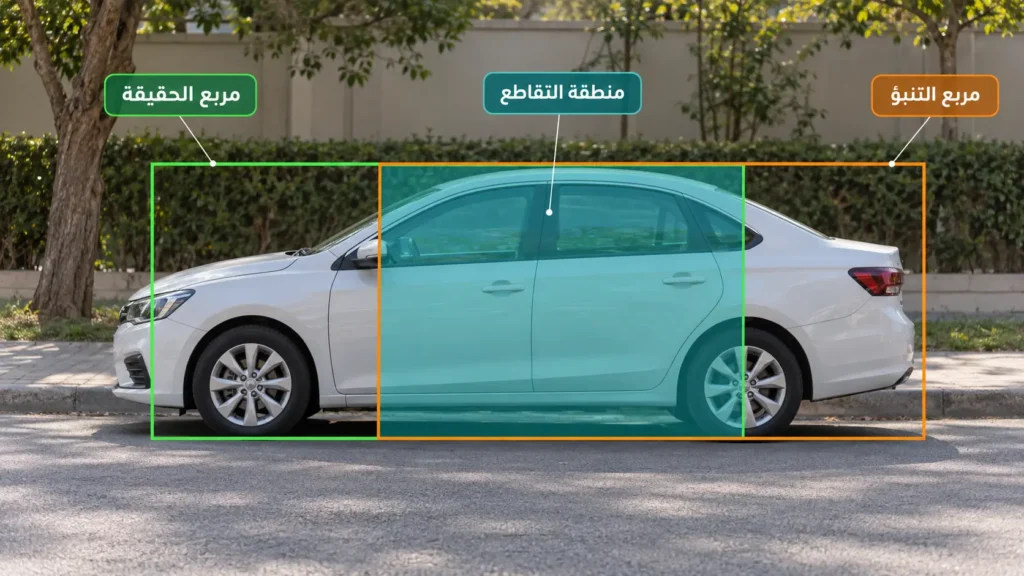
التقاطع على الاتحاد (Intersection over Union, IoU) يقيس تطابق مربع التنبؤ مع مربع الحقيقة:
IoU = |A ∩ B| / |A ∪ B|
مثال هندسي افتراضي، لا نتيجة مجموعة بيانات: مربعان متساويان، طول ضلع كل منهما وحدة واحدة، وإزاحة أفقية فقط مقدارها (s). عندئذٍ يكون
IoU = (1 − s) / (1 + s)
فإذا كانت الإزاحة ثلث الضلع، خرج التقاطع على الاتحاد 0.50 تمامًا، وهو حد شائع كان يُعدّ الاكتشاف عنده صحيح الموضع في تقييمات أقدم. وإذا أردنا 0.75، صارت الإزاحة المسموحة سُبع الضلع فقط، أي نحو 14% من العرض. وإذا أردنا 0.95، نزلت الإزاحة المسموحة إلى 1/39 من الضلع، أي نحو 2.6%. مربع «يبدو قريبًا» بالعين قد يفشل العتبات الصارمة.
متوسط الدقة (Average Precision) يلخص منحنى الإحكام والاستدعاء لفئة عند عتبة تقاطع محددة. ومتوسط متوسط الدقة (Mean Average Precision) يأخذ متوسط ذلك عبر الفئات. بروتوكول COCO لا يكتفي بعتبة 0.50. يحسب المتوسط على عشر عتبات من 0.50 إلى 0.95 بخطوة 0.05، ثم على الفئات، ويجعل هذا المتوسط هو المؤشر الرئيس لأنه يكافئ الموضع الأدق لا الاسم وحده. الصفحة الرسمية للبروتوكول تذكر أيضًا تفصيلًا للأجسام الصغيرة والمتوسطة والكبيرة، لأن اكتشاف جسم كبير أسهل من اكتشاف جسم يشغل بضع عشرات البكسلات. نموذج مرتفع عند عتبة 0.50 ومنخفض عند 0.75 يجد الأشياء تقريبًا ويخطئ في حدودها. في الروبوت والمسافة، الحد هو الذي يهم.
كيف يُقاس التقسيم؟
يُعاد استخدام التقاطع على الاتحاد على المساحات لا على المربعات، ويؤخذ متوسطه عبر الفئات (mIoU). معامل دايس يزن التداخل بنسبة أخرى شائعة في الأقنعة. المقياس الذي يصلح لمنطقة واسعة قد يُخفي خطأ على الحافة الرفيعة. إذا كان القرار الصناعي على عرض خدش، فخطأ الحدود أهم من خطأ في منتصف المنطقة. لذلك يُختار المقياس بعد معرفة ما الذي سيُفعل بالقناع.
هل يكفي رقم دقة واحد؟
لا. سرعة الاستدلال، وزمن الاستجابة، وعدد الإطارات في الثانية، والذاكرة، والطاقة، تحدد إن كان النموذج قابلًا للتشغيل على مركبة أو هاتف أو خط إنتاج. نموذج أدق بنقطتين وأبطأ من زمن الاستجابة المطلوب قد يكون أسوأ لمهمته من نموذج أخف. الاستقرار عند تغير الإضاءة والكاميرا جزء من الجودة لا حاشية عليها. أفضل نموذج هو الذي يحقق التوازن المناسب للمهمة الفعلية، لا صاحب أعلى خانة في جدول واحد.
اقرأ أيضاً: الإحصاء التطبيقي: كيف يحول البيانات إلى قرارات واقعية؟
ما التحديات والقيود؟
الظروف غير المثالية
الضوء الضعيف أو القوي، والضبابية، وزاوية غير مألوفة، والجسم الصغير، والحجب، والازدحام، والجسم الذي لم يظهر في التدريب، كلها تكسر افتراضات ضمنية. النظام لا «يرى رغم ذلك» لأنه نجح في صور واضحة. المعلومات التي يحتاجها القرار قد تكون قد مُحيت من الإشارة.
التعميم على ظروف جديدة
بيئة التدريب ليست بيئة الاستخدام. تغير التوزيع يحدث حين تختلف الكاميرا، أو البلد، أو الطقس، أو نوع الأجسام. ورقة VME تبين نسخة جغرافية من هذا الفشل في صور فضائية. التكيف مع المجال (Domain Adaptation) يحاول تقريب نموذج إلى بيئة جديدة بالاستعانة ببيانات منها، قليلة الوسم غالبًا. التعميم عبر المجالات (Domain Generalization) يأمل أن يصمد النموذج في بيئة لم تُر أصلًا، وهو أصعب والنتائج فيه أضيق. مجموعة اختبار داخلة في التوزيع نفسه لا تكشف هذا الانكسار.
تحيز البيانات
الانحياز في مجموعات الصور موثق بوصفه مشكلة مفتوحة لا عيبًا يُغلق بتكبير العينة. مراجعة فابريتزي وزملائه في Computer Vision and Image Understanding عام 2022 خلصت إلى أنه لا توجد مجموعة خالية من الانحياز، وأن المطلوب إظهار الانحياز لا إنكاره. مصادره تشمل ضعف تمثيل بيئات وفئات، واختلال العدد بين الفئات، ووسومًا تعكس عادات الواسمين، والتقاطًا يتم في أماكن وأوقات معينة. النموذج يتعلم الارتباط الذي يراه. إذا اقترنت فئة بخلفية أو بلون إضاءة، فقد يستخدم هذا الاختصار ويفشل حين ينفصل الاثنان. اكتشاف التحيز يحتاج تقييمًا مقسمًا بحسب المجموعات لا رقمًا كليًا واحدًا، ثم تصحيحًا في الجمع والوسم، لا في حجم الشبكة فقط.
الهجمات العدائية والأمن
الهجمات العدائية (Adversarial Attacks) تعديلات صغيرة في الصورة، قد لا يلاحظها الإنسان، ومع ذلك تغيّر مخرج بعض النماذج. الظاهرة وُصفت في أعمال مبكرة منها بحث سيغيدي وزملائه عام 2014، ولا يعني ذلك أن كل نظام رؤية يُخدع بالملصق نفسه أو بالدرجة نفسها. الخطر يزداد حين يُتخذ قرار آلي من دون مراجعة، وحين يمكن لخصم أن يمس المدخل أو بيانات التدريب. تسميم بيانات التدريب (Data Poisoning) يزرع أمثلة تفسد النموذج قبل نشره. المقاومة تتطلب اختبارًا خصوميًا، وتقييدًا للمدخلات، ومراقبة للبيانات، لا افتراض أن الدقة العادية تكفي.
الخصوصية والمراقبة
تحليل صور الأشخاص، والتعرف على الوجوه، والكاميرات في الأماكن العامة، والاحتفاظ باللقطات، تتجاوز المسألة التقنية إلى الحقوق. الاستخدام في إدارة حشود أو مرور، كما في منظومات الكاميرات واسعة الانتشار، يفرض سؤالًا مزدوجًا: ما دقة التنبيه، وما حدود الغرض والاطلاع والمدة. الخطأ في التعرف على شخص ليس خطأ تصنيف مجردًا. والقدرة على تتبع جسم في فيديو يمكن أن تتحول إلى تتبع إنسان إذا رُبطت الهوية. التصميم المسؤول يبدأ بتحديد الغرض، لا بإضافة النموذج ثم البحث عن ضابط لاحقًا.
لماذا لا تفهم الآلة الصور كما يفهمها الإنسان؟
النموذج يطابق أنماطًا تعلمها. الإنسان يستخدم خبرة فيزيائية وسياقًا وتوقعات تتجاوز الإطار. لذلك قد يقدم النظام تنبؤًا خاطئًا بدرجة ثقة عالية، لأن ثقته دالة في مساحته المتعلمة لا في معرفته بجهله. الحالات غير المألوفة، والعلاقات النادرة، والمشاهد التي تتطلب سببًا لا شبهًا ظاهريًا، تظل مواضع فشل معروفة. التنبؤ الإحصائي ليس فهمًا دلاليًا كاملًا، حتى حين تكون الجملة المرافقة للصورة سليمة لغويًا.
الكلفة ومتطلبات التشغيل
تدريب النماذج الكبيرة مكلف حسابيًا، وتشغيلها في الزمن الحقيقي على روبوت أو هاتف يصطدم بالحرارة والبطارية والذاكرة. المفاضلة بين الدقة وحجم النموذج والطاقة قرار تصميم. ضغط النموذج وتكميمه (Quantization)، أي تمثيل الأوزان بدقة عددية أقل، يقللان الكلفة وقد يقللان الدقة. الرقم الذي يهم في النشر هو السلوك بعد هذا الضغط على الجهاز المستهدف، لا الرقم على خادم التدريب.
اقرأ أيضاً:
- الأمن السيبراني: المبادئ العلمية، بنية الأنظمة، وآليات الحماية الرقمية
- كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
إلى أين تتجه رؤية الحاسوب؟
الاتجاهات الآتية موضوعات بحث واستخدام متفاوت النضج، لا وعودًا بأن الفهم البصري اكتمل.
النماذج الأساسية البصرية تتجه إلى مهام متعددة، وإلى فئات تُوصف لغة لا قائمة مغلقة، وإلى مطالبات توجه التقسيم. حدها أن الاتساع لا يلغي فشل التعميم، وأن تقييمها على مهمة لم تُضبط لها أصعب من تقييم شبكة متخصصة.
التعلم من صور غير موسومة يتقدم عبر التعلم بالمقارنة (Contrastive Learning)، الذي يقرّب تمثيلات التحويلات للصورة الواحدة ويبعد الصور المختلفة، وعبر نمذجة الأجزاء المحجوبة (Masked Image Modeling). هذا يقلل كلفة الوسم، ولا يلغي الحاجة إلى تقييم على وسم بشري موثوق. جودة التمثيل غير الموسوم لا تُرى إلا حين تُختبر على مهمة واضحة.
الفيديو هو الحدود التالية للمهام التي استقرت نسبيًا على الصور: أنشطة، وتتبع طويل، وعلاقات زمنية، وذاكرة لما خرج من الإطار. النموذج الذي ينجح في صورة ثابتة قد يفقد الهوية بعد ثوانٍ.
الرؤية الثلاثية والرباعية الأبعاد، أي المكان مع الزمن، تتقدم في إعادة البناء وفي تمثيل الحركة ودمج الصور مع السحب النقطية. الروبوتات والواقع الممتد والملاحة تستفيد حين يكون المقياس الهندسي مضبوطًا، لا حين تكون النتيجة صورة مقنعة فقط.
على الأجهزة محدودة الموارد تنتقل النماذج الأخف إلى المعالجة على الجهاز (On-Device) والحوسبة الطرفية (Edge Computing) لتقليل التأخير والطاقة وتجنب إرسال كل صورة إلى خادم. التوازن بين الأداء والمورد هو مسألة البحث هنا، لا السباق على أكبر شبكة.
وتتجه الأعمال الأكثر رصانة إلى اختبارات أقرب إلى الفشل الواقعي: إضاءة سيئة، وكاميرات جديدة، وفئات نادرة، وهجمات، وقياس للتحيز. تفسير المخرج، ولو جزئيًا، مطلوب حين يترتب على التنبؤ قرار. تطور المحولات والتعلم الذاتي والنماذج الأساسية اتجاه بارز، وهو لا يغلق الحاجة إلى المعايرة والقياس والأساليب التقليدية حيث تكون الهندسة أدق من التخمين المتعلم.
اقرأ أيضاً:
- ما هو إنترنت الأشياء: وكيف يُغيّر حياتنا ومستقبلنا؟
- الحوسبة السحابية (Cloud Computing): المفهوم، النماذج، والتطبيقات
خرافات شائعة وحقائق علمية
❌ الخرافة: رؤية الحاسوب اسم آخر للتعلم العميق، ولا نظام رؤية من دون شبكة عصبية.
✅ الحقيقة: التعلم العميق غيّر نتائج مهام كثيرة منذ 2012، لكن اكتشاف الحواف، ومطابقة الخصائص مثل SIFT، والمعايرة، والرؤية المجسمة، وما زال من ذلك ما يُبنى بقواعد هندسية أو يُدمج مع التعلم. اختيار الأداة يتبع المهمة لا الموضة.
❌ الخرافة: الحاسوب يرى الصورة كما يراها الإنسان، وإن اختلفت التفاصيل.
✅ الحقيقة: الحاسوب يعالج أرقامًا ويستنتج مخرجات مهمة محددة. ليس في ذلك خبرة فيزيائية عامة ولا فهم للعلاقات لمجرد أن الفئة صحيحة. خطأ واثق في مشهد غير مألوف متوقع من هذا الفرق، لا استثناء نادر.
❌ الخرافة: تصنيف الصورة، واكتشاف الأجسام، وتقسيمها، أسماء لمهارة واحدة.
✅ الحقيقة: التصنيف يسمي، والاكتشاف يسمي ويحدد مربعًا، والتقسيم الدلالي يلون المناطق، وتقسيم الكائنات يفصل الأفراد، والتقسيم الشامل يجمع الاثنين. المقاييس والمخرجات مختلفة، والنجاح في واحد لا يُنقل إلى الآخر.
❌ الخرافة: المحولات البصرية ألغت الشبكات الالتفافية.
✅ الحقيقة: المحولات تتفوق غالبًا حين يتوفر تدريب واسع، بينما تحتفظ الشبكات الالتفافية بميزة عند قلة البيانات بفضل فرضها المحلي. الفروق المنشورة على ImageNet مقابل التدريب على مئات الملايين من الصور توضح أن المسألة مشروطة بالحجم والحساب لا بانتصار دائم.
❌ الخرافة: دقة مرتفعة على مجموعة اختبار شهيرة تعني أن النظام جاهز للعالم الحقيقي.
✅ الحقيقة: مجموعة الاختبار تقيس توزيعًا بعينه. نقل النموذج إلى كاميرا أخرى أو مدينة أخرى أو طقس آخر قد يهبط بالأداء، كما أظهرت تجارب اكتشاف المركبات في صور الشرق الأوسط الفضائية. الزمن والطاقة والحجب والتحيز جزء من الحكم لا حاشية عليه.
التوصية العلمية من موقعنا
- سمِّ المهمة قبل أن تختار النموذج. الفرق بين تسمية صورة وتحديد مربع ورسم قناع وقياس مسافة يغير البيانات والمقياس والخطأ المقبول. كثير من الإحباط في التطبيق يبدأ من نموذج تصنيف طُلب منه أن يتصرف كنظام هندسي.
- اقرأ متوسط الدقة على عتبات التقاطع لا على عتبة واحدة. بروتوكول COCO، بمتوسطه من 0.50 إلى 0.95، يكشف الموضع الرخو الذي تنجيه عتبة 0.50. إذا كان القرار يعتمد على حافة الجسم، فانظر إلى العتبات الصارمة وإلى الأجسام الصغيرة تحديدًا.
- عامل التوزيع الجغرافي والآلي كجزء من الاختبار. مثال المركبات في صور مدن الشرق الأوسط يبين أن نموذجًا مدربًا في جغرافيا أخرى قد يضعف رغم قوة نتائجه الأصلية. أضف صور الكاميرا والطقس والمكان الذي سيُنشر فيه النظام، ولا تكتفِ بمجموعة التدريب نفسها.
- لا تطلب مترًا من صورة واحدة من دون قيد مقياس. استعادة العمق المطلق تحتاج معايرة أو قاعدة مجسمة أو حركة مضبوطة أو جسمًا معروف الحجم. مخرجات العمق الأحادي المتعلم تقريبية حتى يثبت فحص حقلي أنها ليست كذلك.
- قارن الكلفة التشغيلية مع الدقة على الجهاز النهائي. زمن الاستجابة والطاقة بعد ضغط النموذج قد يغيران الترتيب الذي يظهر في ورقة بحث. الشبكة الأكبر ليست الأفضل لروبوت أو هاتف إن فاتت موعد القرار.
- أظهر الانحياز وحدود الأمان قبل النشر على صور الناس. لا توجد مجموعة صور بريئة من الانحياز، والهجمات العدائية ليست خيالًا نظريًا وإن اختلفت شدة تأثيرها بين الأنظمة. في المراقبة والتعرف على الوجه، الغرض النظامي ومدة الاحتفاظ ومراجعة الإنسان للتنبيه شروط علمية وقانونية معًا، لا تحسينات لاحقة.
الصورة رقم. المعنى الذي يُستخرج منها قرار. بين الأمرين سلسلة من الاختيارات: أي مهمة، وأي مستشعر، وأي هندسة، وأي بيانات، وأي مقياس يطابق الكلفة الحقيقية للخطأ. رؤية الحاسوب ناضجة بما يكفي لفرز منتج، وتتبع مركبة، وقراءة لوحة، وبناء سحابة نقطية من صور متعددة، وما زالت ناقصة التحديد كلما طُلب منها أن تستعيد العالم الكامل من أثر ضوء على مستشعر. الإتقان في هذا المجال ليس رفع رقم واحد على مجموعة شهيرة، بل معرفة أي معلومة سقطت في الإسقاط، وأي معلومة عوضها النموذج بتخمين، ومتى لا يجوز بناء فعل على هذا التخمين.
يستند هذا المقال إلى أحدث المعايير والدلائل الإرشادية الرسمية المعتمدة في تقييم أنظمة الرؤية الحاسوبية وإدارة مخاطرها:
- COCO Detection Evaluation: بروتوكول تقييم اكتشاف الأجسام الذي يحسب متوسط الدقة على عتبات تقاطع من 0.50 إلى 0.95.
- NIST AI RMF 1.0 (NIST AI 100-1): إطار إدارة مخاطر الذكاء الاصطناعي من المعهد الوطني الأمريكي للمعايير والتقنية.
- NIST FRTE: تقييمات المعهد الوطني الأمريكي المستقلة لخوارزميات التعرف على الوجوه، ومنها أثر الفروق الديموغرافية في أخطاء المطابقة.
- ISO/IEC 42001:2023: المعيار الدولي لنظام إدارة الذكاء الاصطناعي.
- ISO/IEC 23894:2023: إرشادات إدارة المخاطر المرتبطة بأنظمة الذكاء الاصطناعي.
- ISO/IEC TR 24029-1:2021: تقييم متانة الشبكات العصبية، الجزء الأول: نظرة عامة.
- ISO 21448:2022 (SOTIF) وISO 26262: سلامة الوظيفة المقصودة والسلامة الوظيفية في المركبات، ومنها حدود الإدراك البصري في الظروف غير المتوقعة.
- IEEE 7000-2021: عملية نموذجية لمعالجة الاعتبارات الأخلاقية في تصميم الأنظمة.
- Regulation (EU) 2024/1689 (EU AI Act): الإطار الأوروبي لتصنيف أنظمة الذكاء الاصطناعي بحسب المخاطر، ومنه تقييد استخدامات التعرف البيومتري.
- سدايا (SDAIA): مبادئ أخلاقيات الذكاء الاصطناعي الصادرة عن الهيئة السعودية للبيانات والذكاء الاصطناعي، ونظام حماية البيانات الشخصية في المملكة العربية السعودية.
المصادر والمراجع
موقع خلية لا يتحمل أي مسؤولية قانونية أو علمية أو تقنية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين.
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات