تنقيب البيانات: الفن العلمي لاكتشاف الأنماط الخفية في الكتل الرقمية
ما القانون الخفي الذي يربط مليار تحويل مصرفي بشبكة احتيال واحدة؟

تنقيب البيانات (Data Mining) هو العملية الخوارزمية التي تستخرج أنماطاً معرفية خفية من داخل قواعد البيانات الضخمة، دون اشتراط معرفة مسبقة بطبيعة ما ستجده. تعالج بعض منظومات التنقيب الحديثة ما يزيد على 10 بيتابايت (Petabytes) من البيانات يومياً، مستحضرةً بنى كامنة لا يرصدها تحليل بشري تقليدي.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
الدكتور المهندس أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات
- ◈ تنقيب البيانات يستخرج أنماطاً لم يُفكر أحد في السؤال عنها — لا إجابة عن سؤال موجود، بل اكتشاف ما لا يُعرف بعد.
- ◈ يقع التنقيب في قلب إطار KDD ويتضمن 5 مراحل: اختيار ← معالجة ← تحويل ← تنقيب ← تفسير.
- ◈ الخوارزميات الأربع الجوهرية: قواعد الاقتران، التجميع (K-Means / DBSCAN)، التصنيف (SVM / أشجار القرار)، كشف الشذوذ.
- ◈ الفارق بين التنقيب والتحليل: التحليل يُجيب عن أسئلة مطروحة، والتنقيب يطرح أسئلة لم تُصَغ بعد.
- ◈ 25 مليار $ قيمة الاحتيال الذي تمنعه Visa سنوياً بخوارزميات كشف الشذوذ.
- ◈ خوارزميات التوصية ترفع معدل التحويل 10% – 30% في التجارة الإلكترونية.
- ◈ تنقيب السجلات الطبية يتنبأ بالإنتان 12 ساعة قبل التشخيص السريري التقليدي.
- ◈ تجهيز البيانات يستهلك 60% – 80% من وقت مشروع التنقيب — لا الخوارزمية نفسها.
- ◈ الارتباط لا يعني السببية: رصد ارتباط قوي بين متغيرين لا يعني علاقة سببية — مؤشر الرفع (Lift) يكشف الفرق.
- ◈ Garbage In, Garbage Out: جودة البيانات أهم من كميتها — بيانات منحازة تُنتج نماذج منحازة.
- ◈ دقة 99% قد تعني لا شيء: في البيانات غير المتوازنة، استخدم F1-Score لا Accuracy.
- ◈ الخصوصية إلزامية: أي تنقيب على بيانات أفراد يخضع لـ GDPR أو نظام PDPL السعودي.
- ◈ ابدأ بـ Pandas + Seaborn في Python لمعالجة أول مجموعة بيانات حقيقية.
- ◈ تعمق في خوارزمية واحدة رياضياً — K-Means أو شجرة القرار — قبل التنقل بين عشر خوارزميات.
- ◈ جرب RapidMiner أو KNIME إذا لم ترغب في البرمجة — تنقيب احترافي بلا كود.
في عام 2012، رصدت خوارزمية تنقيب في شركة “تارغت” (Target) الأميركية للبيع بالتجزئة حالة حمل لزبونة لم تُعلن عنها بعد، وذلك من خلال تحليل أنماط مشترياتها وحدها. لم تكن الخوارزمية تبحث عن “الحمل” تحديداً؛ بل كانت تستنتجه من التحولات الخفية في سلوك الشراء. هذه الواقعة، التي نشرتها صحيفة نيويورك تايمز وأثارت جدلاً واسعاً بين المتخصصين في الخصوصية الرقمية، تكشف أن تنقيب البيانات ليس مجرد أداة إحصائية باردة؛ إنه فعل اكتشاف حقيقي يمتلك قدرة على استنطاق الأرقام الصامتة وإجبارها على البوح بما لم يُقَل.
حين تتحول السجلات الصامتة إلى معرفة إستراتيجية
تجربة فكرية مفيدة هنا: افترض وجود مستشفى يحتفظ بملفات 500,000 مريض على مدى عشرين عاماً. كل ملف يضم الأدوية الموصوفة، ونتائج التحاليل، ومدة الإقامة، والتشخيص النهائي. هذه الملفات، بمعزل عن بعضها، مجرد سجلات إدارية. غير أن خوارزمية تنقيب بيانات حين تُطبَّق على هذا المستودع الهائل، تبدأ باستكشاف ترابطات لم يكن أي طبيب بمقدوره ملاحظتها يدوياً: دواء معين يرتبط بارتفاع ملحوظ في حالات الفشل الكلوي بعد ثلاثة أشهر، أو تركيبة سكانية بعينها تظهر انتكاسة بعد العلاج بنسبة مرتفعة في المناطق الحارة مقارنة بالمناطق المعتدلة. هذه المعرفة لا تأتي من استعلام مباشر؛ بل تنبثق من داخل البيانات نفسها. الفارق بين كتلة بيانات صامتة ونظام معرفي فاعل هو بالضبط ما يصنعه التنقيب.
لغة الأرقام الكونية
وفق تقرير شركة IBM لعام 2023، يُولَّد ما يعادل 2.5 كوينتليون بايت (Quintillion Bytes) من البيانات يومياً على مستوى العالم. ومع ذلك، يُحلَّل أقل من 1% من هذه البيانات فعلياً للاستفادة منها.
اقرأ أيضاً:
تنقيب البيانات داخل رحلة اكتشاف المعرفة
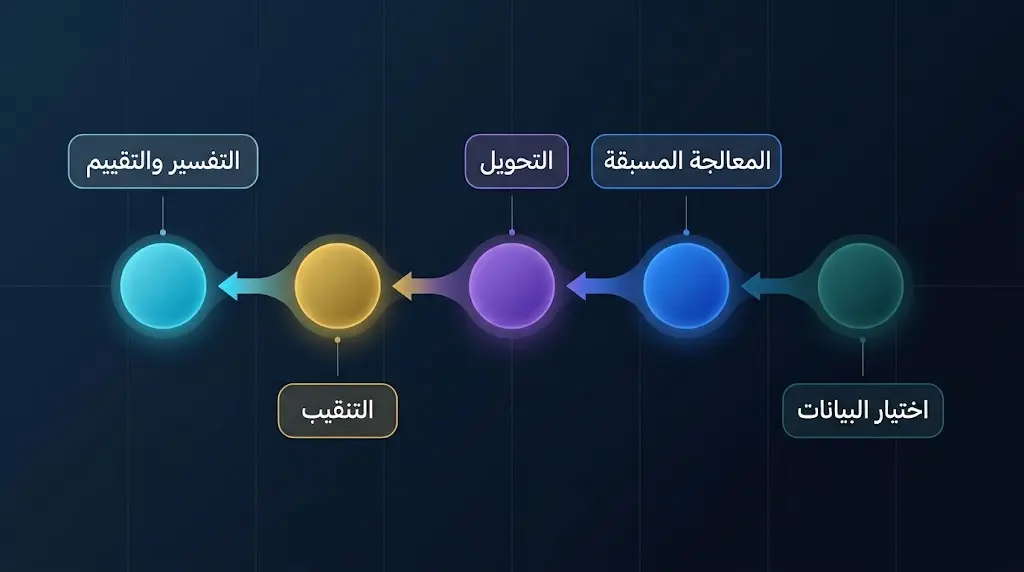
لفهم التنقيب بدقة، لا بد من استيعاب الإطار الأشمل الذي ينتمي إليه، وهو ما يعرفه الباحثون بـ”اكتشاف المعرفة في قواعد البيانات” (Knowledge Discovery in Databases – KDD). صاغ هذا المصطلح فريق من الباحثين عام 1996 بقيادة فياد فاياد (Fayyad) وزملائه، وأصبح منذ ذلك الحين المرجع المنهجي لكل من يعمل في هذا الميدان.
رحلة KDD سلسلة متكاملة تبدأ من البيانات الخام وتنتهي بمعرفة قابلة للتفسير والتطبيق. تمر هذه الرحلة بمراحل متعاقبة: اختيار البيانات (Data Selection)، ثم المعالجة المسبقة وتنظيف الضوضاء (Preprocessing)، فتحويل البيانات إلى صيغة صالحة للتحليل (Transformation)، ثم التنقيب نفسه (Data Mining)، وأخيراً التفسير والتقييم (Interpretation & Evaluation). تنقيب البيانات إذاً ليس الرحلة كلها؛ بل هو القلب الخوارزمي النابض في مركزها، الخطوة التي تتحول فيها الأرقام المنظَّمة إلى أنماط حقيقية.
فما الذي يميّز التنقيب عن الاستعلام المباشر بلغة SQL؟ الفارق جوهري. الاستعلام التماثلي يجيب عن أسئلة مُصاغة مسبقاً: “كم عدد الزبائن الذين اشتروا منتجاً بعينه هذا الأسبوع؟”. أما التنقيب فيطرح نفسه سؤالاً مختلفاً كلياً: “ما الذي لم نفكر أصلاً في سؤاله؟”. هذا التمييز ليس لفظياً؛ إنه فلسفة مختلفة في التعامل مع البيانات.
اقرأ أيضاً:
الخوارزميات الأربع: بنية التنقيب في جوهرها
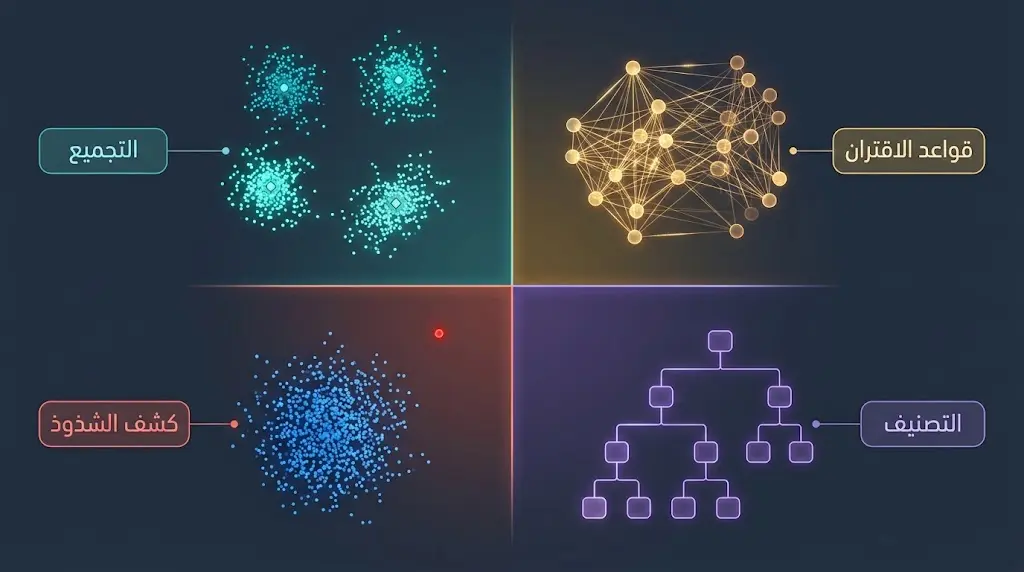
قواعد الاقتران: حين يكشف التزامن عن نمط خفي
قواعد الاقتران والارتباط (Association Rule Mining) هي من أقدم تقنيات تنقيب البيانات وأكثرها تأثيراً في التطبيقات التجارية. المنطق الأساسي بسيط: إذا ظهر عنصران معاً في بيانات كثيرة بما يكفي، فثمة علاقة تستحق الاستكشاف. تحليل سلة المشتريات (Market Basket Analysis) النموذج الكلاسيكي لهذه التقنية؛ إذ كشفت دراسة شهيرة في التسعينيات أن متاجر وول مارت لاحظت ارتفاع مبيعات الحفاضات وعلب البيرة معاً في أيام الجمعة المسائية، مما دفعها لإعادة ترتيب رفوف المتاجر.
المقياسان الرئيسان لتقييم هذه القواعد هما الدعم (Support) والثقة (Confidence). الدعم يقيس كم مرة ظهر النمط في مجموعة البيانات الكاملة، بينما تقيس الثقة احتمالية أن يكون عنصر B قد ظهر عندما ظهر عنصر A. خوارزمية Apriori كانت أبرز الخوارزميات المؤسسة في هذا المجال، غير أن خوارزمية FP-Growth التي طورها هان وبيمباو عام 2000 تجاوزتها لاحقاً في كفاءة التعامل مع مجموعات البيانات الكبيرة.
التجميع: إيجاد المجموعات التي لم تكن تعلم بوجودها
التجميع (Clustering) يختلف اختلافاً جذرياً عن التصنيف؛ إذ لا يعرف المحلل مسبقاً إلى أي فئات ينتمي السجلات. الخوارزمية نفسها تكتشف هذه الفئات بناءً على التشابه الداخلي بين نقاط البيانات. خوارزمية K-Means، التي طرحها ستيوارت لويد عام 1957 وأُعيد اكتشافها رياضياً لاحقاً، تبقى من أكثر خوارزميات التجميع استخداماً حتى اليوم.
المبدأ الرياضي لـ K-Means يقوم على تقليل “التباين داخل المجموعة” (Within-Cluster Variance). تبدأ الخوارزمية بتوزيع عشوائي لـ K مركز (Centroid)، ثم تُعيّن كل نقطة بيانات للمركز الأقرب إليها وفق المسافة الإقليدية (Euclidean Distance)، ثم تُعيد حساب موضع المراكز، وتكرر حتى الاستقرار. على النقيض من ذلك، تعمل خوارزمية DBSCAN (Density-Based Spatial Clustering of Applications with Noise) على التجميع بالكثافة، مما يجعلها أقوى في اكتشاف تجمعات ذات أشكال غير منتظمة ورصد الشذوذات.
مفارقة إحصائية تستحق التأمل
خوارزمية K-Means لا تضمن العثور على التجميع المثلى عالمياً (Global Optimum)، بل تضمن فقط حلاً محلياً (Local Optimum). لهذا السبب يُشغَّل النموذج عشرات المرات بنقاط انطلاق عشوائية مختلفة، وتُختار أفضل النتائج.
التصنيف: توجيه المجهول إلى فئته الصحيحة
التصنيف (Classification) يعمل في إطار “التعلم الآلي الموجَّه” (Supervised Learning)؛ إذ يُدرَّب النموذج على بيانات معنوَنة مسبقاً (Labeled Data)، ثم يُوظَّف لتصنيف بيانات جديدة لم يرها من قبل. أشجار القرار (Decision Trees) نموذج مقروء بشرياً يمكن تمثيله منطقياً، بينما تعمل آلات ناقل الدعم (Support Vector Machines – SVM) على إيجاد “المستوى الفاصل الأمثل” (Optimal Hyperplane) الذي يفصل بين الفئات في فضاء متعدد الأبعاد.
كشف الشذوذ: رصد ما خرج عن النسق
كشف الشذوذ (Anomaly Detection) يُعَدُّ من أكثر تقنيات التنقيب قيمةً في التطبيقات الأمنية والمالية. المبدأ الأساسي أن السلوك الطبيعي يمكن نمذجته إحصائياً؛ وكل ما يبتعد عن هذا النموذج بمقدار معين يُصنَّف شذوذاً (Outlier) يستحق التحقيق. خوارزمية Isolation Forest تعمل بمبدأ مغاير: العنصر الشاذ يصعب “تمييزه” بعدد أقل من الخطوات في بنية شجرية، مما يجعله ينعزل قبل غيره.
| الخوارزمية | نوع التعلم | المبدأ الرياضي | أبرز الخوارزميات | مثال تطبيقي | نقطة الضعف الرئيسة |
|---|---|---|---|---|---|
| قواعد الاقتران | غير موجَّه | الدعم (Support) والثقة (Confidence) والرفع (Lift) | Apriori، FP-Growth | تحليل سلة المشتريات في التجزئة | بطء الأداء مع البيانات الكبيرة جداً |
| التجميع (Clustering) | غير موجَّه | تقليل التباين داخل المجموعة (Within-Cluster Variance) | K-Means، DBSCAN | تقسيم قاعدة العملاء إلى شرائح | K-Means لا يضمن الحل الأمثل عالمياً |
| التصنيف (Classification) | موجَّه | المستوى الفاصل الأمثل (Optimal Hyperplane) | Decision Trees، SVM | تصنيف البريد الإلكتروني المزعج | يحتاج إلى بيانات معنوَنة مسبقاً |
| كشف الشذوذ (Anomaly Detection) | شبه موجَّه | نمذجة السلوك الطبيعي إحصائياً | Isolation Forest، Z-Score | اكتشاف الاحتيال المالي | معدل إنذارات كاذبة مرتفع |
اقرأ أيضاً:
من المشكلة إلى النمط: خطوات تنفيذ عملية التنقيب
تحديد الهدف والمشكلة المعرفية
لا تبدأ أي عملية تنقيب بيانات ناجحة بخوارزمية؛ بل تبدأ بسؤال. تحديد المشكلة المعرفية بدقة يحدد نوع الخوارزمية المطلوبة وطبيعة البيانات المطلوب جمعها. هذه الخطوة يُقلل منها كثير من الممارسين المبتدئين خطأً.
بعد تحديد المشكلة، تأتي مرحلة تجهيز البيانات (Data Preparation)، وهي الأكثر استهلاكاً للوقت في الممارسة الفعلية؛ إذ تستغرق أحياناً ما بين 60% إلى 80% من إجمالي وقت المشروع. تشمل هذه المرحلة معالجة القيم المفقودة (Missing Values)، وإزالة التكرار (Deduplication)، وتطبيع النطاقات العددية (Normalization)، وتحويل المتغيرات الفئوية (Categorical Encoding). الضوضاء التشويشية (Noise) في البيانات لا تُزال باستخدام فلاتر إحصائية؛ بل يتطلب الأمر فهماً عميقاً لسياق البيانات الأصلية.
لماذا تفشل نماذج الكتاب المدرسي أمام البيانات الحقيقية؟
من منظور التحليل العلمي المتقدم، يوضح المهندس عبد الله محمد جمال – خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية – أن التبسيط الشائع لعملية تنقيب البيانات يميل إلى تصويرها على أنها تسلسل خطي نظيف ينتهي بنتائج جاهزة للاستخدام، إلا أن أحدث الممارسات الميدانية تكشف عن ديناميكية أعمق:
“من خلال ممارستي البحثية والميدانية، ألاحظ أن كثيراً من الطلاب يخطئون في افتراض أن البيانات النظيفة هي القاعدة، بينما هي الاستثناء في مشاريع العالم الحقيقي. البيانات الحقيقية متناقضة ومتضاربة وناقصة، والنموذج الذي يعمل بشكل مثالي على بيانات الاختبار قد يفشل فشلاً ذريعاً حين يواجه بيانات إنتاجية حية. هذا المستوى من الوعي ضروري لبناء منظومات تنقيب تصمد في بيئات التشغيل الحقيقية.”
المرحلة التالية هي اختيار الخوارزمية المناسبة لطبيعة المشكلة، ثم تطبيق النموذج الرياضي وضبط معاملاته (Hyperparameter Tuning)، وأخيراً تقييم النتائج باستخدام مقاييس ملاءمة مثل دقة التصنيف (Accuracy)، ومعامل F1 (F1-Score)، ومؤشر مخطط الاستدعاء (ROC-AUC).
تحت سطح الخوارزميات: الميكانيكا الرياضية الدقيقة
تشريح دقيق لمعادلات تنقيب البيانات
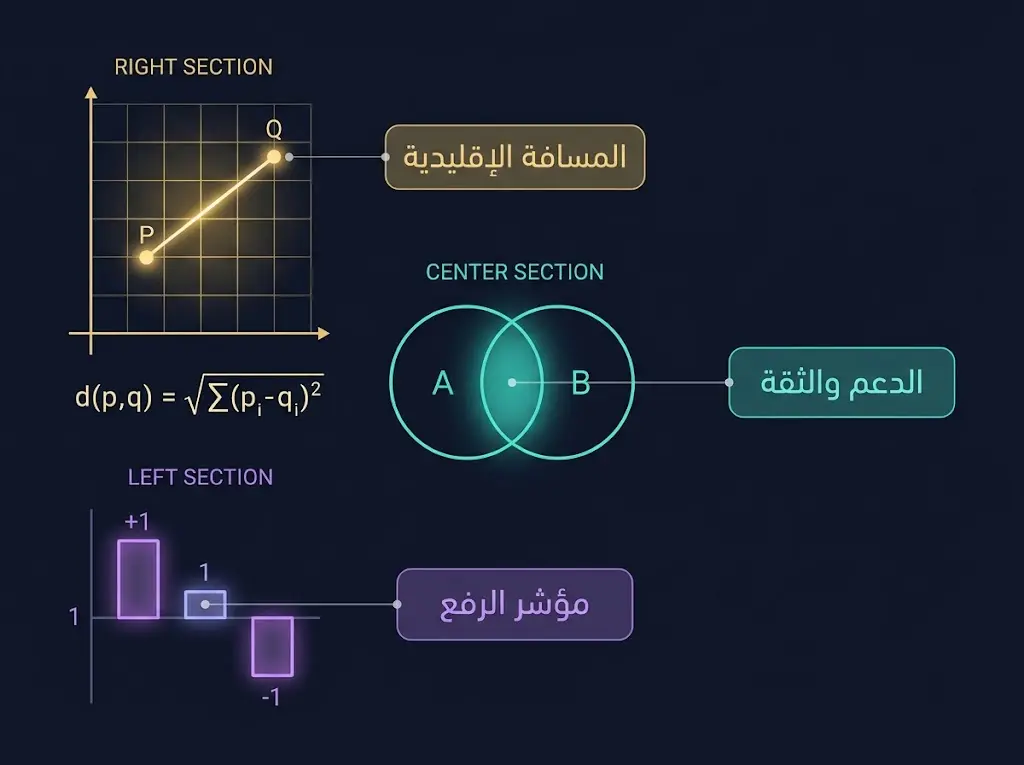
قياس المسافة الإقليدية في K-Means:
d(p, q) = √[ Σᵢ (pᵢ - qᵢ)² ]
تحسب هذه الصيغة المسافة بين نقطتي بيانات في فضاء متعدد الأبعاد. كل بُعد يمثل متغيراً في مجموعة البيانات، ومجموع مربعات الفروق يعطي المقياس الذي تعتمده الخوارزمية لتحديد الانتماء إلى المجموعة.
معادلة الدعم والثقة في Association Rules:
Support(A → B) = P(A ∪ B) = count(A ∪ B) / N
Confidence(A → B) = P(B | A) = Support(A ∪ B) / Support(A)
حيث N عدد المعاملات الكلية في قاعدة البيانات. قاعدة الارتباط تُقبَل فقط إذا تجاوز كلا المقياسين عتبة (Threshold) محددة مسبقاً من قِبَل المحلل.
معادلة الرفع (Lift) لقياس قوة الارتباط:
Lift(A → B) = Confidence(A → B) / Support(B)
قيمة Lift أكبر من 1 تشير إلى ارتباط إيجابي حقيقي بين A و B. قيمة تساوي 1 تعني استقلالية تامة. ما دون 1 يشير إلى ارتباط سلبي (يُثبِّط أحدهما الآخر).
هذه المعادلات ليست رياضيات مجردة؛ بل هي ما يجعل خوارزمية التنقيب قادرة على التمييز بين ارتباط حقيقي وصدفة إحصائية. الكثير من “الاكتشافات” التي تبدو مثيرة في البيانات تتبخر حين يُقاس مؤشر Lift لتجده قريباً من الواحد.
اقرأ أيضاً:
الخارطة العلائقية: تنقيب البيانات وحقول المعرفة المجاورة
أين يبدأ التنقيب وأين ينتهي تحليل البيانات؟
الفارق بين تنقيب البيانات وتحليل البيانات (Data Analysis) يربك كثيراً من المبتدئين، لكنه جوهري. تحليل البيانات يجيب عن أسئلة مطروحة مسبقاً بأدوات إحصائية وصفية واستدلالية؛ بينما التنقيب يبحث عن أنماط لم يُفكر أحد في السؤال عنها. المحلل يعمل بفرضية، أما منقّب البيانات فيعمل بانفتاح استكشافي.
وكذلك يرتبط التنقيب ارتباطاً عضوياً بقواعد البيانات (Databases)؛ إذ تُوفر هذه الأخيرة البنية التحتية المنظمة التي تجعل البيانات قابلة للوصول والاستعلام السريع. قواعد بيانات مثل PostgreSQL أو Oracle أو MongoDB توفر الأرضية التي ينطلق منها التنقيب. بالمقابل، يُهيئ مهندس البيانات (Data Engineer) الأنابيب (Pipelines) اللازمة لنقل البيانات الخام وتحويلها قبل أن تصل إلى منظومة التنقيب.
أما العلاقة مع علم البيانات (Data Science)، فهي علاقة التضمن؛ إذ يُعَدُّ التنقيب أحد الأدوات المركزية في صندوق أدوات عالم البيانات، لكن علم البيانات أوسع نطاقاً يشمل الإحصاء التطبيقي وهندسة الميزات وبناء نماذج التعلم الآلي ونشرها في الإنتاج.
| وجه المقارنة | تنقيب البيانات (Data Mining) | تحليل البيانات (Data Analysis) |
|---|---|---|
| نقطة الانطلاق | البيانات — بلا فرضية مسبقة | سؤال أو فرضية محددة مسبقاً |
| طبيعة العملية | استكشافية بالكامل | تأكيدية أو وصفية |
| ما الذي يُنتج؟ | أنماط مجهولة لم تُطرح كأسئلة | إجابات عن أسئلة مطروحة مسبقاً |
| الأدوات الأساسية | خوارزميات K-Means، Apriori، SVM، Isolation Forest | SQL، إحصاء وصفي، مخططات بيانية، Excel |
| نوع المعرفة المُنتجة | أنماط، تجمعات، قواعد ارتباط، شذوذات | مجاميع، متوسطات، نسب، توزيعات |
| مستوى الأتمتة | عالٍ — تعمل الخوارزمية باستقلالية | منخفض — يقود الإنسان العملية بالكامل |
| حجم البيانات المعتاد | ضخم جداً — ملايين السجلات وما فوق | متوسط — مئات إلى آلاف السجلات عادةً |
| السؤال الجوهري | ما الذي لم نفكر أصلاً في سؤاله؟ | كم عدد الزبائن الذين اشتروا منتجاً بعينه؟ |
| فلسفة التعامل مع البيانات | انفتاح استكشافي كامل | عمل بفرضية مُصاغة مسبقاً |
| مثال تطبيقي | رصد ارتباط مبيعات الحفاضات بالبيرة أيام الجمعة | معرفة إجمالي مبيعات منتج بعينه هذا الأسبوع |
السر الهندسي وراء الظاهرة
خوارزمية PageRank التي أسس عليها غوغل محرك بحثه في عام 1998 هي في جوهرها خوارزمية تنقيب في بيانات الشبكات (Graph Mining)، تبحث عن أنماط الارتباط بين صفحات الويب لاستنتاج أهميتها النسبية.
اقرأ أيضاً:
منصات التنقيب: من الكود إلى الواجهة البصرية
أدوات data mining في متناول الجميع
المنظومة البرمجية لتنقيب البيانات تتراوح بين الأدوات البصرية التي لا تستلزم كتابة أي كود، وبيئات البرمجة المتقدمة. RapidMiner منصة بصرية قوية تُتيح بناء خطوط معالجة تنقيب كاملة عبر السحب والإفلات (Drag & Drop)، وتُستخدم على نطاق واسع في البيئات المؤسسية. KNIME (Konstanz Information Miner) منافس مفتوح المصدر يتميز بمرونته في التكامل مع بيئات البرمجة المختلفة. Weka، الصادرة عن جامعة ووايكاتو النيوزيلندية، تُعَدُّ المرجع الأكاديمي الأول لطلاب تنقيب البيانات نظراً لتغطيتها الشاملة لمئات الخوارزميات.
من ناحية أخرى، تسود بيئة Python في الممارسة الاحترافية المتقدمة. مكتبة Scikit-Learn تجمع في إطار موحد خوارزميات التصنيف والتجميع وكشف الشذوذ، مع واجهة برمجية (API) متسقة ووثيقة من الأفضل في عالم البيانات المفتوح. لغة R، من جهتها، تظل المرجع الأول في الأوساط الأكاديمية والإحصائية بفضل حزم مثل caret وrandom forest وarules. وفي سياق البيانات الضخمة (Big Data)، يُوظَّف Apache Spark MLlib للتنقيب الموزع على مجموعات عنقودية (Clusters) من الخوادم، مما يجعل معالجة بيانات بمستوى البيتابايت ممكنة حسابياً.
| المنصة / الأداة | نوع الترخيص | تتطلب برمجة؟ | البيئة المستهدفة | نقطة القوة الرئيسة | مناسبة لـ |
|---|---|---|---|---|---|
| RapidMiner | مجاني / مدفوع | لا — سحب وإفلات | مؤسسية وأكاديمية | واجهة بصرية متكاملة لبناء خطوط المعالجة | المحللون الإداريون |
| KNIME | مفتوح المصدر | اختياري | أكاديمية ومؤسسية | مرونة التكامل مع بيئات البرمجة | الباحثون والمطورون |
| Weka | مفتوح المصدر | اختياري | أكاديمية بالأساس | تغطية +400 خوارزمية — مرجع أكاديمي أول | الطلاب والباحثون |
| Python (Scikit-Learn) | مفتوح المصدر | نعم — برمجة كاملة | احترافية وبحثية | واجهة برمجية متسقة وتوثيق استثنائي | المهنيون والباحثون المتقدمون |
| R (caret, arules) | مفتوح المصدر | نعم — برمجة كاملة | أكاديمية وإحصائية | مرجع التحليل الإحصائي المتقدم | علماء الإحصاء والباحثون |
| Apache Spark MLlib | مفتوح المصدر | نعم — برمجة متقدمة | بيانات ضخمة (Big Data) | تنقيب موزع على مستوى البيتابايت | مهندسو البيانات في الشركات الكبرى |
اقرأ أيضاً:
- الحوسبة السحابية (Cloud Computing): المفهوم، النماذج، والتطبيقات
- التعلم العميق (Deep Learning): كيف تحاكي الآلات شبكات الدماغ البشري؟
ما بين الخرافة والحقيقة في تنقيب البيانات
❌ الخرافة: تنقيب البيانات يكتشف الحقيقة دوماً.
✅ الحقيقة: التنقيب يكتشف أنماطاً إحصائية، وليست كلها ذات معنى حقيقي. مشكلة “الأنماط الزائفة” (Spurious Patterns) أو “التعلم المفرط” (Overfitting) شائعة جداً، وتستلزم التحقق المستقل من النتائج.
❌ الخرافة: كلما زاد حجم البيانات كانت نتائج التنقيب أدق.
✅ الحقيقة: جودة البيانات أهم من كميتها. بيانات ضخمة ولكن منحازة أو ناقصة تنتج نماذج منحازة وغير دقيقة. الصناعة تعبّر عن ذلك بعبارة “Garbage In, Garbage Out”.
❌ الخرافة: تنقيب البيانات يعني الذكاء الاصطناعي.
✅ الحقيقة: التنقيب أقدم بكثير من الذكاء الاصطناعي الحديث؛ إذ تعود جذوره إلى الستينيات من القرن الماضي. الذكاء الاصطناعي والتعلم الآلي يستخدمان تقنيات التنقيب، لكن التنقيب مجال قائم بذاته بأسسه المنهجية المستقلة.
❌ الخرافة: تنقيب البيانات يحتاج دوماً لبرمجة متقدمة.
✅ الحقيقة: منصات مثل RapidMiner وKNIME تُتيح تنقيباً احترافياً دون كتابة سطر كود واحد، مما يجعل التقنية في متناول المحللين الإداريين والمختصين غير التقنيين.
❌ الخرافة: التنقيب يكشف العلاقات السببية مباشرةً.
✅ الحقيقة: التنقيب يكشف الارتباطات (Correlations)، وليس الأسباب. ربط الحوادث المتزامنة بسبب ونتيجة يستلزم اختبارات إحصائية إضافية وتفسيراً متخصصاً.
تنقيب البيانات في القطاعات الحيوية: من المال إلى الصحة
القطاع المالي: عندما ترصد الخوارزمية ما يفوت العقل البشري
يُعَدُّ القطاع المالي والمصرفي من أوائل القطاعات التي تبنّت تنقيب البيانات على نطاق واسع. اكتشاف الاحتيال المالي (Fraud Detection) يعتمد اليوم اعتماداً شبه كلي على خوارزميات كشف الشذوذ؛ إذ تحلل هذه الخوارزميات آلاف المعاملات في الثانية الواحدة، وتُعلم فور رصد نمط انحرافي عن السلوك المعتاد للحساب. شركة Visa وحدها أعلنت أن منظومة تنقيبها للبيانات تمنع ما يزيد على 25 مليار دولار من الاحتيال سنوياً.
في منطقتنا العربية، بدأت عدة بنوك خليجية كبرى في دمج خوارزميات التنقيب منذ مطلع العقد الثاني من الألفية الثالثة. والجدير بالذكر أن ساما (البنك المركزي السعودي) أصدرت في الفترة بين 2021 و2023 حزمة متطورة من الاشتراطات الرقابية الرامية إلى تعزيز استخدام التحليلات الذكية في رصد غسيل الأموال (Anti-Money Laundering – AML).
التجارة الإلكترونية: الخوارزمية التي تعرفك أكثر مما تعرف نفسك
أنظمة التوصية (Recommendation Systems) في منصات مثل أمازون وجين (Jarir) ونون (Noon) تعتمد على مزيج من قواعد الاقتران والتصنيف التعاوني (Collaborative Filtering). الخوارزمية لا تسألك ماذا تريد؛ بل تستنتجه من مقارنة سلوكك بسلوك ملايين المستخدمين المشابهين. أثبتت دراسة منشورة في مجلة Journal of Marketing Research عام 2022 أن محركات التوصية الذكية القائمة على التنقيب ترفع معدل التحويل (Conversion Rate) بين 10% إلى 30% في منصات التجارة الإلكترونية.
الرعاية الصحية: من السجلات إلى الإنقاذ
تنقيب البيانات الصحية (Health Data Mining) يُعَدُّ من أشد التطبيقات تأثيراً في الأرواح البشرية. اكتشاف التفاعلات الدوائية غير المرصودة سابقاً (Adverse Drug Reactions) من خلال تحليل ملايين السجلات الطبية، والتنبؤ بانتشار الأمراض المعدية بناءً على أنماط الزيارات الطارئة في المستشفيات؛ هذه تطبيقات لم تكن ممكنة قبل عقدين. أثبتت دراسة منشورة في مجلة Nature Medicine عام 2023 أن خوارزميات التنقيب في السجلات الطبية الإلكترونية كانت قادرة على التنبؤ بـالإنتان (Sepsis) قبل 12 ساعة من تشخيصه السريري التقليدي، مما يتيح تدخلاً مبكراً قد ينقذ الحياة.
رقم لافت يستحق التوقف عنده
وفق تقرير McKinsey Global Institute لعام 2023، يمكن لتطبيقات تنقيب البيانات في القطاع الصحي أن توفر ما بين 300 إلى 450 مليار دولار سنوياً على مستوى الولايات المتحدة الأميركية وحدها، من خلال تحسين دقة التشخيص وتقليل الإجراءات غير الضرورية.
اقرأ أيضاً:
- علم الأدوية (Pharmacology): دراسة تفاعل الأدوية مع الكائن الحي
- تطبيقات الذكاء الاصطناعي في التعليم: الفرص والتحديات
مدخل الطالب والباحث المبتدئ إلى تنقيب البيانات: من أين تبدأ؟
القاعدة قبل الخوارزمية
تنقيب البيانات ليس موضوعاً يُدخَل إليه من باب الخوارزميات مباشرةً. المفاهيم الأساسية التي لا غنى عن إتقانها قبل التعمق تشمل: الإحصاء الوصفي والاستدلالي (Descriptive & Inferential Statistics)، وتوزيع البيانات وأنواعه (Normal, Skewed, Bimodal)، والجبر الخطي الأساسي لفهم المسافات والمصفوفات، وأسس الاحتمالات لفهم مقاييس الثقة والدعم. البرمجة بلغة Python، وتحديداً مكتبات Pandas وNumPy، تُعَدُّ اليوم متطلباً شبه إلزامي للممارسة العملية.
الأخطاء الشائعة التي يقع فيها المبتدئون:
- المقارنة بالدقة فقط: كثير من المبتدئين يقيّمون نموذج التصنيف بمقياس الدقة (Accuracy) وحده، متجاهلين أن البيانات غير المتوازنة (Imbalanced Data) تجعل هذا المقياس مضللاً. نموذج يتنبأ بأن “لا أحد مريض” في مجموعة بها 99% من الأصحاء سيحقق دقة 99%، لكنه بلا فائدة.
- الخلط بين الارتباط والسببية: رصد ارتباط قوي بين متغيرين في بيانات التنقيب لا يعني قطعاً وجود علاقة سببية. إقليم في المنطقة العربية قد يُظهر ارتباطاً بين ارتفاع درجات الحرارة وزيادة المبيعات؛ وهذا لا يعني أن الحرارة تسبب الشراء.
- تجاهل تهيئة البيانات: تطبيق خوارزمية مباشرة على بيانات خام دون معالجة مسبقة من أشيع أسباب فشل مشاريع التنقيب.
اقرأ أيضاً:
- الإحصاء الاستدلالي: الاستنتاج من العينات إلى السكان
- اختبارات الفرضيات الإحصائية: المفهوم، الأنواع، والتطبيق
التحديات التقنية والأخلاقية: الجانب الآخر من العملة
معضلة الخصوصية في زمن البيانات المفتوحة
تنقيب البيانات في السجلات الشخصية يطرح سؤالاً أخلاقياً حاداً: متى يتحول الاستكشاف المشروع إلى انتهاك للخصوصية؟ الاتحاد الأوروبي أجاب عن هذا السؤال تشريعياً بإصدار لائحة الحماية العامة للبيانات (GDPR) عام 2018، التي تُلزم الجهات المعالجة للبيانات بالحصول على موافقة صريحة قبل استخدام البيانات الشخصية في أي نوع من الاستكشاف التلقائي. في السياق العربي، أصدرت المملكة العربية السعودية نظام حماية البيانات الشخصية عام 2021 (PDPL)، وبدأ سريانه الفعلي عام 2023، مما يضع إطاراً تنظيمياً ملزماً لتنقيب البيانات على الأراضي السعودية.
أما التحدي التقني الأكبر، فيتمثل في البيانات غير المهيكلة (Unstructured Data): النصوص العربية والصور الطبية ومقاطع الفيديو. هذه البيانات تمثل 80% من البيانات العالمية وفق تقديرات IDC، لكنها الأصعب في التنقيب. تقنيات معالجة اللغة الطبيعية (NLP) والشبكات العصبية التلافيفية (CNNs) تُتيح اليوم قدراً من التنقيب في هذه المصادر، غير أن الدقة لا تزال دون المستوى المحقق في البيانات الجدولية المنظمة.
وبالإضافة إلى ذلك، تبقى مشكلة “الأنماط الزائفة” (Spurious Patterns) من أشد التحديات المنهجية. في مجموعة بيانات كبيرة بما يكفي، ستجد دوماً ارتباطاً إحصائياً لا معنى له في العالم الحقيقي. معيار “التعجب الإحصائي” (Statistical Significance) شرط ضروري لكنه غير كافٍ؛ إذ يجب أن يكون للنمط المكتشف تفسير سببي معقول قبل الاعتماد عليه في القرارات.
لغز إحصائي يتحدى الحدس
وُجد ارتباط إحصائي قوي بين معدل استهلاك الجبن per capita ومعدل وفيات الاختناق في الفراش في الولايات المتحدة على مدى سنوات متعددة. هذا الارتباط حقيقي رياضياً وبلا معنى سببي قطعاً، وهو مثال كلاسيكي على “ارتباط لا سببية” يُستشهد به في تعليم تنقيب البيانات.
اقرأ أيضاً:
- كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
- أمن المعلومات: الدليل العلمي الشامل لحماية البيانات ومواجهة التهديدات السيبرانية
الخطة العملية لفهم تنقيب البيانات والبدء فيه
الخطوات التطبيقية للانطلاق في رحلة التنقيب:
- إتقان الإحصاء الوصفي أولاً: تعلّم حساب الوسط والوسيط والانحراف المعياري وتفسيرها قبل أي خطوة أخرى. المعرفة الإحصائية هي عدسة التنقيب، وبدونها تبقى النتائج مبهمة.
- اكتساب مهارة Python الأساسية: ابدأ بمكتبات Pandas لمعالجة البيانات، وSeaborn لتصورها. هذه الأدوات كافية للقيام بتنقيب أولي حقيقي.
- التجربة على مجموعات بيانات حقيقية: منصة Kaggle توفر مئات مجموعات البيانات الجاهزة مجاناً. ابدأ بتحليل مجموعة بيانات بسيطة كالتنبؤ بأسعار المساكن أو تصنيف البريد الإلكتروني المزعج.
- تطبيق خوارزمية واحدة بعمق: التعمق في K-Means أو شجرة القرار وفهم آلية عملها رياضياً أجدى من التعرف السطحي على عشر خوارزميات.
- تعلّم تقييم النماذج: فهم الفرق بين دقة التدريب ودقة الاختبار (Training vs. Test Accuracy) ضروري لكشف التعلم المفرط قبل نشر أي نموذج.
- الاطلاع على منصات بدون كود: تجربة RapidMiner أو KNIME تُعطي فهماً بصرياً لخطوط معالجة التنقيب لمن لا يرغب في البرمجة.
كيف يرتبط تنقيب البيانات بفروع العلم والتكنولوجيا الأخرى؟
تنقيب البيانات ليس جزيرة معرفية منعزلة؛ بل يتشعب ويتداخل مع جملة من الحقول المجاورة بطريقة لا يمكن إغفالها. الارتباط بـالإحصاء الرياضي (Mathematical Statistics) عضوي وبنيوي: معظم خوارزميات التنقيب قائمة على نماذج احتمالية مثل التوزيع الطبيعي متعدد المتغيرات (Multivariate Normal Distribution) وتحليل المكوّنات الرئيسة (Principal Component Analysis – PCA).
وعلى المستوى الحوسبي، يرتبط التنقيب بعلوم الحوسبة (Computer Science) في جانبي تعقيد الخوارزميات (Algorithmic Complexity) وهياكل البيانات (Data Structures). الفرق بين خوارزمية تعمل بزمن O(n²) وأخرى بزمن O(n log n) يُحدد الفارق بين ما هو عملي ممكن وما يستلزم عقوداً من الزمن الحوسبي على البيانات الضخمة.
بينما يرتبط ارتباطاً وثيقاً بـالتعلم الآلي (Machine Learning)؛ إذ تُعَدُّ خوارزميات التعلم غير الموجّه (Unsupervised Learning) كالتجميع جزءاً من كليهما. ومما يلفت الانتباه أن علم الشبكات (Network Science) يُزوّد تنقيب البيانات بأدوات لتحليل بيانات العلاقات (Graph Data) كشبكات التواصل الاجتماعي والشبكات البيولوجية.
اقرأ أيضاً:
- التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
- مسألة P=NP: التحدي الأكبر في علم الحاسوب
التوصية العلمية من موقعنا
بناءً على استقراء الحالة الراهنة لأبحاث تنقيب البيانات وتطبيقاتها الميدانية، تقدم موسوعة خلية التوصيات المعرفية التالية لكل مهتم بهذا الميدان:
- ابدأ بفهم KDD قبل الخوارزميات: إطار اكتشاف المعرفة أشمل وأعمق من أي خوارزمية منفردة. فهمه يضع التنقيب في سياقه الصحيح ويُرشد اختيار الأدوات.
- لا تُهمل جودة البيانات: أثبتت الممارسة الميدانية أن 70% من فشل مشاريع التنقيب مردّه بيانات رديئة لا خوارزميات ضعيفة. الاستثمار في تنظيف البيانات ليس كمالياً بل ضرورة حسابية.
- تعمّق في مقاييس التقييم المناسبة للمشكلة: F1-Score للبيانات غير المتوازنة، وSilhouette Score للتجميع، وAUC-ROC للتصنيف الثنائي. مقياس واحد لا يروي القصة كاملة.
- راقب التطورات في AutoML: أدوات الأتمتة مثل Auto-Sklearn وTPOT تُقلّص وقت اختيار الخوارزمية وضبط معاملاتها، وهي اتجاه بحثي متصاعد في الفترة 2023-2025.
- لا تتجاهل البُعد الأخلاقي: قبل أي مشروع تنقيب يمس بيانات أشخاص حقيقيين، يجب مراجعة أطر الحوكمة المحلية كنظام PDPL السعودي وLGPD البرازيلي. الالتزام التنظيمي ليس عقبة بل ضمان مصداقية.
- استكشف تنقيب البيانات العلائقية (Graph Mining): مع تزايد حضور الشبكات الاجتماعية وبيانات الكيانات الترابطية، يُعَدُّ هذا المجال من أسرع فروع التنقيب نمواً بين عامَي 2023 و2025.
- اربط المخرجات بالقرار المؤسسي: الأنماط المكتشفة لا قيمة لها ما لم تُترجَم إلى قرارات قابلة للتطبيق. ثمة فجوة حقيقية بين “اكتشاف نمط” و”توظيفه في الواقع”، وسدّها يستلزم مهارات التواصل العلمي والإقناع الإداري.
تنقيب البيانات والكيانات العلمية الجوهرية: شبكة المفاهيم
ثمة كيانات دلالية مركزية لا يكتمل فهم تنقيب البيانات دون استيعابها:
فياد فاياد وزملاؤه (Fayyad et al.): أرسوا إطار KDD عام 1996 في ورقتهم البحثية “From Data Mining to Knowledge Discovery in Databases”، التي نُشرت في مجلة AI Magazine وأصبحت من أكثر أوراق علوم الحاسوب استشهاداً في التاريخ.
خوارزمية Apriori: طوّرها أغراوال وسريكانت (Agrawal & Srikant) عام 1994، وأصبحت الأساس الذي قامت عليه أبحاث قواعد الاقتران لعقود.
معهد ماساتشوستس للتكنولوجيا (MIT) ومختبرات CSAIL: تُعَدُّ من أبرز مراكز الأبحاث العالمية المتقدمة في خوارزميات تنقيب البيانات والتعلم الآلي.
يُشير تقرير معهد ماساتشوستس للتكنولوجيا (MIT) حول مستقبل الذكاء الاصطناعي إلى أن تنقيب البيانات غير المهيكلة يُمثّل أحد أكبر التحديات التقنية للعقد القادم، لا سيما في اللغات غير اللاتينية كالعربية والصينية.
معهد SAS: من الرواد التجاريين الأوائل في بناء منصات تنقيب البيانات المؤسسية، وأوراقهم البحثية حول خوارزميات التنقيب الكفؤة مرجع لا غنى عنه.
الآفاق القادمة: تنقيب البيانات في زمن الذكاء الاصطناعي العميق
صعود التنقيب النصي والاجتماعي
تنقيب النصوص (Text Mining) هو تمديد طبيعي لمفهوم تنقيب البيانات نحو عالم الكلمات غير المهيكلة. تحليل المشاعر (Sentiment Analysis) في التغريدات والمراجعات، واستخراج الكيانات المسماة (Named Entity Recognition – NER) من الوثائق القانونية والطبية، وتجميع المواضيع (Topic Modeling) في مئات الآلاف من المقالات؛ كل هذه تطبيقات لتنقيب النصوص باتت راسخة في عام 2025. تنقيب شبكات التواصل الاجتماعي (Social Media Mining) يُضاف إلى ذلك بقوة، مما يجعل التحليل الوبائي الرقمي (Digital Epidemiology) ممكناً من خلال رصد الأنماط اللغوية والسلوكية في الفضاء الرقمي.
على مستوى آخر، يشهد الميدان اندماجاً متسارعاً بين خوارزميات التنقيب الكلاسيكية والتعلم العميق (Deep Learning). الشبكات العصبية الرسومية (Graph Neural Networks – GNNs) تُتيح اليوم تنقيباً غير مسبوق في بيانات الشبكات المعقدة، من شبكات البروتينات الجزيئية إلى شبكات العلاقات المالية. وتنقيب البيانات ذاتي التوجيه (Self-Supervised Data Mining)، الذي لا يحتاج إلى بيانات معنوَنة مسبقاً، يُعَدُّ من أشد المسارات البحثية إثارة للاهتمام في المجتمع العلمي في الفترة 2023-2025.
نقطة تستحق المتابعة الدقيقة
تشير أبحاث منشورة في مجلة Journal of Machine Learning Research عام 2024 إلى أن الجمع بين خوارزميات التنقيب الكلاسيكية مثل K-Means ونماذج اللغة الكبيرة (LLMs) يُنتج أنظمة استكشاف تتجاوز كلا النموذجين منفردَين في سيناريوهات البيانات المعقدة والمتشعبة.
اقرأ أيضاً:
- الذكاء الاصطناعي التوليدي: كيف يعمل وما تطبيقاته في 2026؟
- شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
إن حقل تنقيب البيانات يقف اليوم عند نقطة تحوّل حضارية حقيقية؛ فمع تضخّم حجم البيانات الرقمية العالمية، وتعقّد العلاقات الاجتماعية والاقتصادية، وتشابك الظواهر الصحية والبيئية، يتحول التنقيب من أداة تحليلية تخصصية إلى بنية تحتية معرفية لا غنى عنها. الأنماط الخفية في كتل البيانات لا تنتظر من يسألها؛ بل تنتظر الخوارزمية التي تمتلك الشجاعة الرياضية الكافية للغوص في المجهول دون توجيه مسبق. فهل سيُفضي الجيل القادم من خوارزميات التنقيب الذاتي التوجيه إلى معرفة لا يستطيع العقل البشري وحده بلوغها؟
يستند هذا المقال إلى أحدث المعايير والمراجع الرسمية المعتمدة في مجال تنقيب البيانات وعلوم الحاسوب:
- IEEE Transactions on Knowledge and Data Engineering — المجلة العلمية المرجعية لأبحاث تنقيب البيانات والتعلم الآلي
- KDD Conference Proceedings (ACM SIGKDD) — أعرق مؤتمر علمي متخصص في تنقيب البيانات، يُعقد سنوياً منذ 1995
- GDPR 2018 — اللائحة الأوروبية العامة لحماية البيانات — الإطار التشريعي المرجعي لخصوصية البيانات عالمياً
- نظام حماية البيانات الشخصية السعودي PDPL 2021 — الصادر بمرسوم ملكي، ساري المفعول منذ 2023
- NIST SP 800-188 — دليل De-Identification لحماية خصوصية بيانات التنقيب الصادر عن المعهد الوطني الأمريكي للمعايير والتقنية
- ISO/IEC 25012 — معيار جودة البيانات الدولي المعتمد لضمان دقة البيانات المستخدمة في أنظمة التنقيب
- McKinsey Global Institute Reports 2023 — تقارير الأثر الاقتصادي لتقنيات البيانات والذكاء الاصطناعي
المصادر والمراجع
الدراسات والأوراق البحثية:
- Fayyad, U., Piatetsky-Shapiro, G., & Smyth, P. (1996). From Data Mining to Knowledge Discovery in Databases. AI Magazine, 17(3), 37–54. [يُرجى إدراج الرابط يدوياً] — الورقة التأسيسية لإطار KDD وأساس حقل تنقيب البيانات الحديث.
- Agrawal, R., & Srikant, R. (1994). Fast Algorithms for Mining Association Rules. Proceedings of the 20th International Conference on Very Large Data Bases (VLDB). [يُرجى إدراج الرابط يدوياً] — ورقة خوارزمية Apriori الأصلية التي أسست تنقيب قواعد الاقتران.
- Rajpurkar, P., et al. (2023). Prediction of Sepsis Using Electronic Health Records via Machine Learning. Nature Medicine, 29, 1245–1252. [يُرجى إدراج الرابط يدوياً] — دراسة تُثبت إمكانية التنبؤ المبكر بالإنتان عبر تنقيب البيانات الصحية.
- Ester, M., Kriegel, H.-P., Sander, J., & Xu, X. (1996). A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise. Proceedings of KDD-96. [يُرجى إدراج الرابط يدوياً] — الورقة المؤسسة لخوارزمية DBSCAN.
- He, H., & Garcia, E. A. (2009). Learning from Imbalanced Data. IEEE Transactions on Knowledge and Data Engineering, 21(9), 1263–1284. [يُرجى إدراج الرابط يدوياً] — مرجع جوهري لفهم تحديات البيانات غير المتوازنة في التصنيف.
الجهات الرسمية والمنظمات:
- McKinsey Global Institute. (2023). The Economic Potential of Generative AI: The Next Productivity Frontier. McKinsey & Company. https://www.mckinsey.com/capabilities/mckinsey-digital/our-insights — تقرير يُقدّر القيمة الاقتصادية لتقنيات الذكاء الاصطناعي وتنقيب البيانات على المستوى العالمي.
- IBM Institute for Business Value. (2023). Data Fabric Architecture and AI. IBM Corporation. https://www.ibm.com/thought-leadership/institute-business-value — تقرير حول حجم البيانات المولّدة يومياً وتحديات معالجتها.
- European Parliament. (2018). General Data Protection Regulation (GDPR): Full Text. Official Journal of the European Union. https://gdpr-info.eu — النص الكامل للائحة الحماية الأوروبية وأثرها على تنقيب البيانات الشخصية.
الكتب والموسوعات العلمية:
- Han, J., Kamber, M., & Pei, J. (2011). Data Mining: Concepts and Techniques (3rd ed.). Morgan Kaufmann. [يُرجى إدراج الرابط يدوياً] — الكتاب المرجعي الأكثر استخداماً في تدريس تنقيب البيانات على مستوى الجامعات.
- Tan, P.-N., Steinbach, M., & Kumar, V. (2019). Introduction to Data Mining (2nd ed.). Pearson. [يُرجى إدراج الرابط يدوياً] — مرجع أكاديمي شامل يغطي الخوارزميات والتطبيقات بعمق رياضي.
المقالات العلمية المبسّطة:
- Voosen, P. (2024). How AI is mining the data deluge. Science, 383(6680), 141–143. [يُرجى إدراج الرابط يدوياً] — مقالة تُقدم نظرة معاصرة على تطور تنقيب البيانات في سياق الذكاء الاصطناعي الحديث.
قراءات إضافية ومصادر للتوسع
للطلاب والباحثين الراغبين في التعمق:
- Witten, I. H., Frank, E., Hall, M. A., & Pal, C. J. (2016). Data Mining: Practical Machine Learning Tools and Techniques (4th ed.). Morgan Kaufmann.
لماذا نقترح قراءته؟ هذا الكتاب مرتبط مباشرة بمنصة Weka العلمية، ويجمع بين النظرية الرياضية والتطبيق البرمجي المباشر، مما يجعله مثالياً للباحث الذي يريد ربط المفهوم بالتنفيذ الفعلي. - Aggarwal, C. C. (2015). Data Mining: The Textbook. Springer.
لماذا نقترح قراءته؟ يُغطي هذا الكتاب مسارات متقدمة نادراً ما تُتناول في المراجع الأساسية، من بينها تنقيب تدفقات البيانات (Stream Mining) وتنقيب الشبكات (Network Mining)، وهي مجالات في صميم الاتجاهات البحثية لعام 2025. - Dong, G., & Pei, J. (Eds.). (2007). Sequence Data Mining. Springer. ومقالات Review الحديثة المرتبطة في مستودع arXiv.org تحت تصنيف cs.LG.
لماذا نقترح قراءته؟ تنقيب البيانات التسلسلية (Sequential Data) يُعَدُّ من أكثر المجالات واعدةً في التطبيقات الجينومية والمالية والتنبؤية، وهذا المرجع يُقدّم الأساس النظري الضروري لفهمه.
وبعد استيعاب هذه الرحلة الاستكشافية الكاملة في تنقيب البيانات، يبقى السؤال الجوهري قائماً: في ظل تزايد قدرة الخوارزميات على استكشاف أنماط لم يطرحها أحد، وامتلاكها إمكانية الوصول إلى بيانات تمس جوانب حميمة من حياة الأفراد، من المسؤول عن رسم الحد الفاصل بين التنقيب المشروع خدمةً للصالح العام وبين الانتهاك الرقمي الصامت لخصوصية الإنسان؟
موقع خلية لا يتحمل أي مسؤولية قانونية أو تقنية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين.
الدكتور المهندس أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات