هندسة البيانات: الشريان المعماري لبناء منظومات الذكاء الاصطناعي
كيف تتحول الفوضى الرقمية إلى بنية تحتية تُغذّي القرارات والأنظمة الذكية؟

هندسة البيانات (Data Engineering) تخصص تقني يُعنى بتصميم البنية التحتية اللازمة لنقل البيانات الخام ومعالجتها وتخزينها وإتاحتها بصيغة قابلة للاستخدام التحليلي والذكائي؛ إذ تُقدَّر الكميات المُولَّدة يومياً من البيانات بما يتجاوز 2.5 كوينتيليون (quintillion) بايت، بحسب تقديرات شركة IBM.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
د. م. أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات
- ◆ 60-73% من بيانات المؤسسات لا تُستخدم قط في أي تحليل فعلي (Gartner). هندسة البيانات هي الحل.
- ◆ 70-80% من وقت عالم البيانات يُصرَف في تنظيف البيانات. البنية الهندسية الناضجة تُعيد هذا التوازن.
- ◆ Apache Kafka تعالج +1 تريليون رسالة يومياً في بيئات الإنتاج الكبرى.
- ◆ نتفليكس تعالج +500 مليار حدث يومياً قبل أن تلمس نماذج التوصية بيانة واحدة.
- ◆ ETL: التحويل قبل التخزين — مناسب للبيانات المهيكلة والبيئات المحلية.
- ◆ ELT: التحميل أولاً ثم التحويل داخل المستودع — معيار السحابة الحديثة مع Snowflake وBigQuery.
- ◆ Data Lakehouse: يجمع مرونة البحيرة مع جودة المستودع عبر معاملات ACID — الخيار المتصاعد 2024.
- ◆ Data Mesh: توزيع ملكية البيانات على الفِرَق المنتجة — يُعيد تعريف دور مهندس البيانات.
- ◆ ابدأ بإتقان SQL المتقدمة وPython — كل أداة أخرى تبنى فوقهما.
- ◆ استخدم dbt لتحويل البيانات داخل مستودعك السحابي — الأداة الأكثر بحثاً في 2023-2024.
- ◆ اختر Apache Airflow لجدولة أنابيبك واتبع مبدأ Idempotency في كل مهمة.
- ◆ لا تُهمل جودة البيانات — أداة Great Expectations تُتيح تعريف الاختبارات تلقائياً في كل تشغيل.
ثمة مفارقة تقنية صارخة يعيشها العالم الرقمي اليوم: المؤسسات الكبرى تمتلك من البيانات ما يكفي لإعادة رسم خرائط أسواقها بالكامل، بيد أن نسبة ضخمة من هذه البيانات تظل حبيسة أنظمة متناثرة غير متصلة، عاجزة عن تقديم أي قيمة. وفي المقابل، تُشير تقارير شركة Gartner إلى أن 60% إلى 73% من بيانات المؤسسات لا تُستخدم قط في أي تحليل فعلي. هنا يتجلى دور هندسة البيانات بوصفها الجسر الحقيقي بين كتل البيانات الضخمة الخام المتراكمة وبين المنظومات الذكية التي تتخذ القرارات وتُدير العمليات.
اقرأ أيضاً:
- علم البيانات: الركيزة العلمية لقيادة الذكاء الاصطناعي وصناعة القرار
- البيانات الضخمة (Big Data): كيف تحرك الأرقام العالم وتصنع مستقبل التكنولوجيا؟
نافذة تطبيقية: مصفاة النفط ومسار البيانات
تتوضح الصورة على نحو أكثر دقة حين يُرصَد سلوك منظومة بيانات في بيئة صناعية كمصافي النفط السعودية. آلاف المستشعرات (Sensors) المنتشرة على طول خطوط الأنابيب تُولّد سيلاً متواصلاً من قراءات الضغط والحرارة والتدفق. هذه القراءات تصل خاماً؛ بعضها ناقص، وبعضها مكرر، وبعضها يحمل قيماً شاذة ناجمة عن اضطراب مؤقت في المستشعر. لا يستطيع نظام الذكاء الاصطناعي المسؤول عن الكشف المبكر عن الأعطال أن يتعامل مع هذه الفوضى الخام مباشرة. ما يحدث بالفعل هو أن أنبوب بيانات مُصمَّم هندسياً يسحب هذه الإشارات، يُنقّيها، يُعيد ترتيبها زمنياً، ثم يُخزّنها في بنية هيكلية محددة قبل أن تلمسها خوارزمية واحدة. هذه العملية، في جوهرها، هي هندسة البيانات.
ما هي هندسة البيانات، وأين يقف مهندسها في منظومة التكنولوجيا؟
هندسة البيانات ليست مجرد عمليات نقل تقني للملفات بين خوادم. إنها تخصص معماري متكامل يشمل التصميم، والبناء، والصيانة، والتأمين لمنظومات البيانات في المؤسسات. يرسم مهندس البيانات (Data Engineer) البنية الكاملة التي تسمح للبيانات بالتدفق من مصادرها الأولى — سواء أكانت قواعد بيانات تشغيلية، أم واجهات برمجية (APIs)، أم ملفات مسطحة، أم تيارات أحداث لحظية — إلى أنظمة التحليل والنمذجة.
المهام الجوهرية لمهندس البيانات تنتظم في خمسة محاور متصلة: الجمع والاستخراج، إذ يُحدد المصادر ويُنشئ قنوات الجذب منها؛ التنظيف والتوحيد، إذ يُزيل التكرارات والقيم الشاذة ويُحوّل الصيغ المتباينة إلى معيار موحد؛ التحويل والإثراء، إذ يُضيف السياق ويُجري الحسابات المطلوبة؛ التخزين المُهيكَل، إذ يختار البنية الأمثل لحفظ البيانات وفق احتياجات الاستخدام؛ ثم الإتاحة والتوثيق، إذ يضمن أن البيانات الناضجة في متناول المحللين وعلماء البيانات بصيغة موثوقة ومفهومة.
القيمة الاستثمارية لهذا التخصص تتجاوز البُعد التقني. المؤسسات التي تمتلك بنية تحتية ناضجة للبيانات تتمكن من تقليص وقت وصول المحللين إلى البيانات النظيفة من أسابيع إلى ساعات، مما يُترجَم مباشرة إلى قرارات أسرع وتكاليف تشغيلية أدنى. بالإضافة إلى ذلك، تُشير أبحاث McKinsey إلى أن المؤسسات القادرة على الاستفادة الفعلية من بياناتها تُحقق أرباحاً تتجاوز منافسيها بنسبة تصل إلى 23%.
السر الهندسي وراء الفجوة: تُفيد دراسة صادرة عن مؤسسة Forrester Research أن ما بين 70% و80% من وقت علماء البيانات يُصرَف في تنظيف البيانات وإعدادها، لا في النمذجة الفعلية. هندسة البيانات الناضجة هي ما يُعيد هذا التوازن.
اقرأ أيضاً:
البنية المعمارية لأنابيب البيانات: كيف تتدفق السجلات من المصدر إلى المخرج؟
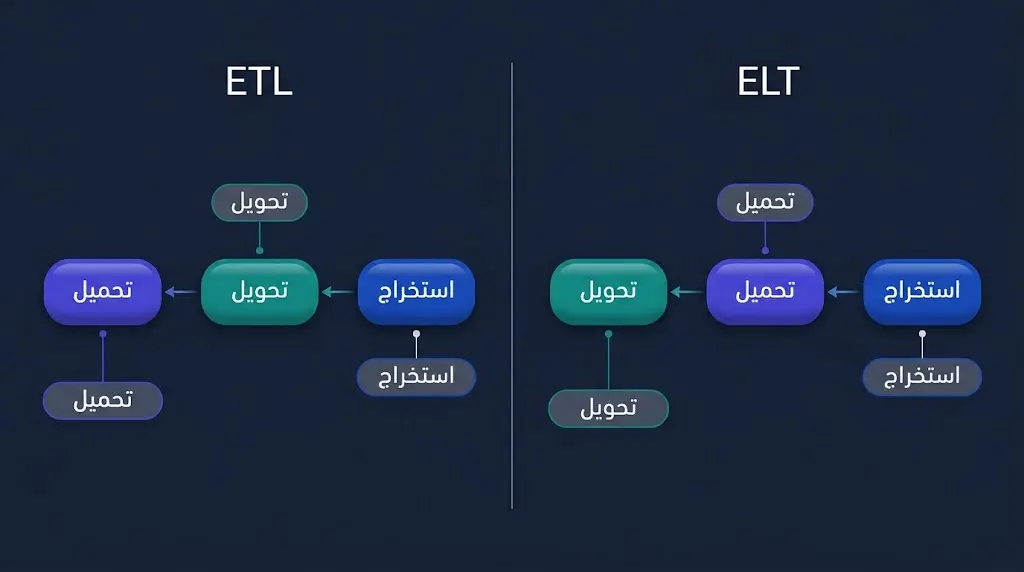
أنبوب البيانات (Data Pipeline) هو السلسلة المتكاملة من العمليات التي تنقل البيانات من نقطة الأصل إلى نقطة الاستخدام. تصميم هذا الأنبوب هو القلب النابض لهندسة البيانات، وفيه تتجلى الفروق الجوهرية بين نمطين معماريين رئيسين لا يزالان محور نقاش تقني مستمر.
ETL: النموذج الكلاسيكي للتحويل قبل التخزين
عملية الاستخراج والتحويل والتحميلي (ETL: Extract, Transform, Load) تمثل النموذج التقليدي الراسخ منذ عقود. تبدأ بـاستخراج البيانات من المصادر المتعددة، ثم تنتقل إلى منطقة مؤقتة تُسمى منطقة التدريج (Staging Area) حيث تجري عمليات التحويل — التنظيف، إعادة الهيكلة، تطبيق قواعد العمل — قبل أن تُحمَّل البيانات المُعالَجة إلى وجهتها النهائية، عادةً مستودع البيانات (Data Warehouse).
يتميز هذا النموذج بضمان أن لا يصل إلى وجهة التخزين إلا ما مر بمعالجة كاملة، غير أنه يُعاني من محدودية الحجم والسرعة؛ إذ إن التحويل يستهلك موارد حسابية ضخمة قبل اكتمال التحميل.
ELT: منطق الأنظمة السحابية الحديثة
على النقيض من ذلك، تعمل عملية الاستخراج والتحميل والتحويلي (ELT: Extract, Load, Transform) بمنطق مغاير تماماً. تُستخرج البيانات ثم تُحمَّل مباشرة إلى الوجهة — غالباً مستودعاً سحابياً — وتجري عمليات التحويل لاحقاً داخل محرك المستودع نفسه. هذا النهج أتاحه ظهور منصات ذات قدرة معالجة هائلة كـ Snowflake وGoogle BigQuery، اللتين تستطيعان تحويل بيانات ضخمة بسرعة مذهلة دون الحاجة لمنطقة وسيطة.
الفارق الجوهري ليس تقنياً فحسب، بل إستراتيجي. ELT يُمكّن المحللين من الوصول إلى البيانات الخام في الوجهة والتحويل وفق احتياجاتهم المتغيرة، بدلاً من الانتظار حتى يُجري مهندس البيانات تعديلات على مسار التحويل المسبق.
معايير تصميم أنبوب بيانات مرن وقابل للتوسع (Scalable Pipeline) تستند إلى ثلاثة مبادئ لا تنازل عنها: الأتمتة الكاملة بحيث لا يتوقف الأنبوب على تدخل يدوي؛ المراقبة المستمرة لاكتشاف الأعطال فور حدوثها؛ والإعادة الآمنة (Idempotency)، أي أن إعادة تشغيل الأنبوب لا تُولّد بيانات مكررة.
| الأداة / المنصة | الفئة الوظيفية | نمط المعالجة | اللغة الأساسية | حالة الاستخدام المثلى | ملاحظة |
|---|---|---|---|---|---|
| Apache Spark | محرك معالجة موزعة | دفعة + تدفق | Scala / Python | معالجة بيانات ضخمة بسرعة عالية | أسرع من Hadoop بـ 100x |
| Apache Kafka | ناقل رسائل موزع | تدفق لحظي | Java / Scala | بث الأحداث اللحظية وتوزيعها | +1 تريليون رسالة / يوم |
| Apache Airflow | جدولة سير العمل | دفعة | Python | إدارة الأنابيب والتبعيات (DAGs) | الأوسع انتشاراً |
| Snowflake | مستودع بيانات سحابي | ELT | SQL | فصل التخزين عن الحوسبة | مرونة تكلفة فريدة |
| Google BigQuery | مستودع بيانات سحابي | ELT | SQL | استعلامات على بيتابايت بسرعة | دفع حسب الاستخدام |
| Amazon Redshift | مستودع بيانات سحابي | ELT | SQL | التكامل مع منظومة AWS | مُدار بالكامل |
| dbt | أداة تحويل البيانات | ELT | SQL | تحويل البيانات داخل المستودع | الأكثر بحثاً 2023-2024 |
| Fivetran / Airbyte | استخراج آلي (Connectors) | دفعة | Python / Java | ربط المصادر الشائعة تلقائياً | Airbyte مفتوح المصدر |
| Apache Flink | محرك معالجة تدفق | تدفق لحظي | Java / Scala | معالجة الأحداث بكمون شديد الانخفاض | نوافذ زمنية متقدمة |
| Prefect | جدولة سير العمل | دفعة | Python | بديل Airflow بمرونة أعلى | إعادة تشغيل تلقائي |
مفارقة معمارية لافتة: الفارق بين ETL وELT لا يكمن في أي العمليات أفضل بالمطلق، بل في مكان حدوث التحويل. الأنظمة السحابية الحديثة جعلت التحويل داخل المستودع أرخص وأسرع من إجرائه خارجه، فقلبت المعادلة رأساً على عقب.
اقرأ أيضاً:
- الحوسبة السحابية (Cloud Computing): المفهوم، النماذج، والتطبيقات
- نماذج الحوسبة السحابية: IaaS، PaaS، وSaaS
معمارية التخزين: من المستودع إلى البحيرة إلى اللاك هاوس
مستودعات البيانات: التخزين الهيكلي المُخصَّص للتحليل
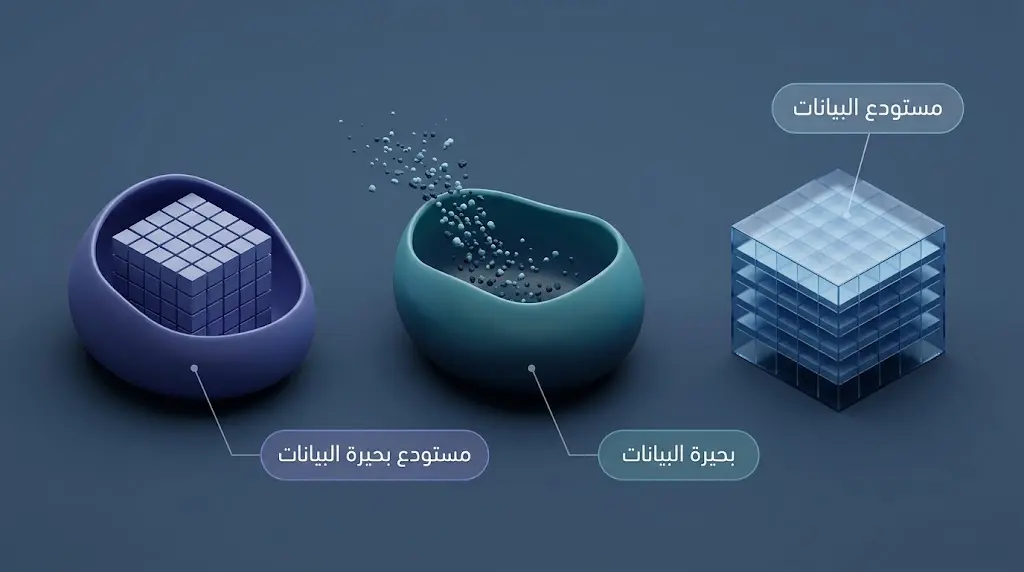
مستودع البيانات (Data Warehouse) بنية تخزينية مُصمَّمة خصيصى لدعم استعلامات التحليل والتقارير. يعتمد على مخططات بيانات مُعرَّفة مسبقاً (Predefined Schemas) تفرض ترتيباً صارماً على البيانات المُدخَلة. أنظمة كـ Amazon Redshift وGoogle BigQuery وSnowflake تنتمي إلى هذه الفئة. لقد بَرَعت هذه المستودعات في إنتاج تقارير ذكاء الأعمال (Business Intelligence) بسرعة قياسية، لكنها عجزت عن استيعاب بيانات غير مهيكلة كالصور والنصوص والمقاطع المرئية.
بحيرات البيانات: التخزين اللامحدود للخام غير المهيكَل
بحيرة البيانات (Data Lake) تُتيح تخزين البيانات بصيغتها الأصلية، مهيكلة كانت أم غير مهيكلة، دون فرض مخطط مسبق. المفهوم الذي روّج له James Dixon في عام 2010 جاء رداً على قيود المستودعات. منصات كـ Amazon S3 وAzure Data Lake وHadoop تجسّد هذا النموذج. الخطر الحقيقي لبحيرة البيانات هو تحوّلها إلى ما يُسمى بـ”مستنقع البيانات” (Data Swamp)؛ إذ تتراكم فيها بيانات لا يستطيع أحد فهمها أو البحث فيها بكفاءة دون حوكمة جيدة.
مستودع بحيرة البيانات: الدمج الحديث
Data Lakehouse نموذج معماري حديث أقرب ما يكون إلى التوفيق بين نقيضين؛ إذ يجمع مرونة بحيرة البيانات في استيعاب البيانات الخام مع قدرات إدارة المعاملات والجودة التي توفرها مستودعات البيانات. أداء دلتا ليك (Delta Lake) الذي طورته شركة Databricks مثّل نقطة تحول في هذا الاتجاه. يُتيح هذا النموذج تشغيل استعلامات SQL التحليلية مباشرة على بيانات خام مُخزَّنة في البحيرة، مع ضمان الاتساق والموثوقية.
من منظور التحليل العلمي المتقدم، يوضح المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية — أن:
التبسيط الشائع لمفهوم Data Lakehouse يميل إلى تصويره على أنه مجرد بحيرة بيانات مع طبقة إضافية من الاستعلام، إلا أن أحدث الأبحاث التطبيقية تكشف عن ديناميكية أعمق تتمثل في آليات إدارة المعاملات الذرية (ACID Transactions) التي تضمن عدم تلوث البيانات في حال فشل أي عملية كتابة جزئية. هذا المستوى من الدقة ضروري لفهم لماذا لا يمكن بناء أنظمة ذكاء اصطناعي موثوقة بدون هذه الضمانات المعمارية في طبقة التخزين.
| وجه المقارنة | مستودع البيانات (Data Warehouse) | بحيرة البيانات (Data Lake) |
|---|---|---|
| هيكل البيانات | مهيكل تماماً (Structured) | خام وغير مهيكل (Raw/Unstructured) |
| المخطط (Schema) | مُعرَّف مسبقاً (Schema-on-Write) | عند القراءة فقط (Schema-on-Read) |
| المستخدمون الرئيسيون | محللو البيانات وتقارير BI | علماء البيانات ونماذج AI/ML |
| سرعة الاستعلام | عالية جداً على البيانات المهيكلة | أبطأ — تحتاج معالجة إضافية |
| تكلفة التخزين | أعلى (تخزين محسوب) | أرخص بكثير (تخزين كائني) |
| أنواع البيانات | جداول، علائقية فقط | نص، صور، مقاطع، JSON، CSV |
| جودة البيانات | مضمونة (معالجة قبل الإدخال) | غير مضمونة (تتطلب حوكمة) |
| خطر الإهمال | منخفض — صعوبة الوصول غير المصرّح | مرتفع — يتحول لـ”مستنقع بيانات” |
| أمثلة المنصات | Snowflake، BigQuery، Redshift | Amazon S3، Azure Data Lake، Hadoop |
| الأنسب لـ | تقارير الأعمال الدورية والمنتظمة | التحليل الاستكشافي وتدريب النماذج |
اقرأ أيضاً:
- أجهزة تخزين الشبكة (Network Storage Devices): الأنواع، الوظائف، والحلول
- التخزين السحابي: ما هو وكيف يُغير طريقة حفظ بياناتنا؟
الدفعة أم التدفق اللحظي: متى تُعالَج البيانات؟
المعالجة بالدفعة (Batch Processing): الأنظمة ذات الصبر الإستراتيجي
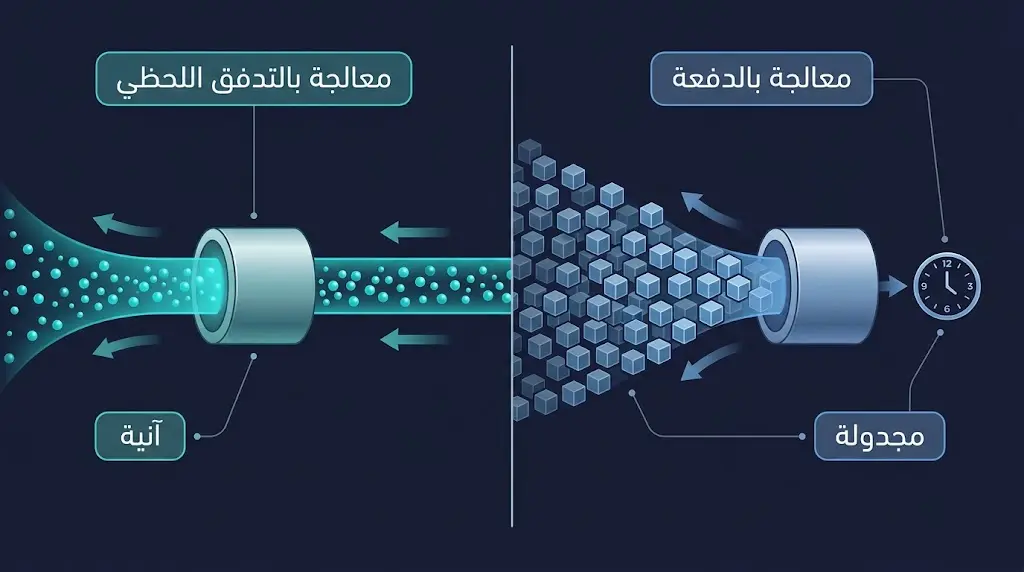
المعالجة بالدفعة تعني تجميع البيانات على مدى فترة زمنية ثم معالجتها دفعة واحدة في وقت مجدول. كل تقرير مالي يُنتَج نهاية الشهر، وكل ملخص إحصائي يُحسَب ليلاً، ينتمي إلى هذا النمط. أداة Apache Spark اشتُهرت جزئياً بكفاءتها في معالجة دفعات ضخمة بأسرع بكثير مما كانت عليه Hadoop MapReduce. يناسب هذا النمط الأحمال الكبيرة التي لا تستدعي استجابة فورية، لكنه يُصبح عبئاً حين تحتاج الأعمال إلى بيانات آنية.
المعالجة بالتدفق اللحظي (Real-Time Streaming): اتخاذ القرار في الزمن الفعلي
المعالجة بالتدفق (Stream Processing) تتعامل مع البيانات لحظة تولّدها. نظام الاحتيال المصرفي لا يستطيع الانتظار حتى نهاية اليوم ليكتشف معاملة مشبوهة. Apache Kafka منصة رائدة في هذا المجال؛ تعمل كـ”ناقل رسائل” موزّع (Distributed Message Broker) يستقبل تيارات الأحداث من مصادر متعددة ويوزّعها على المستهلكين المعنيين بوثوقية عالية ودون ضياع. من جهة ثانية، تبرز Apache Flink وSpark Streaming بوصفهما محركَين لمعالجة التدفقات مع إمكانية تطبيق نوافذ زمنية (Windowing) وعمليات تجميع (Aggregation) على الأحداث المتدفقة.
تقنيات تقليل الكمون (Latency Reduction) في هذه الأنظمة تتطلب تصميماً دقيقاً للتخزين المؤقت (Buffering)، واختيار بروتوكولات الشبكة الأسرع، وتوزيع الأحمال على عقد متعددة لتفادي نقاط الاختناق.
رقم يستحق التأمل: منصة Apache Kafka قادرة على معالجة ما يزيد على تريليون رسالة يومياً في بيئات الإنتاج الكبرى. LinkedIn — الشركة التي طوّرت Kafka أصلاً — كانت تعالج أكثر من 7 تريليونات رسالة يومياً عبر هذه المنصة في ذروة نشاطها.
لماذا تفشل النماذج الكلاسيكية في تصميم أنابيب البيانات عند التوسع؟
ثمة مسألة يُساء فهمها كثيراً في أوساط المبتدئين في هذا المجال؛ وهي الاعتقاد بأن أنبوب بيانات يعمل بكفاءة مع مئة ألف سجل يومياً سيستمر بنفس الكفاءة حين يُضاعَف الحجم مئة مرة. هذا الافتراض الخطأ أفضى إلى انهيار أنظمة كثيرة لمؤسسات توسعت فجأة دون إعادة تصميم بنيتها.
فما الذي يتغير فعلياً عند التوسع؟ يكمن الجواب في طبيعة المشكلات التي تظهر: التزامن (Concurrency) بين عمليات الكتابة والقراءة يُولّد تعارضات لم تظهر في البيئات الصغيرة. الأعطال الجزئية — كسقوط عقدة واحدة من عشرين — تُربك الأنابيب غير المُصمَّمة للتعافي الذاتي. التوزيع الغير متوازن للبيانات على الأقسام (Data Skew) يجعل بعض العقد تحت ضغط هائل بينما أخرى خاملة.
الحل المعماري المُعتمَد في بيئات الإنتاج الكبرى يعتمد على مبدأ عدم الحالة (Stateless Processing) كلما أمكن، بمعنى أن كل وحدة معالجة لا تعتمد على ذاكرة محلية بل تسترد ما تحتاجه من مصدر مشترك موثوق. وعليه فإن التصميم الجيد من البداية يوفر أضعاف تكلفة إعادة الهيكلة الكاملة لاحقاً.
هندسة البيانات في قلب المنظومة: كيف تُغذّي كل تخصص آخر؟
هندسة البيانات لا تعمل في جزيرة معزولة؛ بل تُمثل النسيج الذي تتنفس من خلاله كل التخصصات الرقمية الأخرى.
قواعد البيانات تستمد قدرتها على التوسع الأفقي (Horizontal Scaling) والنسخ الاحتياطي والتوزيع الجغرافي من البنى التحتية التي يُصمّمها مهندس البيانات؛ إذ إن القواعد وحدها لا تُحدد كيف تتدفق البيانات بين الأنظمة، بل إن الطبقة الهندسية فوقها هي من يتولى هذه المهمة.
محلل البيانات يقضي وقته في استخراج الأنماط وبناء التقارير، غير أنه يفعل ذلك على بيانات نظيفة وموحدة جهّزها مهندس البيانات. دون هذه الطبقة، يقضي المحلل أغلب وقته في التنظيف لا في التحليل.
تنقيب البيانات (Data Mining) يشترط بيانات خالية من الشوائب لكشف الأنماط الخفية؛ إذ إن الخوارزميات الإحصائية حساسة للغاية للبيانات الشاذة والمكررة، وهو ما تكفل هندسة البيانات القضاء عليه.
عالم البيانات (Data Scientist) يبني نماذج التعلم الآلي (Machine Learning) وخوارزميات الذكاء الاصطناعي، لكن كل نموذج يستهلك طاقة هائلة في التحقق من جودة البيانات المُدخَلة إليه. مهندس البيانات هو من يبني الأنابيب التي توصل البيانات الجاهزة للتدريب إلى عالم البيانات في الوقت المناسب وبالصيغة المطلوبة.
ومضة معمارية: نظام التوصيات في منصة نتفليكس (Netflix) يعتمد على أنابيب بيانات تُعالج ما يزيد على 500 مليار حدث يومياً قبل أن تصل أي بيانات إلى نماذج التوصية الفعلية. البنية التحتية لهذه الأنابيب أضخم وأعقد بكثير من النماذج الذكية نفسها.
اقرأ أيضاً:
- التعلم العميق (Deep Learning): كيف تحاكي الآلات شبكات الدماغ البشري؟
- تطبيقات الذكاء الاصطناعي في التعليم: الفرص والتحديات
ما الذي تحتاجه فعلاً لبناء أنبوب بيانات في عام 2024؟
سوق العمل في هندسة البيانات تكثّفت فيه مجموعة أدوات أصبحت شبه معيارية، يُحسن الفهمُ الجيدُ لها أي باحثٍ عن تعمق حقيقي في هذا المجال.
أدوات إدارة الأنابيب والجدولة:
- Apache Airflow: منصة رائدة لجدولة سير العمل وإدارة الأنابيب باستخدام Python لتعريف المهام والتبعيات بينها عبر رسوم بيانية موجّهة لاأحادية (DAGs).
- Prefect: بديل حديث يُتيح تعريف الأنابيب بأسلوب أكثر مرونة، مع إمكانيات متقدمة للمراقبة وإعادة التشغيل التلقائي عند الفشل.
محركات المعالجة الموزعة:
- Apache Spark: محرك تحليلي موزع قادر على معالجة بيانات ضخمة بسرعة تفوق Hadoop بما يصل إلى 100 مرة في بعض الأحمال، بحسب بيانات Apache Foundation.
- Apache Kafka: منصة البث الموزعة التي تُتيح نقل التيارات اللحظية بين الأنظمة بكمون منخفض وموثوقية عالية.
مستودعات البيانات السحابية:
- Snowflake: يُتيح فصل موارد التخزين عن موارد الحوسبة، مما يوفر مرونة فريدة في التكلفة.
- Google BigQuery: يعتمد نموذج الدفع حسب الاستخدام، ويتميز بسرعة الاستعلام على بيانات بيتابايت.
- Amazon Redshift: مستودع بيانات سحابي مُدار من AWS يتكامل بسلاسة مع باقي خدمات المنظومة الأميركية.
لغات البرمجة والتحكم:
- Python: اللغة الأكثر انتشاراً في كتابة مهام الأنابيب والتحويل، بفضل مكتباتها الثرية كـ pandas وPySpark.
- SQL: اللغة الأساسة لاستعلام وتحويل البيانات داخل المستودعات. لا يُشغل سوق العمل مهندس بيانات لا يُتقن SQL.
- Scala: يُفضَّل في بيئات Spark عالية الأداء لكونه اللغة الأصلية التي كُتب بها Spark.
| المهارة / التقنية | الفئة | مستوى الأولوية | المرحلة المقترحة | الأدوات المرتبطة | الوقت التقديري للإتقان |
|---|---|---|---|---|---|
| SQL المتقدمة | لغة استعلام | أساسي إلزامي | الشهر 1-2 | PostgreSQL، BigQuery، Snowflake | 4-8 أسابيع |
| Python للبيانات | لغة برمجة | أساسي إلزامي | الشهر 1-3 | pandas، PySpark، requests | 6-10 أسابيع |
| مبادئ قواعد البيانات | مفاهيم معمارية | أساسي إلزامي | الشهر 1-2 | MySQL، MongoDB، Redis | 3-5 أسابيع |
| Apache Airflow | جدولة الأنابيب | متوسط مهم | الشهر 3-5 | DAGs، Python، Docker | 4-6 أسابيع |
| dbt (data build tool) | تحويل البيانات | متوسط مهم | الشهر 4-6 | SQL، Snowflake، BigQuery | 3-5 أسابيع |
| Apache Spark | معالجة موزعة | متوسط مهم | الشهر 5-7 | PySpark، Scala، Databricks | 6-10 أسابيع |
| الخدمات السحابية | بنية تحتية | متوسط مهم | الشهر 4-6 | AWS، GCP، Azure | 5-8 أسابيع |
| Apache Kafka | بث الأحداث | متقدم | الشهر 7-9 | Kafka Streams، Flink | 5-8 أسابيع |
| حوكمة البيانات | إدارة وجودة | متقدم | الشهر 8-10 | Great Expectations، Apache Atlas | 4-6 أسابيع |
| Data Mesh / LLMOps | معمارية مستقبلية | متقدم | الشهر 10+ | Databricks، dbt، LLMs | مستمر |
اقرأ أيضاً:
المختبر الهندسي: داخل آلية بناء أنبوب ELT على السحابة
الأنبوب السحابي الحديث وفق نمط ELT يمر بمراحل هندسية دقيقة تكشف عن عمق هذا التخصص.
الاستخراج (Extraction): يبدأ بمحرك استخراج يُنشئ اتصالات بمصادر متعددة — قاعدة بيانات PostgreSQL هنا، و API خارجية هناك، وملف CSV يُرفع يومياً في مكان آخر. أدوات كـ Fivetran وAirbyte تُؤتمت هذا الاستخراج وتُعالج مشكلات المصادقة وتغيّر الهياكل (Schema Evolution) تلقائياً.
التحميل (Loading): تُكتب البيانات الخام إلى طبقة التخزين الأولية في المستودع دون تحويل، محافظةً على شكلها الأصلي. هذا يُتيح إمكانية العودة إلى الخام في أي وقت.
التحويل (Transformation): تبدأ هنا أداة dbt (data build tool) في لعب دورها المحوري. تُعرَّف نماذج SQL تُحوّل الخام إلى جداول جاهزة للتحليل، مع توثيق تلقائي وتتبع الاعتماديات بين الجداول. الجدير بالذكر أن dbt أصبحت في 2023-2024 من أكثر الأدوات بحثاً في مجتمعات هندسة البيانات.
خدمة البيانات: تُتاح الجداول النهائية لأدوات التحليل والمنظومات الأخرى عبر طبقة معالم بيانات (Semantic Layer) تُعرّف المقاييس والأبعاد بصيغة موحدة يفهمها كل المستخدمين.
حوكمة البيانات وجودتها: الجانب الذي يُحدد الفارق بين بنية موثوقة وأخرى هشة
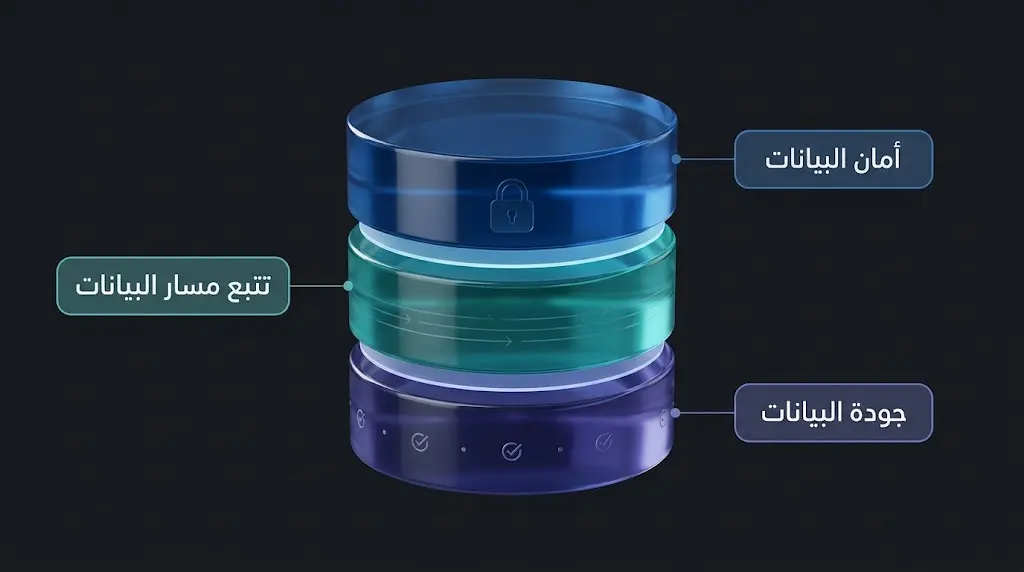
قياس الجودة والكشف التلقائي عن الأعطال
جودة البيانات (Data Quality) تُقاس عبر أبعاد متعددة تشمل: الدقة (Accuracy)، الاكتمال (Completeness)، الاتساق (Consistency)، الحداثة (Timeliness)، والفرادة (Uniqueness). أدوات كـ Great Expectations وSoda Core تُتيح تعريف “توقعات” رياضية على البيانات — كأن لا تتجاوز قيمة عمود حدًّا معيناً، أو أن لا تكون نسبة القيم المفقودة أعلى من 2% — واكتشاف الانتهاكات تلقائياً عند كل تشغيل للأنبوب.
تتبع مسار البيانات: أين وُلد هذا الرقم؟
تتبع مسار البيانات (Data Lineage) يُجيب عن السؤال المحوري: من أين جاء هذا الرقم في التقرير النهائي، ومن المصدر إلى المخرج كيف تحوّل؟ أنظمة كـ Apache Atlas وMarquez توفر رسماً بيانياً تفصيلياً لرحلة كل حقل بيانات، مما يُسهّل تشخيص المشكلات وضمان الامتثال التنظيمي. في البيئات المالية والصحية، هذا المتطلب ليس ترفاً بل إلزامٌ قانوني.
الأمان الهندسي: تشفير لا تسوية فيه
البنية الأمنية لمنظومة البيانات تُبنى على طبقات متداخلة. التشفير في حالة السكون (Encryption at Rest) يضمن أن البيانات المُخزَّنة غير قابلة للقراءة دون مفاتيح التشفير المناسبة. التشفير أثناء النقل (Encryption in Transit) يحمي البيانات المتحركة بين الأنظمة. التحكم الدقيق في الوصول (Role-Based Access Control) يضمن أن كل مستخدم لا يرى إلا ما يحتاجه بالضبط. وعليه فإن الامتثال لأنظمة كـ GDPR الأوروبي وحماية البيانات الشخصية لا يتحقق إلا بدمج هذه الطبقات الثلاث في صميم التصميم، لا إضافتها كطلاء خارجي لاحقاً.
اقرأ أيضاً:
- الأمن السيبراني: المبادئ الأساسية وأهميته في العصر الرقمي
- أمن المعلومات: الدليل العلمي الشامل لحماية البيانات ومواجهة التهديدات السيبرانية
- كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
خرافات شائعة وحقائق علمية حول هندسة البيانات
❌ الخرافة: مهندس البيانات وعالم البيانات يؤدّيان العمل ذاته.
✅ الحقيقة: الفصل بين التخصصين جوهري. مهندس البيانات يبني الطرق والجسور؛ عالم البيانات يسير عليها. الأول يُنشئ الأنابيب والبنية التحتية، والثاني يستهلك ما أنتجه الأول لبناء النماذج التنبؤية.
❌ الخرافة: بحيرة البيانات أفضل دائماً من مستودع البيانات لأنها تخزن كل شيء.
✅ الحقيقة: بحيرة البيانات غير المُدارة تتحول بسرعة إلى “مستنقع بيانات” لا يمكن الاستفادة منه. الاختيار بين النموذجين يعتمد على طبيعة البيانات وحالات الاستخدام، ولا توجد إجابة مطلقة.
❌ الخرافة: SQL قديمة ولا مكان لها في هندسة البيانات الحديثة.
✅ الحقيقة: SQL تُعَدُّ اليوم الركيزة الأساسة لأدوات التحويل الحديثة كـ dbt، وتدعم كل مستودعات البيانات السحابية الكبرى استعلاماتها الجوهرية.
❌ الخرافة: المعالجة اللحظية (Real-Time Streaming) أفضل دائماً من المعالجة بالدفعة.
✅ الحقيقة: المعالجة اللحظية أعلى تكلفة وأعقد هندسياً بكثير. غالبية حالات الاستخدام في الأعمال لا تحتاج فعلاً إلى بيانات بكمون أقل من ثانية، والمعالجة بالدفعة تُقدم قيمة كافية بتكلفة أدنى.
❌ الخرافة: أتمتة هندسة البيانات ستُلغي الحاجة إلى مهندس البيانات.
✅ الحقيقة: الأتمتة تُغني مهندس البيانات من المهام المتكررة لتركيز جهوده على التصميم المعماري وحل المشكلات المعقدة. الطلب على مهندسي البيانات في ارتفاع مستمر وفق تقارير LinkedIn لعام 2024.
وفقاً لتقرير معهد ماساتشوستس للتكنولوجيا (MIT) الصادر في 2023، فإن الشركات التي تستثمر في بنية تحتية ناضجة للبيانات تُحقق عوائد تتجاوز استثماراتها في تقنيات الذكاء الاصطناعي نفسها، لأن جودة البيانات المُغذِّية للنماذج تُحدد سقف دقتها قبل أي عامل آخر.
— MIT Sloan Management Review on Data Infrastructure
مدخل الطالب والهاوي إلى هندسة البيانات: من أين تبدأ؟
المفاهيم الأساسية قبل التعمق
قبل التوسع في مبادئ هندسة البيانات المتقدمة، ثمة أسس لا غنى عنها يجب إتقانها:
- SQL على نحو عميق: ليس مجرد SELECT وWHERE؛ بل النوافذ (Window Functions)، التجميع (GROUP BY)، والدمج (JOINs) المعقدة.
- لغة Python: كتابة سكريبتات تعالج الملفات، تتصل بالواجهات البرمجية، وتُشغّل وظائف التنظيف.
- مبادئ قواعد البيانات: الفرق بين العلائقية (Relational) وقواعد NoSQL، ومتى يُستخدم كل نوع.
- مفاهيم الشبكات والسحابة: كيف تتصل الأنظمة ببعضها، وما دور الخدمات السحابية كـ AWS وGCP وAzure.
الأخطاء الشائعة التي يقع فيها المبتدئون
من خلال التحليل الميداني لمسارات المتعلمين في هذا التخصص، يتكرر خطأ جوهري واحد: الانشغال بتعلم أدوات جديدة قبل إتقان المبادئ الأساسة. مهندس البيانات الذي يتقن تصميم الأنابيب بـ Python الخالصة وSQL المتقدمة سيتقن Apache Airflow في أيام. بينما من يبدأ بالأدوات دون المبادئ يجد نفسه أمام جدار صلب لا يُفسر له لماذا تسير أشياء كثيرة بخلاف ما يتوقع.
خطأ آخر شائع هو تجاهل الجانب المعماري؛ إذ يُركز كثيرون على كتابة كود الأنابيب دون التفكير في كيفية توسعه لاحقاً، وما الذي سيحدث حين يُضاعَف الحجم.
اقرأ أيضاً:
- الإحصاء: الأدوات، المنهجيات، ودوره في صنع القرار
- التعلم الآلي والإحصاء: كيف يتكاملان لفهم البيانات وصنع القرار؟
أين تتقاطع هندسة البيانات مع بقية فروع العلم والتقنية؟
هندسة البيانات لا تنمو في فراغ؛ فروابطها التقنية والعلمية متشعبة وعميقة.
علوم الشبكات (Network Science): أنظمة البث الموزع كـ Kafka تعتمد على نظرية الرسوم البيانية (Graph Theory) لإدارة التبعيات بين الموضوعات (Topics) والأقسام (Partitions). فهم نظرية توزيع الأحمال والاتساق النهائي (Eventual Consistency) في الأنظمة الموزعة مشتق مباشرة من علوم الشبكات الموزعة.
علم الإحصاء والرياضيات (Statistics & Mathematics): اكتشاف الشواذ (Anomaly Detection) في أنابيب البيانات يستند إلى توزيعات إحصائية كالتوزيع الطبيعي (Normal Distribution) وأساليب كشف القيم المتطرفة (Outlier Detection). لقد أصبح الفهم الإحصائي شرطاً ضمنياً لمهندس البيانات المحترف.
علوم الأمن السيبراني (Cybersecurity): التشفير، التحكم بالوصول، وتتبع المسار (Audit Trails) كلها مجالات يتقاطع فيها الأمن السيبراني مع هندسة البيانات، خاصة في البيئات التي تتعامل مع بيانات حساسة كالبيانات المالية والصحية.
اقتصاديات البيانات (Data Economics): التكلفة التشغيلية لتخزين البيانات ومعالجتها في السحابة تستدعي فهماً اقتصادياً للمقايضات بين التخزين الساخن (Hot Storage) والبارد (Cold Storage)، وبين الكمون والتكلفة.
التوصية العلمية من موقعنا
بناءً على التحليل المعماري لمنظومات البيانات الحديثة، يُوصي فريق خلية العلمي بما يلي لمن يسعى إلى الفهم الحقيقي لهذا التخصص:
- ابدأ بفهم مبدأ الاتساق مقابل التوفر (Consistency vs. Availability): هذا المبدأ الذي تُرسيه نظرية CAP (Brewer’s theorem) يُفسر معظم قرارات التصميم في الأنظمة الموزعة. فهمه عمقاً يضع كل أداة وكل قرار معماري في سياقه الصحيح.
- لا تُفصل بين التصميم المعماري والقيود الاقتصادية: التصميم الأمثل تقنياً ليس بالضرورة الأمثل اقتصادياً. منظومة بيانات ناجحة تُوازن بين الأداء والتكلفة وقابلية الصيانة.
- تعمق في مفهوم الاتساق النهائي (Eventual Consistency): الأنظمة الموزعة لا تضمن دائماً أن كل العقد ترى البيانات ذاتها في اللحظة ذاتها. فهم متى يكون هذا مقبولاً ومتى يكون مشكلة يُعَدُّ مهارة تمييزية نادرة.
- راقب اتجاه Data Mesh الصاعد بجدية: هذا التحول نحو المعمارية اللامركزية يُعيد تعريف دور مهندس البيانات من بانٍ مركزي إلى موفر منصة. الأبحاث المنشورة بين 2022 و2024 تُشير إلى اعتماده المتسارع في المؤسسات الكبرى.
- اختر مشروعاً تطبيقياً من بيئتك المحلية: بناء أنبوب بيانات لتحليل بيانات الطقس في المملكة العربية السعودية، أو استيراد بيانات البورصات العربية وتنظيمها، يُرسّخ المفاهيم النظرية بشكل لا تستطيع أي دورة دراسية توفيره.
- اقرأ وثائق الأدوات الأصلية (Official Documentation) لا الملخصات فقط: وثائق Apache Kafka وApache Airflow وdbt تحتوي على قرارات تصميمية مُفسَّرة بعمق لا توجد في أي شرح خارجي.
- لا تُهمل حوكمة البيانات: المؤسسات الكبرى تُنفق على حوكمة البيانات أكثر مما تُنفق على الأدوات نفسها. فهم Data Catalog وData Dictionary وData Governance Frameworks ليس ترفاً تعليمياً.
الخطة العملية لبناء أنبوب بيانات من الصفر
مسار بناء أنبوب ELT سحابي خطوة بخطوة
- تحديد حالة الاستخدام (Use Case): قبل كتابة سطر كود، تُحدَّد الأسئلة التجارية التي يجب أن يُجيب عنها الأنبوب، لأن هذا يُحدد البيانات المطلوبة وتكرار التشغيل.
- رسم مخطط البيانات (Data Flow Diagram): تُرسم خريطة مرئية تُوضح المصادر، المراحل، والوجهات قبل البدء في التنفيذ.
- اختيار منصة الاستخراج: اعتماد Fivetran أو Airbyte للمصادر الشائعة، أو كتابة مُستخرِج مخصص بـ Python للمصادر الخاصة.
- تهيئة مستودع البيانات السحابي: إنشاء مخططات منفصلة (Schemas) للبيانات الخام (Raw)، والمرحلية (Staging)، والجاهزة للإنتاج (Production).
- كتابة نماذج التحويل بـ dbt: يُعرَّف كل تحويل بملف SQL واحد، مع توثيق كل عمود وتعريف اختبارات الجودة على البيانات.
- جدولة الأنبوب وتفعيل المراقبة: تُضبط Airflow أو Prefect لتشغيل الأنبوب وفق جدول زمني، مع تفعيل التنبيهات الفورية عند أي فشل.
- توثيق كل شيء في Data Catalog: توثيق المصادر والتحويلات والمقاييس في فهرس بيانات مركزي يُتيح لكل فريق فهم ما تعنيه كل جداول البيانات.
اقرأ أيضاً:
- الحوسبة بدون خادم (Serverless): النموذج الجديد لتطوير التطبيقات
- الدليل الشامل إلى النماذج مفتوحة المصدر (Open Source Models): كيف تقود ثورة الذكاء الاصطناعي؟
المستقبل المعماري لهندسة البيانات
Data Mesh: اللامركزية كفلسفة هندسية
الفكرة التي أطلقتها Zhamak Dehghani عام 2019 بدأت تتحول إلى واقع تنظيمي في المؤسسات الكبرى. Data Mesh تُوزّع مسؤولية البيانات على الفِرَق التي تُنتجها — كل قسم تجاري يمتلك بياناته ويُديرها ويُتيحها كـ”منتج بيانات” للآخرين، بدلاً من مركزية تجمع كل شيء في فريق هندسي واحد. هذا التحول يُعيد تعريف دور مهندس البيانات من “بانٍ مركزي” إلى “موفر منصة” يُمكّن الفِرَق الأخرى من إدارة بياناتها باستقلالية.
الذكاء الاصطناعي لإدارة البنية التحتية
ظهر ما يُعرف بـ AIOps في سياق إدارة البنية التحتية؛ وهو استخدام نماذج ذكاء اصطناعي لمراقبة أنابيب البيانات، واكتشاف الشواذ، والتنبؤ بالأعطال قبل وقوعها. أدوات كـ Monte Carlo Data تُطبق هذا النهج فعلياً على أنابيب الإنتاج. كما أن استخدام نماذج اللغة الكبرى (LLMs) لكتابة استعلامات SQL وتوليد نماذج dbt تلقائياً بدأ يُقلص وقت التطوير بشكل لافت في تجارب 2024.
بينما يتوسع نطاق هذا التخصص ليشمل الأتمتة الذاتية وإدارة البيانات الفيدرالية عبر حدود المؤسسات، يبقى السؤال الجوهري الذي يشغل مجتمعات البحث مفتوحاً: هل تستطيع الأنظمة الذاتية التنظيم (Self-Managing Systems) أن تُعوّض الحكم المعماري الذي يُتقنه مهندس بيانات بشري متمرس؟ ما الضمان الذي يجعل قرار ذكاء اصطناعي يتعلق ببنية تحتية حيوية موثوقاً كقرار إنساني يتحمل مسؤوليته؟
نقطة تستحق التأمل: رغم كل التقدم في الأتمتة، يُظهر مؤشر وظائف LinkedIn لعام 2024 أن الطلب على مهندسي البيانات نما بنسبة 43% بين عامَي 2022 و2024 على مستوى العالم، مما يُشير إلى أن الأتمتة تُعيد تشكيل الدور لا تُلغيه.
اقرأ أيضاً:
- شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
- الثورة الصناعية الرابعة: الدليل العلمي الشامل للتقنيات التي تعيد صياغة مستقبل البشرية
يستند هذا المقال إلى أحدث المعايير والوثائق الرسمية المعتمدة في مجال هندسة البيانات وتقنية المعلومات:
- Apache Software Foundation (2024) — الوثائق الرسمية لـ Apache Spark وApache Kafka وApache Airflow وApache Flink
- DAMA International — DMBOK 2.0 — معيار إدارة البيانات المؤسسية وحوكمتها المعتمد دولياً
- NIST SP 800-53 Rev. 5 — إطار ضوابط الأمن والخصوصية للأنظمة المعلوماتية الحكومية والمؤسسية
- IEEE Standard 2413-2019 — إطار معمارية إنترنت الأشياء (IoT) المرتبط بأنظمة تدفق البيانات اللحظية
- Regulation (EU) 2016/679 — GDPR — لائحة الاتحاد الأوروبي لحماية البيانات الشخصية وأثرها على تصميم أنابيب البيانات
- ISO/IEC 25012:2008 — معيار جودة البيانات (Data Quality Model) المعتمد دولياً
- Cloud Security Alliance (CSA) — CCM v4 — إطار ضوابط أمن الحوسبة السحابية
- Databricks — Delta Lake Open Standard — معيار مفتوح المصدر لمعمارية Lakehouse ومعاملات ACID على مستوى البحيرة
المصادر والمراجع
الدراسات والأوراق البحثية:
- Zaharia, M., et al. (2016). Apache Spark: A Unified Engine for Big Data Processing. Communications of the ACM. https://doi.org/10.1145/2934664
— ورقة بحثية تشرح البنية المعمارية لـ Spark وكيف حقق تفوقه على أنظمة MapReduce. - Kreps, J., et al. (2011). Kafka: A Distributed Messaging System for Log Processing. LinkedIn Engineering. [يُرجى إدراج الرابط يدوياً]— الورقة الأصلية التي أسّست لمنصة Kafka وشرحت مبررات تصميمها.
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.
— مرجع شامل يُعَدُّ من أكثر الكتب تأثيراً في تصميم أنظمة البيانات الحديثة.
الجهات الرسمية والمنظمات:
- Gartner (2023). Data and Analytics Trends. https://www.gartner.com/en/data-analytics
— تقرير يرصد أحدث التوجهات في سوق البيانات والتحليلات على مستوى المؤسسات. - Apache Software Foundation (2024). Apache Spark Official Documentation. https://spark.apache.org/docs/latest/
— الوثائق الرسمية الشاملة لمحرك المعالجة الموزعة الأوسع انتشاراً. - Apache Software Foundation (2024). Apache Kafka Official Documentation. https://kafka.apache.org/documentation/
— المصدر الرسمي لفهم بنية Kafka ونماذج التوزيع فيها.
المقالات العلمية المبسطة:
- Dehghani, Z. (2019). How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh. Martin Fowler’s Blog. https://martinfowler.com/articles/data-monolith-to-mesh.html
— المقال التأسيسي الذي أطلق مفهوم Data Mesh وأعاد تعريف المعمارية اللامركزية للبيانات. - Armbrust, M., et al. (2021). Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics. CIDR Conference. [يُرجى إدراج الرابط يدوياً]— ورقة بحثية تشرح مفهوم Lakehouse وتُبرر مبررات ظهوره كنموذج معماري مستقل.
- Reis, J., & Housley, M. (2022). Fundamentals of Data Engineering. O’Reilly Media.
— مرجع شامل يُغطي دورة حياة هندسة البيانات من الاستخراج إلى الإتاحة بعمق نادر. - McKinsey Global Institute (2023). The Data-Driven Enterprise of 2025. https://www.mckinsey.com/capabilities/quantumblack/our-insights
— تقرير يُحلل الأثر الاقتصادي للبنية التحتية الناضجة للبيانات على أداء المؤسسات.
قراءات إضافية ومصادر للتوسع
للطلاب والباحثين الراغبين في التعمق:
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.
لماذا نقترح عليك قراءته؟ يُعَدُّ هذا الكتاب المرجعَ الأعمق في تصميم أنظمة البيانات الموزعة؛ يشرح نظرية CAP، والاتساق النهائي، وبروتوكولات الإجماع بأسلوب نادراً ما يُضاهَى في الوضوح، وهو مُدرَج في قوائم القراءة لدى فِرَق هندسة البيانات في كبرى شركات التكنولوجيا العالمية. - Dama International (2017). DAMA-DMBOK: Data Management Body of Knowledge (2nd ed.). Technics Publications.
لماذا نقترح عليك قراءته؟ هذا الكتاب يُمثل المرجع الأشمل لحوكمة البيانات وإدارتها المؤسسية، ويُغطي كل شيء من حوكمة البيانات إلى معمارية البيانات إلى جودتها بمنهجية أكاديمية موثوقة معتمدة دولياً. - Inmon, W.H. (2005). Building the Data Warehouse (4th ed.). Wiley.
لماذا نقترح عليك قراءته؟ وليم إينمون هو من وضع الأسس النظرية لمستودعات البيانات، وقراءة هذا الكتاب تُعطي المهندس فهماً تاريخياً عميقاً يُفسر لماذا تُصمَّم المستودعات الحديثة بالطريقة التي تُصمَّم بها، مما يُميّز المهندس المبدع من الناسخ الآلي.
إن رحلة هندسة البيانات لا تنتهي عند حدود الأدوات الراهنة أو النماذج المعمارية القائمة؛ فكل موجة تقنية جديدة — من الذكاء الاصطناعي التوليدي إلى الحوسبة الكمية — ستُعيد طرح أسئلة جوهرية حول كيفية تنظيم البيانات ونقلها وحوكمتها. المؤسسات التي تستثمر اليوم في بناء بنية تحتية معمارية رصينة لبياناتها لا تُحضّر لمتطلبات غد قريب فحسب، بل تُبني امتيازاً تنافسياً يتضاعف مع كل تقنية جديدة تستوعبها هذه البنية دون أن تُعيد بناءها من الصفر. فهل تستطيع هندسة البيانات اللامركزية المستندة إلى Data Mesh أن تُحل عقدة التوازن بين الاستقلالية التنظيمية وضمانات الجودة الموحدة في منظومات الذكاء الاصطناعي الجيل القادم؟
موقع خلية لا يتحمل أي مسؤولية قانونية أو تقنية ناتجة عن تطبيق المعلومات الواردة في هذا المحتوى في بيئات إنتاجية دون الرجوع إلى المختصين المؤهلين.
د. م. أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات