قواعد البيانات: البنية التحتية لحفظ المعلومات وإدارة الأنظمة الرقمية
ما الذي يجعل قواعد البيانات العمود الفقري لكل نظام رقمي؟

قواعد البيانات (Databases) هي مجموعات منظمة من البيانات المخزنة إلكترونياً وفق هياكل محددة، تتيح استرجاعها وتعديلها وإدارتها بكفاءة عالية. يتراوح حجم قاعدة البيانات الواحدة في المؤسسات الكبرى من بضعة غيغابايتات إلى عشرات البيتابايتات، مع أوقات استجابة تُقاس بالميلي ثانية.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات
- قواعد البيانات ليست ملفات تخزين — بل أنظمة هندسية متكاملة تُدار عبر DBMS يُترجم الأوامر ويفرض الأمان.
- الفارق الحاسم بين SQL وNoSQL ليس في الأداء بل في طبيعة البيانات: ثابتة البنية ← SQL، متغيرة البنية ← NoSQL.
- خصائص ACID (ذرية، اتساق، عزل، متانة) هي الضمان الذي يجعل التحويل المصرفي لا يتبخر أبداً.
- شجرة B+ تُقلّص البحث في مليار سجل من O(n) إلى O(log n) — أي من دقائق إلى ميلي ثوانٍ.
- كل تحويل عبر SARIE أو أهلي موبايل يمر بمعاملة ACID كاملة تضمن أن المبلغ لن يختفي بين المُرسِل والمُستقبِل.
- اقتراحات Spotify تُشغّلها قاعدة بيانات متجهية تحسب المسافة الرياضية بين ذوقك وملايين الأغاني في ميلي ثانية.
- منصة noon تجمع PostgreSQL للطلبات وMongoDB لكتالوج المنتجات في نظام واحد — هذا ما يُسمى Polyglot Persistence.
- الفهرسة المفرطة تُبطّئ عمليات الكتابة — ابدأ بفهرسة المفاتيح الرئيسة والأجنبية فقط ثم أضف ما تحتاجه.
- تشفير التخزين (Encryption at Rest) يُهمله 60%+ من المؤسسات — بيانات القرص المسروب تُقرأ بالكامل بدونه.
- نسخة احتياطية يومية غير كافية للأنظمة الحرجة — فقدان 24 ساعة من بيانات المرضى أو المعاملات المالية كارثة.
- قواعد البيانات المتجهية والسحابية لا تزال تتطور بسرعة — تحقق من التوثيق الرسمي قبل الاعتماد عليها إنتاجياً.
كل ضغطة على شاشة هاتفك تُطلق سلسلة خفية من الاستعلامات. حين تسجّل دخولك إلى تطبيق مصرفي سعودي كـ”أهلي موبايل” أو “stc pay”، فإن النظام يتحقق من هويتك، ويعرض رصيدك، ويسجّل عملية التسجيل، كل ذلك في أجزاء من الثانية. الشيء المحيّر هنا أن هذه السرعة ليست صدفة، بل نتاج عقود من التطوير الهندسي في بنية التخزين وإدارة السجلات.
حين كانت البيانات فوضى منظمة
قبل أن يرسّخ إدغار كود (Edgar F. Codd) نموذجه العلاائقي عام 1970، كانت البيانات تُخزَّن في ملفات نصية مسطّحة (Flat Files) تشبه سجلات الورق في دواوين الحكومة. لا ترابط بين السجلات، ولا آلية فعّالة للبحث. كانت استرجاع معلومة واحدة يعني قراءة الملف بأكمله من البداية، أو ما يُسمى بالبحث الخطي (Linear Search). الأنظمة الأولى من نوع هذه الملفات كانت تُعاني من تكرار البيانات (Data Redundancy) على نحو مزمن، فتجد اسم العميل نفسه في سبعة ملفات مختلفة بسبعة أشكال مختلفة من الإملاء.
لقد غيّر كود هذه المعادلة تغييراً جذرياً حين اقترح تنظيم البيانات في جداول ذات علاقات رياضية محكمة. من تلك اللحظة، بدأت قواعد البيانات تتطور بوصفها بنية تحتية رقمية متكاملة، لا مجرد ملفات تخزين.
اقرأ أيضاً:
- الكمبيوتر: كيف غيّر هذا الاختراع العظيم مسار الحضارة البشرية؟
- الإنترنت: كيف وُلد كاختراع غيّر العالم؟
أنظمة إدارة قواعد البيانات (DBMS): الطبقة التي لا يراها أحد
مفهوم نظام إدارة قواعد البيانات (Database Management System — DBMS) يُمثّل الفارق الحاسم بين مجرد تخزين البيانات وبين إدارتها على نحو احترافي. قاعدة البيانات بذاتها ليست سوى مجموعة ملفات مخزّنة على القرص الصلب؛ أما نظام إدارتها فهو البرنامج الذي يقف بين المستخدم وتلك الملفات، ويُترجم الأوامر، ويفرض قواعد الأمان، ويضمن أن كل عملية تمر بالبوابة الصحيحة.
يؤدي نظام إدارة قواعد البيانات أربع وظائف جوهرية يُعبَّر عنها اختصاراً بـ CRUD: الإنشاء (Create) حين يُضاف سجل جديد كحساب مصرفي جديد، والقراءة (Read) حين يُستعلم عن رصيد أو معلومة، والتحديث (Update) حين يتغير رقم هاتف عميل، والحذف (Delete) حين تُغلَق حسابات. هذه العمليات الأربع تمثل دورة حياة البيانات كاملةً في أي نظام رقمي.
محرك قاعدة البيانات (Database Engine) هو القلب النابض الذي يُحكم إدارة الذاكرة والتخزين الفيزيائي. يعمل المحرك على تحسين توزيع البيانات بين ذاكرة الوصول العشوائي (RAM) والتخزين الدائم (Persistent Storage)، عبر آلية تُسمى إدارة ذاكرة التخزين المؤقت (Buffer Pool Management). كلما كانت البيانات الأكثر طلباً محتجزة في الذاكرة السريعة، انخفض زمن الاستجابة بصورة ملموسة. هذا ما يجعل خوادم قواعد البيانات في المنشآت الكبرى تمتلك ذاكرات وصول عشوائي بمئات الغيغابايتات.
مفارقة هندسية لافتة: نظام إدارة قاعدة البيانات Oracle يعمل في بعض البيئات المصرفية الكبرى بخوادم تحتوي على أكثر من 24 تيرابايت من الذاكرة العشوائية، وذلك حصراً لتسريع القراءة وتقليل الاعتماد على الأقراص. (المصدر: Oracle Database Architecture Documentation)
التصنيف المعماري الكبير: SQL مقابل NoSQL
قواعد البيانات العلائقية (Relational Databases): النظام والصرامة
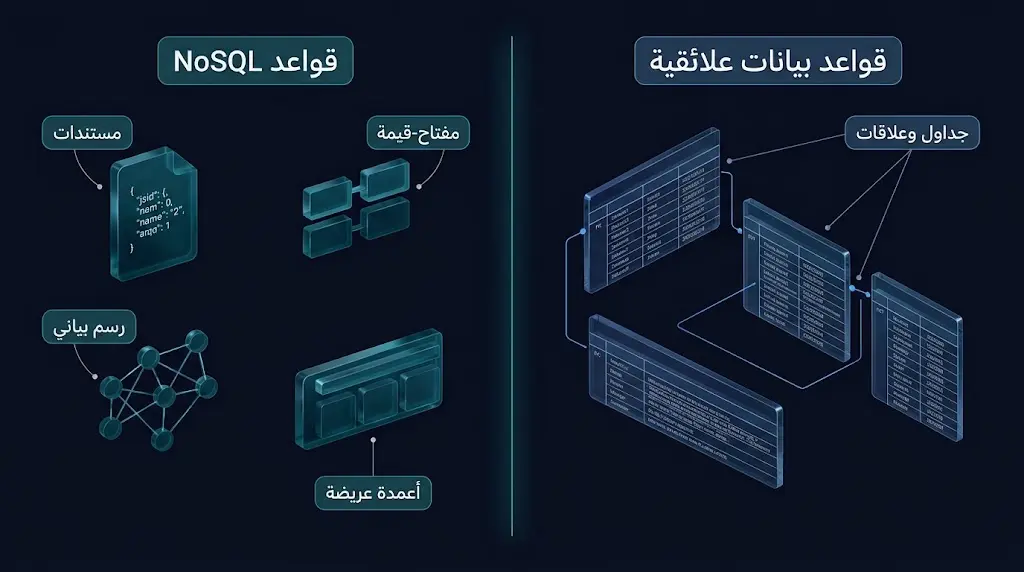
قواعد البيانات العلائقية (Relational Databases) تنظم البيانات في جداول (Tables) تتكون من صفوف وأعمدة، وفق مخطط صارم (Schema) يُحدَّد مسبقاً. تحتل العلاقات بين الجداول مكانة محورية في هذا النظام؛ إذ تتحقق عبر مفتاحين: المفتاح الرئيس (Primary Key) الذي يُعرّف كل سجل بصورة فريدة داخل جدوله، والمفتاح الأجنبي (Foreign Key) الذي يُنشئ الرابط بين جدولين مختلفين. يُشبَّه هذا النظام بسجلات بلدية مدينة سعودية قديمة كالدرعية، إذ يُرتبط كل مواطن بعائلته بعائلتها بحيّها بمدينتها، في تسلسل هرمي محكم.
أشهر أنظمة قواعد البيانات العلائقية هي: MySQL وPostgreSQL وMicrosoft SQL Server وOracle Database، وتتصدر هذه الأنظمة استخدامات البنوك والشركات الحكومية والتجارة الإلكترونية الكلاسيكية.
قواعد البيانات غير العلائقية (NoSQL): المرونة والتوسع
على النقيض من ذلك، تتخلى قواعد البيانات غير العلائقية (Non-Relational / NoSQL Databases) عن الجداول الصارمة لصالح نماذج تخزين أكثر مرونة، تناسب التطبيقات التي تنمو على نحو أفقي (Horizontal Scaling) وتتعامل مع بيانات متغيرة البنية. تنقسم هذه القواعد إلى أنواع رئيسة:
- قواعد المستندات (Document Stores): تخزن البيانات في وثائق شبيهة بصيغة JSON، كما في MongoDB وCouchDB. تناسب تطبيقات المحتوى ومنصات التجارة الإلكترونية المعقدة.
- قواعد المفتاح-القيمة (Key-Value Stores): تعمل بمنطق القاموس البسيط حيث لكل مفتاح قيمة واحدة، كما في Redis وAmazon DynamoDB. تتفوق في التخزين المؤقت (Caching) وإدارة الجلسات.
- قواعد الرسوم البيانية (Graph Databases): تُعبّر عن البيانات كعقد (Nodes) وعلاقات (Edges) بينها، كما في Neo4j. مثالية للشبكات الاجتماعية وتحليل الاحتيال المالي.
- قواعد الأعمدة العريضة (Wide-Column Stores): تخزن البيانات في أعمدة بدلاً من صفوف، كما في Apache Cassandra وGoogle Bigtable. تتحمل أحجاماً ضخمة من الكتابات المتزامنة.
لغة الأرقام الكونية: وفق تقرير DB-Engines لعام 2024، تحتل قواعد البيانات العلائقية MySQL وPostgreSQL وOracle المراتب الأولى عالمياً من حيث الانتشار، غير أن المصادر تُشير إلى نمو سنوي يتجاوز 25% في استخدام قواعد NoSQL في تطبيقات الحوسبة السحابية خلال الفترة 2022-2024.
اقرأ أيضاً:
معايير الاختيار بين النظامين
فما المعيار الفاصل في الاختيار؟ يُحدّده الجواب عن سؤالين: هل البيانات ذات بنية ثابتة ومحددة سلفاً؟ وهل الاتساق (Consistency) أهم من السرعة والتوسع؟ إذا كانت الإجابة بنعم على كليهما، فقواعد البيانات العلائقية هي الخيار الأمثل. بالمقابل، إذا كانت البيانات متغيرة البنية ويحتاج النظام إلى التوسع السريع لاستيعاب ملايين المستخدمين، تُصبح قواعد NoSQL الخيار الأجدر.
| النظام | النوع | نموذج التخزين | أقوى حالات الاستخدام | التوسع | ضمانات الاتساق | أمثلة التطبيق |
|---|---|---|---|---|---|---|
| PostgreSQL | علاائقي | جداول وصفوف | المعاملات المالية، الأنظمة الحكومية | رأسي + أفقي محدود | ACID كاملة | بنوك، أنظمة ERP |
| MySQL | علاائقي | جداول وصفوف | مواقع الويب، التجارة الإلكترونية | رأسي أساسي | ACID كاملة | WordPress، Shopify |
| Oracle Database | علاائقي | جداول وصفوف | المؤسسات الضخمة، الأنظمة المصرفية | رأسي متقدم | ACID كاملة | بنوك مركزية، أرامكو |
| Microsoft SQL Server | علاائقي | جداول وصفوف | تكامل بيئة Windows، تقارير BI | رأسي متقدم | ACID كاملة | حكومات، شركات كبرى |
| MongoDB | NoSQL – مستندات | مستندات JSON | المحتوى المتغير، كتالوج المنتجات | أفقي واسع | BASE / اتساق نهائي | noon، منصات محتوى |
| Redis | NoSQL – مفتاح-قيمة | ذاكرة في الوقت الفعلي | التخزين المؤقت، إدارة الجلسات | أفقي سريع جداً | محدودة | Snapchat، Twitter/X |
| Neo4j | NoSQL – رسم بياني | عقد وعلاقات | الشبكات الاجتماعية، كشف الاحتيال | رأسي أساسي | ACID جزئية | LinkedIn، أنظمة مكافحة غسيل أموال |
| Apache Cassandra | NoSQL – أعمدة عريضة | أعمدة موزعة | كتابة ضخمة متزامنة، IoT | أفقي لا محدود | BASE / اتساق نهائي | Netflix، Apple iCloud |
| Pinecone / Weaviate | متجهية (Vector) | متجهات رياضية عالية الأبعاد | الذكاء الاصطناعي، البحث الدلالي | أفقي سحابي | تقريبية | أنظمة RAG، Spotify، ChatGPT |
| وجه المقارنة | قواعد البيانات العلائقية (SQL) | قواعد البيانات غير العلائقية (NoSQL) |
|---|---|---|
| نموذج التخزين | جداول ذات صفوف وأعمدة محددة | مستندات، مفاتيح-قيم، رسوم بيانية، أعمدة |
| المخطط (Schema) | صارم ومحدد مسبقاً — لا تغيير أثناء التشغيل | مرن أو غائب — يتكيف مع البيانات المتغيرة |
| ضمانات الاتساق | ACID كاملة — اتساق فوري وصارم | BASE — اتساق نهائي قد يتأخر لحظات |
| لغة الاستعلام | SQL معيارية (ANSI 1986) موحدة بين الأنظمة | واجهات برمجية (APIs) متباينة بين الأنظمة |
| التوسع (Scaling) | رأسي أساساً — ترقية الخادم نفسه | أفقي — إضافة خوادم جديدة بسهولة |
| أداء الاستعلامات المعقدة | متفوق في JOIN متعدد الجداول والتقارير | محدود — مصمم للعمليات البسيطة السريعة |
| أداء الكتابة المتزامنة | مقيّد بآليات القفل وخصائص ACID | متفوق — يتحمل ملايين الكتابات بالثانية |
| بنية البيانات | ثابتة ومتجانسة — مناسبة للبيانات المنظمة | متغيرة وغير متجانسة — للبيانات شبه المنظمة |
| نضج النظام | أكثر من 50 عاماً — ناضج ومستقر | ظهر 2009+ — لا يزال يتطور بسرعة |
| أمثلة تطبيقية عربية | نظام SARIE، مستشفيات EHR، أنظمة الحكومة | noon (كتالوج)، منصات المحتوى، تطبيقات AI |
| الاختيار الأمثل عند | الاتساق أولوية والبيانات منظمة ومحددة | التوسع السريع والبيانات متغيرة البنية |
القواعد العلمية لاتساق البيانات وسلامتها
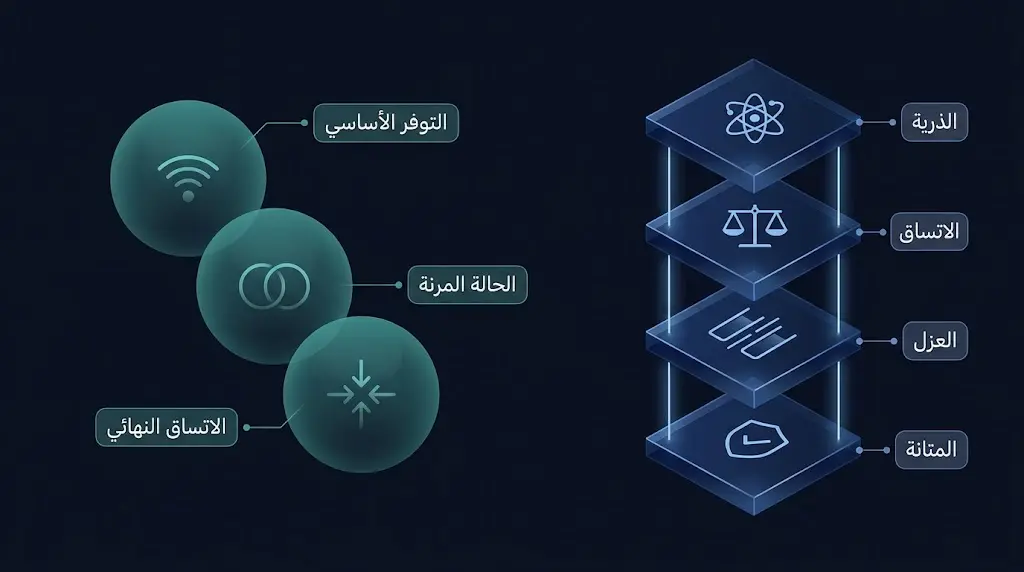
خصائص ACID: الضمان الذري للبيانات
خصائص ACID في قواعد البيانات العلائقية تُمثّل العقد الصارم الذي تلتزم به كل عملية تجرى على البيانات. الذرية (Atomicity): تعني أن كل عملية إما تُنفَّذ بالكامل أو لا تُنفَّذ أصلاً. تصوّر تحويلاً مالياً بين حسابين؛ إذا خُصم المبلغ من الحساب الأول ثم انقطعت الشبكة قبل إيداعه في الثاني، يُلغي النظام العملية كلها ويُعيد المبلغ. الاتساق (Consistency): يضمن أن كل عملية تنقل قاعدة البيانات من حالة صحيحة إلى حالة صحيحة أخرى، دون المساس بقواعد النزاهة. العزل (Isolation): يكفل أن العمليات المتزامنة لا تتدخل في بعضها، كأن تجري كل عملية في فقاعة مستقلة. المتانة (Durability): تضمن أن البيانات المُودَعة تبقى راسخة حتى في حالة انقطاع الكهرباء.
نموذج BASE: المرونة في مقابل الصلابة
بينما تتمسك قواعد البيانات العلائقية بخصائص ACID، اعتمدت قواعد NoSQL نموذجاً مختلفاً يُعرف بـ BASE: التوفر الأساسي (Basically Available) الذي يعني أن النظام يستجيب دائماً حتى وإن كانت البيانات غير محدّثة بعد، الحالة المرنة (Soft State) حيث قد تختلف قيمة البيانات مؤقتاً بين خوادم مختلفة، والاتساق النهائي (Eventual Consistency) الذي يعني أن البيانات ستصل إلى الاتساق في نهاية المطاف حتى وإن تأخرت لحظات. هذا التسامح مع التأخر هو ما يجعل قواعد NoSQL قادرة على التوسع لآلاف الخوادم الموزعة حول العالم.
التطبيع (Normalization): علم تقليل الفوضى
مفاهيم التطبيع (Normalization) هي العلم الذي يُقلّل التكرار في قواعد البيانات العلائقية ويُرسّخ نزاهتها. تمر عملية التطبيع بأشكال متعددة (Normal Forms)، تبدأ بالشكل الأول (1NF) الذي يُلزم كل خلية بأن تحتوي على قيمة ذرية واحدة، وتصل إلى الشكل الثالث (3NF) وما بعده لضمان أن كل عمود في الجدول يعتمد مباشرة على المفتاح الرئيس فحسب. من الناحية العملية، التطبيع يُشبَّه بتنظيم مستودع: بدلاً من تكديس كل شيء في كومة واحدة، يُخصَّص لكل صنف رفه وتسميته، مع قائمة مرجعية تُرشد إلى كل شيء.
رقم لافت للانتباه: دراسة نشرتها مجلة ACM SIGMOD عام 2023 خلصت إلى أن قواعد البيانات غير المُطبَّعة تستهلك في المتوسط 3 إلى 7 أضعاف حجم التخزين مقارنةً بنظيراتها المُطبَّعة، وهذا يُترجَم مباشرةً إلى تكاليف سحابية متضاعفة.
اقرأ أيضاً:
ما الذي يجعل الاستعلام سريعاً والبيانات قابلة للاسترجاع؟
لغة SQL: اللغة التي تُخاطب البيانات
لغة الاستعلام الهيكلية (Structured Query Language — SQL) هي اللغة الرسمية التي تُخاطب بها البرمجيات قواعد البيانات العلائقية. تقوم على أوامر واضحة: SELECT لاسترجاع البيانات، INSERT لإدراجها، UPDATE لتعديلها، DELETE لحذفها. ما يجعل SQL قوية هو قدرتها على تعريف العلاقات وتصفية البيانات بمعايير معقدة في سطر واحد.
أُعلن عن SQL بوصفها معياراً دولياً من قِبَل المعهد الأميركي للمعايير (ANSI) عام 1986، وظلت محتفظة بهذه المكانة حتى اليوم. الجدير بالذكر أن البيئة السعودية والعربية شهدت خلال الفترة 2020-2024 توسعاً ملحوظاً في الاعتماد على SQL من خلال أنظمة إدارة الموارد الحكومية (ERP) ومنصات الخدمات الرقمية.
الفهرسة (Indexing): السرعة في الاسترجاع
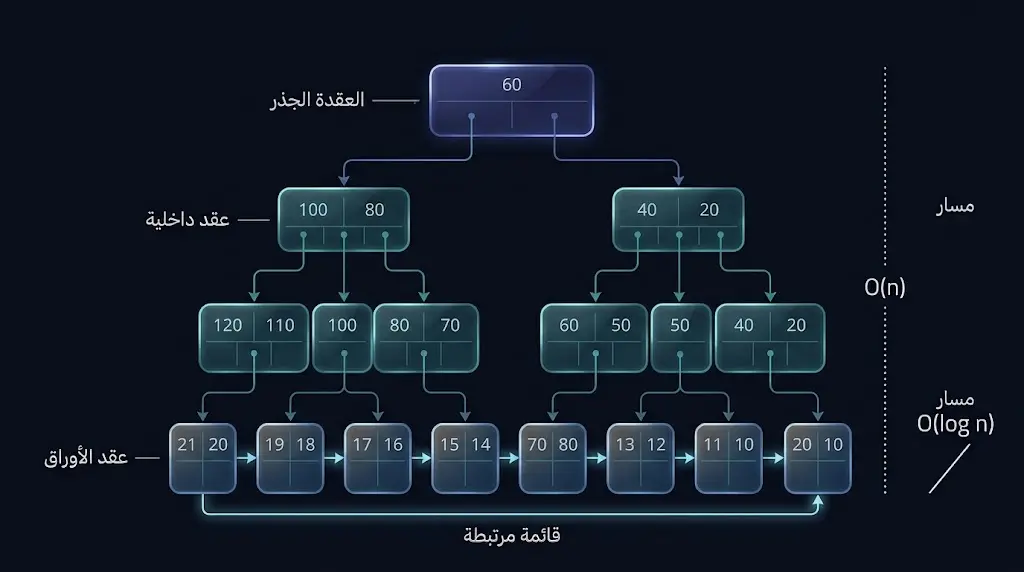
الفهرسة (Indexing) هي الأداة التي تُحوّل البحث في ملايين السجلات من عملية بطيئة إلى استجابة فورية. يعمل الفهرس في قاعدة البيانات بالمنطق ذاته الذي يعمل به فهرس الكتاب؛ بدلاً من قراءة كل صفحة للعثور على مصطلح، يُوجّهك الفهرس مباشرةً إلى الصفحة. تعتمد معظم قواعد البيانات على هياكل بيانات مثل أشجار B+ (B+ Trees) لتنظيم الفهارس، مما يُقلّص زمن البحث من O(n) إلى O(log n). هذا الفارق يعني عملياً أن البحث في مليار سجل يستغرق ثوانٍ بدلاً من دقائق.
من ناحية أخرى، الفهرسة المفرطة ليست حلاً مثالياً؛ إذ تُبطّئ عمليات الكتابة وتستهلك مساحة تخزينية إضافية، مما يستوجب موازنة دقيقة يتحكم فيها مهندس قواعد البيانات (Database Architect) وفق معدلات القراءة والكتابة في كل تطبيق.
معاملات الربط (JOIN Operations) تُتيح استخراج بيانات من جداول متعددة في آن واحد. INNER JOIN يُعيد الصفوف المتطابقة بين جدولين، بينما LEFT JOIN يُعيد جميع صفوف الجدول الأيسر مع المتطابق من الأيمن. في تطبيق تجارة إلكترونية عربي، استعلام واحد بـ JOIN قد يربط جدول العملاء بجدول الطلبات بجدول المنتجات في جملة واحدة، لاستخراج تقرير مبيعات كامل.
اقرأ أيضاً:
لماذا تفشل النماذج المبسّطة في وصف أداء قواعد البيانات تحت الحمل الشديد؟
من منظور التحليل العلمي المتقدم، يوضح المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية — أن التبسيط الشائع لأداء قواعد البيانات يميل إلى تصويره على أنه مجرد زمن استجابة للاستعلام (Query Response Time)، إلا أن النماذج التشغيلية الحديثة تكشف عن ديناميكية أعمق تتمثل في ظاهرة “انهيار الإنتاجية” (Throughput Collapse).
حين يتجاوز عدد الاتصالات المتزامنة (Concurrent Connections) طاقة مجمع الاتصالات (Connection Pool)، لا يزداد زمن الاستجابة بصورة خطية، بل يرتفع أسياً نتيجة الاحتكاك على الأقفال الداخلية (Lock Contention) وتزاحم الخيوط (Thread Contention). هذا المستوى من الدقة ضروري لفهم سلوك الأنظمة تحت الضغط القصوى (Peak Load)، وهو ما يُقود المهندسين إلى إستراتيجيات مثل تقسيم قاعدة البيانات (Sharding) وتوزيع الحمل (Read Replicas) بدلاً من الاكتفاء بتعزيز الخادم نفسه.
التكامل الوظيفي: قواعد البيانات في منظومة البيانات الأشمل
قواعد البيانات لا تعيش في عزلة هندسية. فهي المادة الخام الأولى التي يعتمد عليها مهندس البيانات (Data Engineer) لبناء أنابيب النقل (Data Pipelines) ومعالجة البيانات الضخمة (Big Data). المهندس يستخرج البيانات من قواعد البيانات المشغّلية (Operational Databases) ويُحوّلها إلى مستودعات بيانات (Data Warehouses) أو بحيرات بيانات (Data Lakes) تناسب التحليل الشامل.
وبالمقابل، يربط محلل البيانات (Data Analyst) أدواته مثل Tableau وPower BI مباشرةً بقواعد البيانات لاستخراج التقارير الآنية والمؤشرات التشغيلية. هذا الربط المباشر يمنح المحلل قدرةً على الاستعلام الحي عن الأرقام اليومية دون الحاجة إلى تصدير الملفات يدوياً.
كما أن مخرجات نماذج علم البيانات (Data Science) وعمليات تنقيب البيانات (Data Mining) تُحفظ بدورها في قواعد بيانات متخصصة، إذ تُخزَّن نتائج النماذج التنبؤية ومعاملاتها في جداول أو مستندات يُرجع إليها لاحقاً في بيئات الإنتاج (Production Environments).
اقرأ أيضاً:
- تحليل البيانات: المنهجية العملية لتحويل الأرقام إلى قرارات إستراتيجية
- علم البيانات: الركيزة العلمية لقيادة الذكاء الاصطناعي وصناعة القرار
أمان قواعد البيانات: الحصن الهندسي للمعلومات الحساسة
التشفير: الحماية في طبقتين
يوضح الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات في موقع خلية — أن منظومة الأمان لقواعد البيانات تستلزم حمايةً على مستويين لا يُجزأ أحدهما عن الآخر.
من خلال ممارستي في مجال الأمن السيبراني وحماية البيانات، ألاحظ أن كثيراً من المؤسسات العربية تهتم بتشفير البيانات في أثناء النقل (Encryption in Transit) وتُهمل تشفيرها أثناء التخزين (Encryption at Rest)، وهذا خطأ جوهري. فالبيانات المُخترَقة من قرص صلب مسروب تبقى قابلة للقراءة كاملاً إذا لم تُطبَّق تقنية تشفير قاعدة البيانات الشفاف (Transparent Data Encryption — TDE). التوصية هي تطبيق معيار تشفير AES-256 على كلا المستويين دون استثناء.
تشفير البيانات في أثناء النقل (Encryption in Transit) يعتمد على بروتوكولات TLS/SSL لحماية البيانات المتنقلة بين التطبيق وخادم قاعدة البيانات من الاعتراض. تشفير البيانات في أثناء التخزين (Encryption at Rest) يحمي الملفات المُخزَّنة على القرص حتى لو حصل المخترِق على وصول فيزيائي.
التحكم في صلاحيات الوصول (RBAC)
نظام التحكم في الوصول المبني على الأدوار (Role-Based Access Control — RBAC) يُقيّد كل مستخدم بالصلاحيات التي يحتاجها فعلاً، لا أكثر. موظف خدمة العملاء يقرأ بيانات الطلبات ولا يحذفها. مدير المخزن يُعدّل كميات المنتجات ولا يصل إلى الحسابات المالية. هذا التدرج في الصلاحيات يُطبّق مبدأ الحد الأدنى من الامتياز (Principle of Least Privilege) الذي يُقلّص حجم الضرر في حالة اختراق أي حساب.
الوقاية من حقن الاستعلامات (SQL Injection) تُعَدُّ من أخطر الثغرات الأمنية في التطبيقات الويب. تحدث حين يُدرج مهاجم كوداً برمجياً خبيثاً في حقل الإدخال، فيُخدع النظام وينفّذ الاستعلام الخبيث. وفق تقرير OWASP لعام 2023، احتلت هجمات الحقن المرتبة الثالثة في قائمة أخطر ثغرات تطبيقات الويب. الحماية منها تعتمد على الاستعلامات المُعدَّة مسبقاً (Prepared Statements) وعمليات التحقق من المدخلات (Input Validation).
النسخ الاحتياطي والتعافي من الكوارث
إستراتيجيات النسخ الاحتياطي الاحترافية تعتمد نهج 3-2-1: ثلاث نسخ من البيانات، على وسيطين تخزينيين مختلفين، مع نسخة واحدة خارج الموقع. التوفر العالي (High Availability — HA) يُحقَّق عبر مجموعات من الخوادم المتزامنة (Replica Sets) التي تتولى الخدمة فوراً إذا تعطّل الخادم الرئيس. التعافي من الكوارث (Disaster Recovery — DR) يشمل سياسات الاسترجاع الزمني (Point-in-Time Recovery) التي تُتيح إعادة قاعدة البيانات إلى لحظة محددة قبل وقوع الكارثة.
الدقيقة الواحدة تُكلّف ملايين: وفق دراسة صادرة عن Gartner، يبلغ متوسط تكلفة توقف نظام قاعدة البيانات لدى المؤسسات المتوسطة نحو 5,600 دولار في الدقيقة الواحدة، وهو رقم يُبرّر الاستثمار الضخم في بنى التوفر العالي والنسخ الاحتياطي.
| طبقة الحماية | التهديد المستهدف | الآلية التقنية | مستوى الخطر عند الإهمال | المعيار المرجعي | ملاحظة تطبيقية |
|---|---|---|---|---|---|
| تشفير النقل | اعتراض البيانات أثناء الإرسال | TLS 1.3 / SSL | عالٍ جداً | NIST SP 800-52 | إلزامي في كل اتصال بين التطبيق والخادم |
| تشفير التخزين | سرقة الأقراص الفيزيائية | AES-256 / TDE | عالٍ جداً | NIST FIPS 140-3 | شائع الإهمال في المنشآت الصغيرة |
| التحكم في الصلاحيات | الوصول غير المصرّح به | RBAC / ABAC | عالٍ جداً | ISO/IEC 27001 | مبدأ الحد الأدنى من الامتياز |
| الوقاية من SQL Injection | تنفيذ أوامر خبيثة | Prepared Statements / Input Validation | عالٍ جداً | OWASP Top 10 – 2023 | المرتبة 3 في أخطر الثغرات عالمياً |
| النسخ الاحتياطي | فقدان البيانات / الكوارث | نهج 3-2-1 / Point-in-Time Recovery | متوسط-عالٍ | ISO 22301 | تكلفة التوقف: 5,600 دولار / دقيقة |
| التوفر العالي | توقف الخدمة | Replica Sets / Failover تلقائي | متوسط-عالٍ | SLA 99.99% (Four Nines) | ضرورة حتمية للأنظمة المصرفية |
| إخفاء الهوية | انتهاك الخصوصية | Anonymization / Data Masking | متوسط | GDPR / PDPL السعودي | مطلب قانوني متصاعد في المنطقة العربية |
| مراقبة الأنشطة | الاختراق المتأخر الكشف | Database Activity Monitoring (DAM) | مقبول إذا طُبّق | PCI-DSS v4.0 | يكشف الأنماط الشاذة قبل وقوع الضرر |
اقرأ أيضاً:
- الأمن السيبراني: المبادئ الأساسية وأهميته في العصر الرقمي
- التشفير: الدليل العلمي الشامل لخوارزميات حماية البيانات ومستقبل الأمن السيبراني
- كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
تشريح آلية عمل الاستعلام من الطلب إلى النتيجة
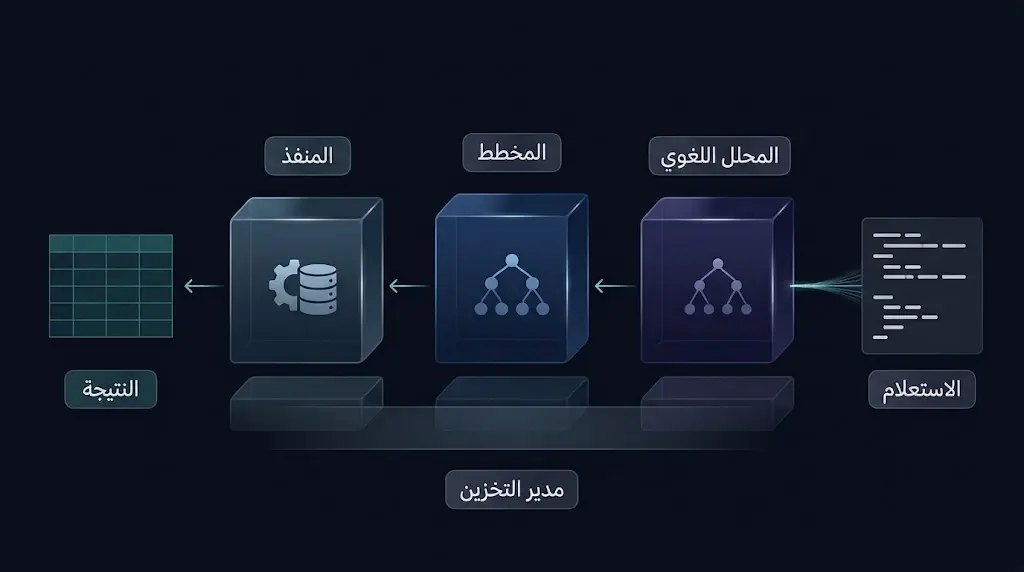
حين تُرسل تطبيق ما استعلاماً إلى قاعدة بيانات علاائقية كـ PostgreSQL، تبدأ سلسلة دقيقة من المعالجات الداخلية. المُحلِّل اللغوي (Parser): يُقرأ نص الاستعلام ويتحقق من صحة صياغته النحوية، مُحوِّلاً إياه إلى شجرة تحليل (Parse Tree). المُخطِّط (Planner / Optimizer): ينظر المحسّن في إحصائيات قاعدة البيانات ويُقيّم مسارات التنفيذ المتعددة، مختاراً الخطة الأقل تكلفةً حسابياً (Least-Cost Execution Plan). المُنفِّذ (Executor): يُطبّق الخطة المختارة، محيلاً الطلبات إلى مدير التخزين (Storage Manager) الذي يسترجع الصفحات من الذاكرة أو القرص.
هذه الثلاثة لا تعمل خطياً فحسب؛ بل يُراجع المُخطِّط أحياناً قراراته بناءً على بيانات إحصائية محدّثة، مما يجعل الاستعلام ذاته ينتج عنه خطط تنفيذ مختلفة بحسب توزيع البيانات في الجداول. هذا ما يُفسّر ظاهرة “انحراف الخطة” (Plan Regression) التي تُقلق مهندسي قواعد البيانات بعد تحديثات كبيرة.
اقرأ أيضاً:
المختبر الهندسي: البنية الداخلية لملف البيانات
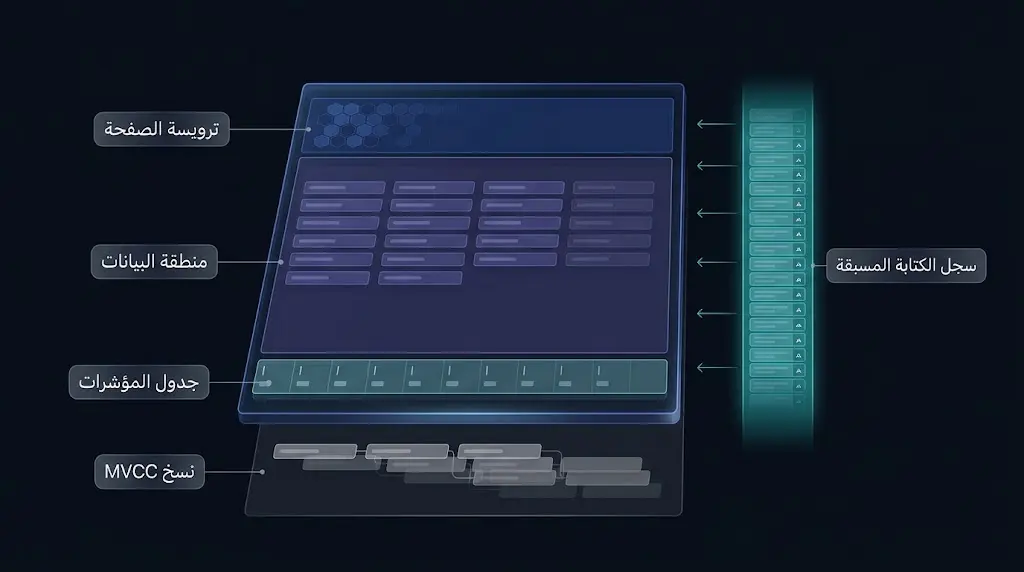
للمهتمين بالتفاصيل الدقيقة في بنية التخزين الفيزيائي
تخزّن قواعد البيانات العلاائقية بياناتها فيزيائياً في وحدات تُسمى الصفحات (Pages)، يبلغ حجم الصفحة القياسية في PostgreSQL 8 كيلوبايت وفي InnoDB (محرك MySQL) 16 كيلوبايت. تُجمَع هذه الصفحات في كتل أكبر تُسمى مساحات الجداول (Tablespaces).
تعتمد الفهارس بنية شجرة B+ (B+ Tree) التي تتميز بأن جميع القيم الفعلية تُخزَّن في أوراق الشجرة (Leaf Nodes)، بينما تحتوي العقد الداخلية على مفاتيح التوجيه فحسب. هذا يُتيح عمليات المسح المتسلسل (Range Scans) بكفاءة عالية؛ إذ إن الأوراق مرتبطة ببعضها في قائمة مرتبطة (Linked List). ارتفاع الشجرة نادراً ما يتجاوز 4 مستويات حتى مع مليارات السجلات، مما يُقلّص عدد عمليات القرص الضرورية (Disk I/O) إلى حدودها الدنيا.
سجل الكتابة المسبقة (Write-Ahead Log — WAL) هو الآلية التي تضمن خاصية المتانة (Durability) في ACID. كل عملية تعديل تُسجَّل في WAL قبل أن تُكتب على الصفحات الفعلية. عند انقطاع الطاقة، يُعيد نظام إدارة قواعد البيانات تطبيق السجلات المتبقية في WAL لاستعادة الحالة الاتساقية. معادلة زمن التعافي (Recovery Time) تعتمد على:
T_recovery = T_checkpoint_interval + T_WAL_replay إذ كلما قصر الفاصل الزمني بين نقاط التحقق (Checkpoint Interval)، قلّ زمن التعافي عند الانهيار.
على المستوى المجهري، تُنظَّم بيانات الصفحة وفق ترويسة (Page Header) تحتوي على معرّف الصفحة والمؤشرات، تليها منطقة البيانات الفعلية (Tuple Data)، وتنتهي بجدول المؤشرات (Item Pointer Array) الذي يُتيح تحديد مواضع السجلات داخل الصفحة دون قراءتها كاملةً. آلية MVCC (Multi-Version Concurrency Control) تُبقي إلى جانب كل سجل نسخاً تاريخية مؤقتة لضمان العزل بين المعاملات المتزامنة، وهو ما يُفسّر الحاجة إلى عملية تنظيف دورية تُعرف بـ VACUUM في PostgreSQL.
خرافات شائعة وحقائق هندسية
كثير مما يُشاع عن قواعد البيانات بين المطورين المبتدئين والمستخدمين العامين يفتقر إلى الدقة التقنية.
❌ الخرافة: قاعدة البيانات الأكبر حجماً دائماً أبطأ.
✅ الحقيقة: الأداء يعتمد على جودة التصميم والفهرسة، لا على الحجم وحده. قاعدة بيانات بمليار سجل ذات فهارس صحيحة قد تكون أسرع من قاعدة بمليون سجل سيئة التصميم.
❌ الخرافة: NoSQL أسرع دائماً من SQL.
✅ الحقيقة: الأداء يعتمد على نوع العملية وطبيعة البيانات. قواعد البيانات العلاائقية تتفوق في الاستعلامات المعقدة متعددة الجداول، بينما تتفوق NoSQL في الكتابة المتوازية عالية السرعة. (المصدر: دراسة مقارنة منشورة في IEEE Transactions on Knowledge and Data Engineering, 2022)
❌ الخرافة: تخزين كل شيء في قاعدة بيانات واحدة أبسط وأفضل.
✅ الحقيقة: هذا النهج يُنتج نقطة فشل واحدة (Single Point of Failure) ويُعيق التوسع. الأنظمة الحديثة تعتمد معمارية متعددة القواعد (Polyglot Persistence) إذ تُستخدم أنواع مختلفة من قواعد البيانات لأغراض مختلفة في النظام الواحد.
❌ الخرافة: قواعد البيانات السحابية أقل أماناً من قواعد البيانات المحلية (On-Premise).
✅ الحقيقة: مزودو السحابة الكبار كـ AWS وAzure وGoogle Cloud يستثمرون مليارات الدولارات في الأمان والامتثال، وكثيراً ما يُوفرون معايير حماية تفوق قدرة المؤسسات الصغيرة والمتوسطة على تحقيقها. (المصدر: Cloud Security Alliance Report, 2024)
❌ الخرافة: النسخ الاحتياطي اليومي كافٍ لأي نظام.
✅ الحقيقة: الأنظمة الحرجة تحتاج إلى نسخ احتياطي مستمر (Continuous Backup) مع نقطة استرجاع لا تتجاوز دقائق، لا ساعات. فقدان 24 ساعة من بيانات المرضى أو المعاملات المالية كارثة غير مقبولة.
من شاشة الهاتف إلى منصة أرامكو: أين تظهر قواعد البيانات في حياتنا؟
تطبيقات قواعد البيانات تمتد في النسيج الرقمي للحياة اليومية على نحو يكاد يكون غير منظور لغير المتخصصين.
في القطاع المالي والمصرفي
تُشغّل البنوك السعودية مثل البنك الأهلي وبنك الرياض قواعد بيانات علاائقية بالغة التعقيد لإدارة ملايين الحسابات والمعاملات اليومية. كل تحويل عبر نظام سريع (SARIE) يمر عبر معاملات ACID صارمة تضمن أن المبلغ لن يختفي بين المُرسِل والمُستقبِل.
في منصات التجارة الإلكترونية
منصات كـ noon وsouq (Amazon) تعتمد معمارية هجينة تجمع بين قواعد علاائقية لإدارة الطلبات والفواتير، وقواعد مستندية كـ MongoDB لإدارة كتالوج المنتجات المتغيرة الخصائص. هذا التوزيع يُتيح التوسع في موسم الذروة (مثل ليالي المبيعات الكبرى) دون تعطّل النظام.
في الأنظمة الصحية
مستشفيات المملكة العربية السعودية تُخزّن سجلات المرضى الإلكترونية (Electronic Health Records — EHR) في قواعد بيانات تلتزم بمعايير HL7 وFHIR؛ إذ إن أمان هذه القواعد وموثوقيتها ليسا مجرد متطلب تقني، بل شرط حيوي يُؤثّر على سلامة المرضى.
في أنظمة الذكاء الاصطناعي
نماذج الذكاء الاصطناعي الكبيرة تُخزّن تضميناتها (Embeddings) في قواعد بيانات متجهية (Vector Databases) كـ Pinecone وWeaviate وMilvus. هذه القواعد تُتيح البحث بالتشابه الدلالي (Semantic Similarity Search) الذي يُشغّل محركات البحث الذكية وأنظمة التوصيات.
السر الهندسي وراء تجربة المستخدم: حين يقترح عليك تطبيق Spotify أغنية “تناسبك”، فإن قاعدة بيانات متجهية تحسب المسافة الرياضية بين تضمين ذوقك الموسيقي وتضمينات ملايين الأغاني في ميلي ثانية. البنية الرياضية المستخدمة هي خوارزمية البحث عن الجار الأقرب التقريبي (Approximate Nearest Neighbor — ANN).
اقرأ أيضاً:
- الذكاء الاصطناعي: هندسة العقل الآلي من الخوارزميات الأولى إلى تكنولوجيا المستقبل
- الذكاء الاصطناعي التوليدي: كيف يعمل وما تطبيقاته في 2026؟
مدخل الطالب والمبتدئ إلى قواعد البيانات: من أين تبدأ؟
المفاهيم الأساسية التي يجب إتقانها أولاً
بالنسبة للطالب الجامعي أو المطور المبتدئ الذي يخطو أولى خطواته في عالم قواعد البيانات، ثمة ركائز معرفية لا غنى عنها قبل التعمق. فهم النموذج العلاائقي (Relational Model) بمفاهيمه الأساسية: الجداول، المفاتيح الرئيسة والأجنبية، والعلاقات بين الكيانات. إتقان أساسيات SQL من SELECT وWHERE وJOIN وGROUP BY، مع الفهم الحقيقي لما يجري وراء كل أمر. إدراك مفهوم التطبيع (Normalization) بأشكاله الأولى والثانية والثالثة. الاطلاع على الفرق المعماري بين النظامين العلاائقي وغير العلاائقي قبل الانغماس في أدوات محددة.
الأخطاء الشائعة التي يقع فيها المبتدئون
أكثر ما يُلاحظ من أخطاء المبتدئين هو خلط مفهوم قاعدة البيانات بمفهوم نظام إدارتها، كأنهما شيء واحد. ثانيها الاعتقاد بأن إتقان SQL وحده يُعني إتقان قواعد البيانات، بينما صميم الموضوع هو فهم التصميم المعماري. ثالثها إهمال التطبيع وإنشاء جداول ضخمة تضم كل شيء في مكان واحد (God Tables)، مما يُولّد مشكلات أداء مزمنة. رابعها اللجوء إلى الفهرسة المفرطة اعتقاداً بأنها تحلّ كل مشكلات البطء. الحقيقة أن الفهرس الزائد يُثقل عمليات الكتابة ويستنزف مساحة التخزين. التوصية هنا واضحة: ابدأ بتصميم مخطط الكيان-العلاقة (Entity-Relationship Diagram — ERD) قبل كتابة سطر SQL واحد.
اقرأ أيضاً:
الخطة التطبيقية لتصميم قاعدة بيانات من الصفر
الخطوات المتسلسلة لبناء قاعدة بيانات سليمة هندسياً
- تحليل المتطلبات: حدّد الكيانات الرئيسة في نظامك (مثل: عميل، منتج، طلب) قبل فتح أي أداة.
- رسم مخطط ERD: ارسم العلاقات بين الكيانات وحدّد نوع كل علاقة (واحد-لواحد، واحد-لكثير، كثير-لكثير).
- تحديد المفاتيح والقيود: خصّص مفتاحاً رئيساً لكل جدول، وحدّد القيود (Constraints) اللازمة للحفاظ على نزاهة البيانات.
- تطبيق قواعد التطبيع: مرر تصميمك عبر الأشكال الطبيعية (1NF → 2NF → 3NF) للتخلص من التكرار.
- اختيار نوع قاعدة البيانات: بناءً على طبيعة البيانات ومتطلبات التوسع، اختر بين الخيار العلاائقي وغير العلاائقي.
- بناء الفهارس بعناية: ابدأ بفهرسة المفاتيح الرئيسة والأجنبية والأعمدة الأكثر استخداماً في WHERE وJOIN.
- اختبار الأداء تحت الحمل: استخدم أدوات محاكاة الحمل كـ pgbench أو JMeter لاختبار الاستعلامات قبل الإطلاق.
كيف ترتبط قواعد البيانات بفروع علم الحاسوب والرياضيات؟
قواعد البيانات ليست جزيرة منعزلة؛ بل تتشابك مع فروع علمية متعددة تُغذّي بعضها البعض.
نظرية المجموعات (Set Theory): تقوم لغة SQL على مفاهيم نظرية المجموعات الرياضية؛ إذ إن عمليات UNION وINTERSECT وEXCEPT هي مباشرة ترجمة برمجية لعمليات الاتحاد والتقاطع والفرق بين المجموعات. فهم هذا الأساس يُرسّخ الحدس في كتابة الاستعلامات.
بنى البيانات والخوارزميات (Data Structures & Algorithms): أشجار B وB+ وخوارزميات الفرز والبحث هي العمود الفقري لمحركات قواعد البيانات. أداء الاستعلام يُحلَّل مباشرةً بمفاهيم التعقيد الحسابي O(n) وO(log n).
نظرية الاحتمالات والإحصاء (Probability & Statistics): المُحسِّن (Optimizer) في قاعدة البيانات يعتمد على توزيعات إحصائية للبيانات لاختيار خطة التنفيذ الأمثل. الإحصاءات الخاطئة تُنتج خططاً سيئة وأداءً رديئاً.
نظرية التوزيع (Distributed Systems Theory): قواعد البيانات الموزعة تصطدم بـ نظرية CAP (Consistency, Availability, Partition Tolerance) التي تُثبت رياضياً استحالة ضمان الثلاث خصائص في آن واحد، مما يفرض مقايضات هندسية صارمة في تصميم الأنظمة الموزعة.
اقرأ أيضاً:
التوصية العلمية من موقعنا
بوصفنا منصة علمية متخصصة تتابع التطورات في هندسة البيانات والبرمجيات، نُقدّم هذه التوصيات المبنية على الاتجاهات البحثية الحديثة (2023-2025):
- اعتماد نهج Polyglot Persistence بدلاً من قاعدة البيانات الوحيدة: الأنظمة الحديثة الناجحة لا تبحث عن “أفضل قاعدة بيانات” واحدة، بل تُصمّم لاستخدام أنواع مختلفة لأغراض مختلفة. Redis للتخزين المؤقت، PostgreSQL للمعاملات، Elasticsearch للبحث النصي، وWeaviate للبحث الدلالي. هذا التوزيع يُحقق أداءً يستحيل على نظام أحادي بلوغه.
- إدراج قواعد البيانات المتجهية (Vector Databases) في منهج التعلم: مع انتشار نماذج اللغة الكبيرة (LLMs) وتطبيقات الذكاء الاصطناعي التوليدي، أصبح التعامل مع Pinecone أو Weaviate مهارة جوهرية وليست مجرد تخصص. الاتجاه البحثي يُشير إلى أن هذه القواعد ستكون جزءاً من البنية التحتية القياسية بحلول 2026.
- إتقان مفهوم “التصميم للفشل” (Design for Failure): الأنظمة الحديثة لا تفترض أن الخوادم ستعمل دائماً. فهم آليات النسخ المتماثل (Replication) والتجزئة (Sharding) والتعافي التلقائي (Automatic Failover) ضروري لأي مهندس يعمل على أنظمة حرجة.
- مراقبة نظرية CAP وتداعياتها في التصميم: الأدلة الناشئة تُشير إلى أن الممارسات الهندسية تتجاوز ثنائية ACID-BASE نحو نماذج هجينة أكثر دقة، غير أن هذه النماذج لا تزال قيد التقييس والبحث وينبغي مواكبتها بحذر.
- الاستثمار في أدوات مراقبة قواعد البيانات (Database Observability): أدوات مثل pganalyze وDatadog وNew Relic تُتيح الكشف المبكر عن مشكلات الأداء قبل أن تُؤثّر على المستخدمين. هذه المنظومة تُعَدُّ امتداداً طبيعياً لمبادئ DevOps في عالم البيانات.
- ربط تصميم قواعد البيانات بمتطلبات الخصوصية (Privacy by Design): مع تصاعد تشريعات حماية البيانات في المنطقة العربية كنظام حماية البيانات الشخصية السعودي (PDPL)، أصبح مفهوم إخفاء الهوية (Anonymization) وتزييف البيانات (Data Masking) جزءاً لا يُجزأ من تصميم قواعد البيانات الجديدة.
- إعادة تقييم قرار التطبيع مقابل إلغاء التطبيع (Denormalization): في بيئات قراءة مكثفة (Read-Heavy) كالتقارير الضخمة، إلغاء التطبيع الجزئي المدروس يُحسّن الأداء تحسيناً جوهرياً. القرار ليس عقائدياً بل هندسياً ويخضع لمعدلات القراءة والكتابة الفعلية.
وفق تقرير معهد ماساتشوستس للتكنولوجيا (MIT) الصادر عام 2023 بعنوان “The Future of Data Infrastructure”، تُشغّل قواعد البيانات السحابية الموزعة ما يزيد على 65% من حجم البيانات التجارية العالمية، مع توقعات بأن يتجاوز سوق إدارة قواعد البيانات السحابية 150 مليار دولار بحلول عام 2027، مدفوعاً بالذكاء الاصطناعي وتطبيقات الحافة (Edge Computing).
اقرأ أيضاً:
المستقبل الهندسي: إلى أين تسير قواعد البيانات؟
صعود قواعد البيانات السحابية (Cloud-Native Databases) يُمثّل التحول الأعمق في بنية التخزين منذ اختراع النموذج العلاائقي. أنظمة مثل Amazon Aurora وGoogle Spanner وAzure Cosmos DB تُعيد تعريف مفهوم التوسع، إذ تُفرز بين طبقة الحوسبة وطبقة التخزين، مما يُتيح التوسع المستقل لكل منهما. Google Spanner تحديداً يدّعي تحقيق اتساق خارجي (External Consistency) على مستوى كوكبي، وهو ما كان يُعَدُّ مستحيلاً نظرياً قبل عقد.
قواعد البيانات المتجهية (Vector Databases) باتت ركيزة الذكاء الاصطناعي الحديث. فبدلاً من البحث عن القيمة المطابقة تماماً (Exact Match)، تبحث هذه القواعد عن أقرب المتجهات الرياضية في فضاء عالي الأبعاد. هذا يُشغّل أنظمة RAG (Retrieval-Augmented Generation) التي تُزوّد نماذج اللغة الكبيرة بمعرفة خارجية محدّثة. التوقعات البحثية (2024-2025) تُشير إلى دمج قواعد البيانات المتجهية مع قواعد البيانات العلاائقية التقليدية في أنظمة هجينة (Hybrid Vector + SQL).
إن المشهد الراهن لقواعد البيانات لا يُشبه الجمود؛ بل يُشبه حقل أبحاث حيّاً تتصادم فيه متطلبات الذكاء الاصطناعي مع قيود الفيزياء في سرعة الضوء والكمون الشبكي، ويتدافع فيه الباحثون لإيجاد توازن جديد بين الاتساق والسرعة والتوفر. فهل ستُنتج موجة قواعد البيانات السحابية الذكية من الجيل التالي نموذجاً يتجاوز القيود التي فرضتها نظرية CAP؟ هذا السؤال يحتل أجندة أبحاث قواعد البيانات في مختبرات MIT وGoogle وMicrosoft Research على حدٍّ سواء.
اقرأ أيضاً:
- الحاسوب الكمي: الدليل العلمي الشامل لفهم تكنولوجيا المستقبل وتأثيرها المرعب على العالم
- تعلم الآلة: كيف نبرمج الحواسيب لتفكر وتستنتج وتتخذ القرارات بنفسها
- التعلم العميق (Deep Learning): كيف تحاكي الآلات شبكات الدماغ البشري؟
يستند هذا المقال إلى أحدث المعايير والدلائل الإرشادية الرسمية المعتمدة في هندسة قواعد البيانات وأمن المعلومات:
- ISO/IEC 9075 (SQL Standard) — المعيار الدولي الرسمي للغة SQL بإصداراته المحدّثة، المنظمة الدولية للمعايير.
- NIST SP 800-111 / FIPS 140-3 — إرشادات تشفير قواعد البيانات ومعيار وحدات التشفير، المعهد الوطني الأميركي للمعايير والتقنية.
- OWASP Top 10 — 2023 — قائمة أخطر ثغرات تطبيقات الويب بما فيها حقن SQL، مؤسسة OWASP.
- ACM SIGMOD / VLDB Conference Proceedings — أبرز الأوراق البحثية المرجعية في هندسة قواعد البيانات.
- IEEE Transactions on Knowledge and Data Engineering — الدورية العلمية المحكّمة لأبحاث قواعد البيانات والبيانات الضخمة.
- ISO/IEC 27001:2022 — معيار إدارة أمن المعلومات الشامل بما فيها قواعد البيانات.
- ISO 22301:2019 — معيار استمرارية الأعمال والتعافي من الكوارث.
- نظام حماية البيانات الشخصية السعودي (PDPL) — الصادر بالمرسوم الملكي، يُنظّم معالجة بيانات الأشخاص وتخزينها في المملكة العربية السعودية.
- PCI DSS v4.0 — معيار أمن بيانات صناعة بطاقات الدفع، إلزامي لكل نظام يعالج بيانات الدفع.
المصادر والمراجع
الدراسات والأوراق البحثية:
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
الورقة التأسيسية للنموذج العلاائقي التي أسست علم قواعد البيانات الحديث. - Abadi, D., et al. (2022). The Seattle Report on Database Research. ACM SIGMOD Record. https://doi.org/10.1145/3524284.3524285
تقرير شامل يرصد توجهات أبحاث قواعد البيانات الأكثر حداثةً من باحثين في أبرز الجامعات العالمية. - Pavlo, A., & Aslett, M. (2016). What’s really new with NewSQL? ACM SIGMOD Record. [يُرجى إدراج الرابط يدوياً]تحليل معماري للجيل الجديد من قواعد البيانات الهجينة التي تجمع مرونة NoSQL مع ضمانات ACID.
الجهات الرسمية والمنظمات:
- OWASP Foundation (2023). OWASP Top Ten 2023. https://owasp.org/www-project-top-ten/
التقرير المرجعي لأخطر ثغرات أمان تطبيقات الويب، بما فيها حقن SQL. - National Institute of Standards and Technology — NIST (2023). Database Security Guidelines. https://www.nist.gov
الإرشادات الفيدرالية الأميركية لأمان قواعد البيانات ومعايير التشفير المعتمدة. - International Organization for Standardization — ISO/IEC 9075 SQL Standard. https://www.iso.org/standard/76583.html
المعيار الدولي الرسمي للغة SQL والإصدارات المحدّثة منها.
الكتب المرجعية:
- Ramakrishnan, R., & Gehrke, J. (2002). Database Management Systems (3rd ed.). McGraw-Hill.
يُعَدُّ من أشهر الكتب الأكاديمية الشاملة في هندسة قواعد البيانات، يُدرَّس في معظم الجامعات. - Date, C. J. (2003). An Introduction to Database Systems (8th ed.). Addison-Wesley.
مرجع كلاسيكي عميق يشرح النموذج العلاائقي وفلسفة التصميم من الجذور.
المقالات العلمية المبسطة:
- Hellerstein, J. (2023). What is a Database? Quanta Magazine perspective. [يُرجى إدراج الرابط يدوياً]مقالة تبسيطية موثوقة تشرح تطور مفهوم قاعدة البيانات للجمهور العلمي العام.
قراءات إضافية ومصادر للتوسع
- Gray, J., & Reuter, A. (1992). Transaction Processing: Concepts and Techniques. Morgan Kaufmann.
لماذا نقترح قراءته؟ يُعَدُّ هذا الكتاب المرجع الأعمق في علم معالجة المعاملات وخصائص ACID. يشرح بالتفصيل كيف تُبنى الأنظمة المصرفية والمالية الحرجة على هذه المفاهيم. مناسب لمن يريد فهم بنية المحرك الداخلي لقواعد البيانات. - Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.
لماذا نقترح قراءته؟ يُعَدُّ الكتاب الأكثر تأثيراً في العقد الأخير لمهندسي البيانات والأنظمة الموزعة. يغطي قواعد البيانات العلاائقية وغير العلاائقية والموزعة بمنهجية مقارنة رصينة، مع تحليل حالات الفشل والمقايضات الهندسية الواقعية. - Stonebraker, M., & Hellerstein, J. (Eds.). (2005). Readings in Database Systems (4th ed.). MIT Press. متاح مجاناً على: http://www.redbook.io
لماذا نقترح قراءته؟ مجموعة أوراق بحثية مختارة بعناية من قِبَل أبرز علماء قواعد البيانات في العالم، تُغطي المراحل التاريخية والتوجهات الحديثة. “الكتاب الأحمر” كما يُعرف في الأوساط الأكاديمية، مرجع أساس لكل باحث جاد في هذا الحقل.
تنويه علمي: بعض التطبيقات والتقنيات المذكورة في هذا المقال، لا سيما المتعلقة بقواعد البيانات المتجهية وأنظمة الذكاء الاصطناعي، لا تزال في طور التطور المتسارع؛ وقد تتغير بعض الخصائص والمعايير مع تقدم البحث العلمي والتقني. الاستخدامات الإنتاجية تستوجب دراسات متخصصة ومراجعة التوثيق الرسمي لكل نظام.
وكذلك تتصاعد اليوم تساؤلات جوهرية بين الباحثين حول مدى قدرة معمارية قواعد البيانات الحالية على مواكبة متطلبات نماذج الذكاء الاصطناعي التوليدي التي تتجاوز التريليون معامل؛ فهل ستُفرز الحاجة إلى معالجة هذا الحجم من البيانات جيلاً جديداً من قواعد البيانات يتجاوز جميع التصنيفات الحالية؟
الأرقام والإحصاءات المستشهد بها مُستقاة من مصادر علمية موثوقة حتى تاريخ إعداد المقال؛ وقد تتغير بعض الخصائص التقنية مع تطور الأنظمة. موقع خلية لا يتحمل أي مسؤولية قانونية أو تقنية ناتجة عن استخدام المعلومات الواردة دون الرجوع إلى المختصين المؤهلين.
الدكتور بكر وائل يبرودي — خبير الأمن السيبراني ومستشار حماية البيانات