تعلم الآلة فرع من فروع الذكاء الاصطناعي يُمكِّن الحواسيب من استخلاص أنماط رياضية من مجموعات بيانات ضخمة، ثم توظيف تلك الأنماط في التنبؤ واتخاذ القرارات دون برمجة صريحة لكل حالة على حدة. يعتمد هذا الحقل على أسس إحصائية ورياضية راسخة، وقد بلغت قيمته السوقية العالمية نحو 209 مليارات دولار عام 2024 وفقاً لتقديرات مؤسسة Grand View Research.
المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
الدكتور المهندس أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات
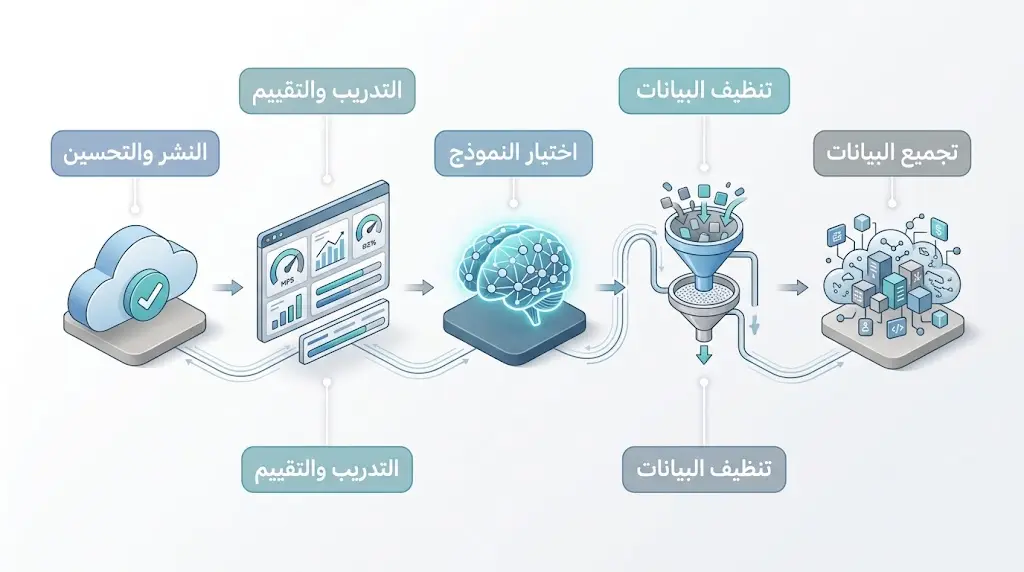
- تجميع البيانات وتنظيفها (60-80% من الوقت)
- اختيار الخوارزمية المناسبة
- التدريب عبر الانحدار التدريجي
- التقييم على بيانات جديدة
- النشر والتحسين المستمر
حين تقترح الشاشة فيلماً لم يخطر على البال
في كل مرة تعرض فيها منصة بث رقمي فيلماً يتوافق مع ذائقة المشاهد بدقة مذهلة، أو تتعرف كاميرا هاتف ذكي على وجه صاحبه في أجزاء من الثانية، تعمل في الخلفية خوارزميات تعلم الآلة التي غُذِّيت بملايين السجلات والصور سابقاً. هذه العمليات ليست ضرباً من السحر التقني، بل نتاج عقود من البحث في تحليل البيانات والإحصاء الحاسوبي. لقد غدا هذا المجال العصب الحيوي للثورة الصناعية الرابعة، إذ إنَّ القطاعات الاقتصادية والصحية والأمنية تعتمد عليه اعتماداً متصاعداً عاماً بعد عام.
كيف تُفرز خوارزمية بريد إلكتروني ملايين الرسائل يومياً؟
حين تصل رسالة إلكترونية إلى خادم بريد يعالج أكثر من 300 مليار رسالة يومياً على مستوى العالم، يبدأ نموذج تعلم آلي مدرَّب مسبقاً بتحليل سمات تلك الرسالة: تكرار كلمات معينة، بنية العنوان، عنوان المُرسِل، وأنماط الروابط المضمَّنة. يُقارن النموذج هذه السمات بملايين الأمثلة التي تدرَّب عليها سابقاً — رسائل صُنِّفت يدوياً على أنها مشروعة أو غير مرغوب فيها (Spam). خلال أجزاء من الألف من الثانية، يصدر النموذج حكمه الاحتمالي: نسبة 0.97 مثلاً لصالح تصنيف “بريد عشوائي”، فتنتقل الرسالة تلقائياً إلى مجلد الرسائل غير المرغوب فيها. لا يوجد مبرمج كتب قاعدة صريحة لكل سيناريو؛ الخوارزمية استنبطت القواعد بنفسها من البيانات.
ما تعلم الآلة وكيف يعمل؟ التعريف الدقيق الذي يُزيل الغموض
تعلم الآلة (Machine Learning) مصطلح صاغه عالم الحاسوب الأميركي آرثر صامويل (Arthur Samuel) عام 1959، وعرَّفه بأنه “الحقل الذي يمنح الحواسيب القدرة على التعلم دون أن تُبرمَج صراحةً”. يُعَدُّ هذا التعريف التاريخي نقطة انطلاق مفيدة، لكنه يحتاج إلى تدقيق معاصر. التعريف الأكثر صرامة الذي اقترحه توم ميتشل (Tom Mitchell) عام 1997 ينصّ على أن “برنامجاً حاسوبياً يُقال إنه يتعلم من تجربة E فيما يخص مهمة T ومقياس أداء P، إذا تحسَّن أداؤه في T — مقاساً بـ P — مع ازدياد التجربة E”. هذا التعريف يحوِّل مفهوم “التعلم” من استعارة بشرية غامضة إلى معيار رياضي قابل للقياس.
الفارق الجوهري بين تعلم الآلة والبرمجة التقليدية يتجلى في اتجاه تدفق المعلومات. في البرمجة التقليدية (Rule-Based Programming)، يُدخل المبرمج بيانات وقواعد محددة سلفاً، فيحصل على نتائج. على النقيض من ذلك، في تعلم الآلة يُدخَل إلى النظام بيانات ونتائج معروفة مسبقاً، فيستخرج النظام القواعد بنفسه. هذا الانقلاب في المنطق البرمجي هو ما يمنح نماذج التعلم الآلي قدرتها على التعامل مع مشكلات لا يمكن صياغة قواعدها يدوياً — كالتعرف على الكلام أو تصنيف الصور الطبية.
مفارقة تستوقف الباحثين
مصطلح “تعلم الآلة” ظهر قبل أن تمتلك الحواسيب ذاكرة كافية لتخزين مجموعات بيانات كبيرة؛ كان صامويل يدرِّب برنامجه على لعبة الداما باستخدام حاسوب IBM 701 الذي لا تتجاوز ذاكرته بضعة كيلوبايتات.
اقرأ أيضاً
ذاكرة الوصول العشوائي (RAM): الآلية، الأنواع، والتطور
الخريطة التي تفصل بين الذكاء الاصطناعي وتعلم الآلة والتعلم العميق
يقع تعلم الآلة ضمن بنية هرمية واضحة تُشبه دوائر متداخلة. الدائرة الكبرى تمثل الذكاء الاصطناعي (Artificial Intelligence)، وهو المظلة الأوسع التي تشمل كل محاولة لجعل الآلات تحاكي القدرات الذهنية البشرية — من التخطيط والاستدلال إلى معالجة اللغة الطبيعية. داخل هذه الدائرة تقع دائرة أصغر هي تعلم الآلة، أي الفرع التطبيقي الذي يعتمد على تغذية الحواسيب بالبيانات لاستخلاص الأنماط. وداخل دائرة تعلم الآلة نفسها تستقر دائرة أدق: التعلم العميق (Deep Learning)، وهو فرع متقدم يستخدم شبكات عصبية اصطناعية (Artificial Neural Networks) متعددة الطبقات لمعالجة بيانات غير مهيكلة كالصور والنصوص والأصوات.
الفرق بين الذكاء الاصطناعي وتعلم الآلة يُختصَر في أن الأول هدف واسع والثاني أداة تقنية محددة لتحقيق جزء من ذلك الهدف. فبرنامج شطرنج كلاسيكي يعمل بقواعد مشفَّرة يدوياً يندرج تحت الذكاء الاصطناعي، لكنه لا يستخدم تعلم الآلة. بالمقابل، برنامج AlphaGo الذي طورته شركة DeepMind عام 2016 استخدم التعلم العميق — وهو بالضرورة جزء من تعلم الآلة — للتفوق على بطل العالم في لعبة غو (Go). إذاً، كل تعلم عميق هو تعلم آلة، لكن ليس كل تعلم آلة تعلماً عميقاً.
رحلة البيانات: خمس محطات تمر بها الخوارزمية قبل أن تُصدر حكمها
تجميع البيانات وتنظيفها: الوقود الخام الذي يُشعل المحرك
لا تستطيع أي خوارزمية أن تتعلم شيئاً من فراغ. كل نموذج يحتاج إلى بيانات (Data)، وجودة تلك البيانات تحدد سقف أداء النموذج مهما بلغت تعقيداته الرياضية. تبدأ العملية بتجميع البيانات من مصادر متعددة: قواعد بيانات مؤسسية، سجلات حساسات إنترنت الأشياء (IoT Sensors)، صور أقمار اصطناعية، أو حتى نصوص مجمَّعة من الإنترنت. لكن البيانات الخام نادراً ما تكون نظيفة؛ فهي تحتوي على قيم مفقودة (Missing Values)، وتكرارات، وأخطاء إدخال، وتشوهات إحصائية. لذلك تمرّ بمرحلة تنظيف (Data Cleaning) ومعالجة مسبقة (Preprocessing) تشمل إزالة القيم الشاذة (Outliers)، وتوحيد التنسيقات، وتحويل البيانات النصية إلى تمثيلات رقمية. دراسة نشرتها مجلة Harvard Business Review عام 2023 أشارت إلى أن علماء البيانات يقضون نحو 60% إلى 80% من وقت المشروع في تنظيف البيانات وتهيئتها، مقابل 20% فقط في بناء النماذج وتقييمها.
اختيار النموذج البرمجي: لكل مشكلة خوارزمية تناسبها
بعد تهيئة البيانات، يأتي قرار حاسم: أي نموذج رياضي سيُستخدم؟ الاختيار لا يكون عشوائياً. يعتمد على طبيعة المشكلة — تصنيف (Classification) أم انحدار (Regression) أم تجميع (Clustering) — وعلى حجم البيانات المتاحة، ودرجة التعقيد المطلوبة. فنموذج بسيط كالانحدار الخطي (Linear Regression) يكفي لتنبؤات ذات متغير واحد في بيانات خطية السلوك، بينما تتطلب مهمة كتصنيف الصور الطبية شبكة عصبية تلافيفية (Convolutional Neural Network – CNN) بملايين المعاملات القابلة للتعديل. كما أن اختيار النموذج يتضمن موازنة بين التعقيد (Complexity) والقدرة على التعميم (Generalization)؛ فالنموذج المفرط التعقيد قد يحفظ بيانات التدريب حرفياً دون أن يتعلم الأنماط الحقيقية — وهي مشكلة تُعرف بالإفراط في التعلم أو التلاؤم المفرط (Overfitting).
مرحلة التدريب: حين تضبط الخوارزمية معاملاتها ذاتياً
التدريب (Training) هو قلب عملية تعلم الآلة. خلال هذه المرحلة، يُعرَض على النموذج جزء كبير من البيانات — يُسمى مجموعة التدريب (Training Set) — ويبدأ بتعديل معاملاته الداخلية (Parameters) بصورة تكرارية لتقليل الفرق بين تنبؤاته والنتائج الفعلية. هذا الفرق يُقاس بدالة خسارة (Loss Function)، والهدف هو تصغير قيمتها. آلية التصغير الأكثر شيوعاً هي الانحدار التدريجي (Gradient Descent)، إذ يحسب النموذج ميل دالة الخسارة بالنسبة لكل معامل ثم يُحدِّثه بمقدار صغير في الاتجاه الذي يُقلل الخطأ. يُشبَّه هذا السلوك بشخص يقف على قمة تل ضبابي ويريد الوصول إلى أخفض نقطة في الوادي؛ فيتحسس الأرض بقدميه ويخطو دائماً نحو الأسفل.
السر الرياضي وراء التدريب
في كل دورة تدريب واحدة (Epoch)، قد تُحدَّث ملايين المعاملات آلاف المرات. نموذج GPT-4 مثلاً يحتوي على ما يُقدَّر بأكثر من تريليون معامل، ما يعني أن عملية تدريبه تتطلب طاقة حوسبية تُقاس بمئات الملايين من دولارات البنية التحتية.
اقرأ أيضاً
شات جي بي تي من الداخل: تشريح الخوارزميات وبنية الشبكات العصبية
التقييم والاختبار: الامتحان الذي يكشف كفاءة النموذج
بعد التدريب، يُختبَر النموذج على بيانات لم يرها من قبل — تُسمى مجموعة الاختبار (Test Set). الغرض من هذا الفصل منع النموذج من “الغش”؛ فلو قِيس أداؤه على البيانات نفسها التي تدرب عليها، لبدت نتائجه ممتازة حتى لو كان يحفظ الأمثلة دون فهم حقيقي. مقاييس الأداء تختلف باختلاف المهمة: في مهام التصنيف يُستخدم مقياس الدقة (Accuracy) ومصفوفة الارتباك (Confusion Matrix) ومنحنى المساحة تحت المنحنى (AUC-ROC). وفي مهام الانحدار يُستخدم الجذر التربيعي لمتوسط مربع الخطأ (RMSE). فإذا أظهر النموذج أداءً جيداً على بيانات الاختبار يُقال إنه يتمتع بقدرة تعميم عالية؛ وإذا كان أداؤه على بيانات التدريب ممتازاً لكنه سيئ على بيانات الاختبار، فذلك مؤشر واضح على التلاؤم المفرط.
اقرأ أيضاً
الإحصاء التطبيقي: كيف يحول البيانات إلى قرارات واقعية؟
النشر والتحسين المستمر: النموذج لا يتوقف عن التطور
حين يجتاز النموذج مرحلة التقييم، يُنشر (Deployment) في بيئة الإنتاج ليبدأ بالتعامل مع بيانات حقيقية متدفقة. لكن النشر ليس نهاية المطاف؛ البيانات في العالم الحقيقي تتغير بمرور الوقت — وهي ظاهرة تُعرف بانزياح البيانات (Data Drift) أو انزياح المفهوم (Concept Drift). نموذج تنبؤ بأسعار العقارات في الرياض مثلاً قد يفقد دقته بعد عام إذا تغيرت ديناميكيات السوق العقاري. لذلك تُعاد معايرة النماذج دورياً بإعادة تدريبها على بيانات محدَّثة، مع مراقبة مؤشرات الأداء باستمرار عبر أنظمة تُعرف باسم MLOps — وهو اختصار لعمليات تعلم الآلة (Machine Learning Operations).
الأعمدة الثلاثة: أنواع خوارزميات التعلم الآلي وآليات عملها
التعلم الخاضع للإشراف: حين يُقدَّم الجواب مع السؤال
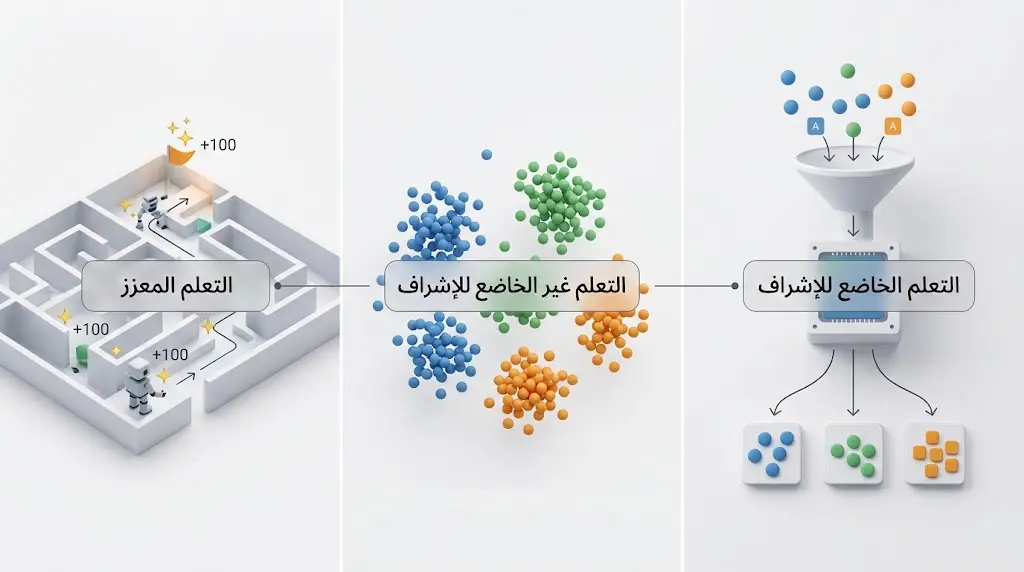
التعلم الخاضع للإشراف (Supervised Learning) هو النوع الأكثر انتشاراً في التطبيقات التجارية. المبدأ مباشر: يتلقى النموذج أمثلة مُعنوَنة (Labeled Data)، أي أزواج من المدخلات والمخرجات الصحيحة المقابلة لها. ثم يبحث عن دالة رياضية تربط بين المدخلات والمخرجات بأقل قدر من الخطأ. تُقسم مهام هذا النوع إلى فرعين: تصنيف (Classification) حين يكون المخرج فئة محددة — كتصنيف بريد إلكتروني إلى “مشروع” أو “عشوائي” — وانحدار (Regression) حين يكون المخرج قيمة عددية مستمرة — كتقدير سعر منزل استناداً إلى مساحته وموقعه.
من أبرز تطبيقاته تصنيف الصور الطبية للكشف المبكر عن الأورام، وتصفية رسائل البريد العشوائي، والتنبؤ بأسعار الأسهم، واكتشاف المعاملات المالية الاحتيالية. دراسة نشرتها مجلة Nature Medicine عام 2024 أظهرت أن نماذج التعلم الخاضع للإشراف المدرَّبة على صور الأشعة السينية للصدر حققت دقة تشخيصية بلغت 94.6% في اكتشاف حالات الالتهاب الرئوي، وهي نسبة تقارب أداء أطباء الأشعة ذوي الخبرة.
التعلم غير الخاضع للإشراف: اكتشاف بنى خفية لا يراها البشر
التعلم غير الخاضع للإشراف (Unsupervised Learning) يتعامل مع بيانات غير مُعنوَنة (Unlabeled Data). لا يُخبَر النموذج بالإجابة الصحيحة مسبقاً، بل يُترك ليكتشف بنى وأنماطاً كامنة في البيانات بمفرده. أبرز تقنياته التجميع (Clustering)، إذ يُقسَّم النموذج مجموعة البيانات إلى عناقيد (Clusters) بحيث تكون العناصر داخل كل عنقود متشابهة قدر الإمكان ومختلفة عن العناصر في العناقيد الأخرى. خوارزمية K-Means مثلاً تبدأ بتحديد عدد العناقيد المرغوب (K)، ثم تُعيِّن مراكز عشوائية، ثم تُكرِّر عملية إعادة تعيين كل نقطة بيانات إلى أقرب مركز وتحديث المراكز حتى يستقر التوزيع.
من تقنياته أيضاً تقليل الأبعاد (Dimensionality Reduction) باستخدام خوارزميات مثل تحليل المركبات الرئيسة (PCA – Principal Component Analysis) الذي يضغط بيانات ذات مئات المتغيرات في بُعدين أو ثلاثة مع الاحتفاظ بأكبر قدر من التباين الإحصائي. يُستخدم هذا النوع على نطاق واسع في تقسيم شرائح العملاء لدى شركات التجزئة الكبرى، واكتشاف موضوعات مخفية في كميات هائلة من النصوص، وتحليل الجينوم البشري لاكتشاف مجموعات جينية مرتبطة بأمراض معينة.
الفرق الجوهري بكلمات مكثفة
التعلم الخاضع للإشراف يتعلم من أمثلة موسومة بإجاباتها الصحيحة، بينما التعلم غير الخاضع للإشراف يستكشف البنية الخفية في بيانات “صامتة” لا تحمل أي تسمية مسبقة.
| وجه المقارنة | التعلم الخاضع للإشراف | التعلم غير الخاضع للإشراف |
|---|---|---|
| طبيعة البيانات | بيانات موسومة بإجاباتها | بيانات خام دون تسميات |
| الهدف الرئيس | التنبؤ بمخرج معلوم | اكتشاف بنى خفية |
| المهام النموذجية | تصنيف وانحدار | تجميع وتقليل أبعاد |
| مقياس الأداء | دقة واضحة قابلة للقياس | مقاييس تماسك داخلية |
| تكلفة إعداد البيانات | مرتفعة (تسمية يدوية) | منخفضة نسبياً |
| الخوارزميات الشهيرة | Linear Regression — SVM — CNN | K-Means — PCA — DBSCAN |
| أمثلة تطبيقية | تشخيص طبي وكشف احتيال | تقسيم عملاء وتحليل جينوم |
| قابلية التفسير | أعلى نسبياً | أدنى نسبياً |
التعلم المعزز: التعلم عبر المحاولة والخطأ والمكافأة
التعلم المعزز (Reinforcement Learning) يختلف جذرياً عن النوعين السابقين. لا يتلقى النموذج — الذي يُسمى هنا “الوكيل” (Agent) — أمثلة مُعنوَنة ولا بيانات غير مهيكلة فحسب، بل يتفاعل مع بيئة (Environment) ديناميكية. في كل خطوة زمنية، يتخذ الوكيل إجراءً (Action)، فتستجيب البيئة بحالة جديدة (State) ومكافأة رقمية (Reward) — إيجابية إن كان الإجراء مفيداً، وسلبية إن كان ضاراً. هدف الوكيل هو تعظيم المكافأة التراكمية على المدى الطويل.
يُشبَّه هذا النمط بطريقة تعلم طفل ركوب الدراجة: كل سقوط يمثل مكافأة سلبية تدفعه لتعديل توازنه، وكل متر يقطعه بنجاح يمثل مكافأة إيجابية تعزز السلوك الصحيح. من أشهر تطبيقاته: تدريب الروبوتات على المشي والتلاعب بالأشياء، وبرنامج AlphaGo الذي هزم بطل العالم في لعبة غو، والسيارات ذاتية القيادة التي تتعلم التنقل في بيئات مرورية معقدة. هذا وقد نُشرت دراسة في مجلة Science Robotics عام 2023 أظهرت أن روبوتاً مدرَّباً بالتعلم المعزز تمكن من إتقان مهام تجميع صناعية معقدة خلال ساعات بدلاً من أسابيع البرمجة التقليدية.
| الخوارزمية | نوع التعلم | المهمة الأساسية | مثال تطبيقي | مستوى التعقيد |
|---|---|---|---|---|
| الانحدار الخطي | خاضع للإشراف | انحدار | التنبؤ بأسعار العقارات | منخفض |
| شجرة القرار | خاضع للإشراف | تصنيف وانحدار | تقييم مخاطر الائتمان | متوسط |
| الغابات العشوائية | خاضع للإشراف | تصنيف وانحدار | كشف الاحتيال المالي | متوسط – مرتفع |
| K-Means | غير خاضع للإشراف | تجميع | تقسيم شرائح العملاء | منخفض – متوسط |
| PCA | غير خاضع للإشراف | تقليل أبعاد | تحليل الجينوم البشري | متوسط |
| الشبكات العصبية التلافيفية | خاضع للإشراف | تصنيف صور | تشخيص الأشعة الطبية | مرتفع جداً |
| Q-Learning | معزز | اتخاذ قرار متسلسل | تدريب الروبوتات | مرتفع |
| Transformers | خاضع للإشراف / ذاتي | معالجة لغة | الترجمة الآلية والتلخيص | مرتفع جداً |
الآلات الرياضية التي تُحرك نماذج التعلم الآلي
الانحدار الخطي: أبسط خوارزمية وأعمقها دلالة
الانحدار الخطي (Linear Regression) هو حجر الأساس في تحليل البيانات ونماذج التعلم الآلي. مبدأه: إيجاد خط مستقيم يمثل أفضل تقريب للعلاقة بين متغير مستقل (X) ومتغير تابع (Y). المعادلة الأساسية:<p dir=”ltr” style=”text-align: left; font-family: inherit; font-size: 1.1em;”>Y = β₀ + β₁X + ε</p>
إذ يمثل β₀ نقطة تقاطع الخط مع المحور الرأسي (Intercept)، وβ₁ يمثل ميل الخط (Slope) أي مقدار التغير في Y عند زيادة X بوحدة واحدة، وε يمثل حد الخطأ (Error Term). تُحسب قيم β₀ وβ₁ بطريقة المربعات الصغرى (Ordinary Least Squares – OLS) التي تُصغِّر مجموع مربعات الفروق بين القيم الفعلية والقيم المتوقعة. رغم بساطته، يبقى الانحدار الخطي أداة تفسيرية قوية تكشف عن اتجاهات البيانات وتقدم تنبؤات أولية موثوقة.
أشجار القرار: سلسلة من الأسئلة المنطقية المتفرعة
شجرة القرار (Decision Tree) خوارزمية تصنيفية وانحدارية تُحاكي عملية اتخاذ قرار بشري منطقي. تبدأ من عقدة جذرية (Root Node) تمثل السؤال الأكثر أهمية في فصل البيانات، ثم تتفرع إلى عقد فرعية بناءً على إجابات متتالية حتى تصل إلى عقد طرفية (Leaf Nodes) تمثل القرار النهائي. معيار الانقسام الأمثل يعتمد على مقاييس كالإنتروبيا (Entropy) أو مؤشر جيني (Gini Index)؛ كلاهما يقيس درجة عدم النقاء (Impurity) في مجموعة البيانات عند كل عقدة. الخوارزمية تختار عند كل مستوى السمة التي تُنتج أكبر مكسب معلوماتي (Information Gain) — أي التي تقلل عدم النقاء بأكبر قدر ممكن.
من مزاياها سهولة التفسير والتصور البصري، لكنها تعاني من ميل شديد نحو التلاؤم المفرط إذا سُمح لها بالتعمق دون قيود.
الغابات العشوائية: حكمة الجماعة تتفوق على الفرد
الغابات العشوائية (Random Forests) — التي اقترحها ليو بريمان (Leo Breiman) عام 2001 — تعالج نقاط ضعف شجرة القرار المنفردة عبر مبدأ التعلم الجماعي (Ensemble Learning). تُبنى عشرات أو مئات الأشجار، كل واحدة تتدرب على عينة عشوائية فرعية من البيانات (Bootstrap Sample) ومجموعة عشوائية فرعية من السمات. ثم يُجمَّع إخراج كل الأشجار بالتصويت (في التصنيف) أو بالمتوسط (في الانحدار) لإنتاج تنبؤ نهائي أكثر استقراراً ودقة. يُشبَّه هذا المبدأ باستشارة لجنة من الخبراء بدلاً من الاعتماد على خبير واحد؛ الأخطاء الفردية تتلاشى حين تُجمَّع الأحكام.
يوضح المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية — أن الغابات العشوائية لا تزال من أكثر الخوارزميات استخداماً في المسابقات العلمية لتحليل البيانات (مثل Kaggle)، لأنها تحقق توازناً نادراً بين دقة التنبؤ وسهولة الضبط وقلة الحساسية تجاه الضوضاء في البيانات — وهي ميزة تفتقر إليها كثير من النماذج الأحدث والأكثر تعقيداً.
لماذا تعجز النماذج المبسطة عن وصف سلوك الخوارزمية الحقيقي؟
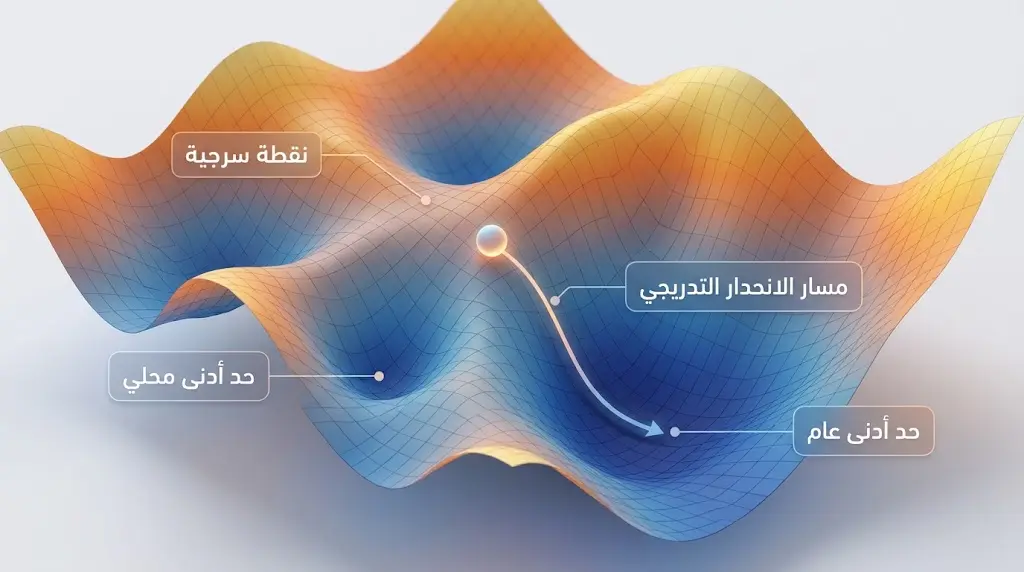
من منظور التحليل العلمي المتقدم، يوضح الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات في موقع خلية — أن التبسيط الشائع لخوارزميات تعلم الآلة يميل إلى تصويرها على أنها عمليات تحسين أحادية البعد تبحث عن أدنى نقطة في دالة خسارة سلسة ومنتظمة، إلا أن أحدث الأبحاث الرياضية تكشف عن ديناميكية أعمق تتمثل في أن فضاءات الخسارة الحقيقية (Loss Landscapes) للشبكات العصبية العميقة متعددة الأبعاد وشديدة التعرج، تحتوي على ملايين النقاط السرجية (Saddle Points) والحدود الدنيا المحلية (Local Minima) التي قد تحبس الخوارزمية في حلول دون المثلى. دراسة رياضية بارزة نشرها فريق من معهد ماساتشوستس للتكنولوجيا (MIT) عام 2023 أثبتت أن خوارزميات الانحدار التدريجي العشوائي (SGD – Stochastic Gradient Descent) تنجح جزئياً لأن عشوائيتها الضمنية تساعدها على “القفز” خارج الحدود الدنيا المحلية الضحلة والتوجه نحو حدود دنيا أوسع وأكثر تعميماً — وهي ظاهرة لا تفسرها النماذج الخطية المبسطة. هذا المستوى من الدقة ضروري لفهم سبب نجاح بعض النماذج وفشل أخرى رغم تشابه بنيتها الظاهرية.
ما بين الخرافة والحقيقة: مفاهيم مغلوطة عن تعلم الآلة
❌ الخرافة: تعلم الآلة يمنح الحواسيب وعياً وقدرة على التفكير المستقل كالبشر.
✅ الحقيقة: الحواسيب لا تمتلك وعياً ولا فهماً حقيقياً؛ خوارزميات تعلم الآلة تكتشف ارتباطات إحصائية في البيانات وتستخدمها للتنبؤ، دون أي إدراك لمعنى ما تفعله. تقرير صادر عن الجمعية الأميركية لتقدم العلوم (AAAS) عام 2024 أكد أن مصطلح “ذكاء” في سياق الآلات استعارة مجازية وليس وصفاً حرفياً.
❌ الخرافة: كلما زادت كمية البيانات تحسَّن أداء النموذج تلقائياً.
✅ الحقيقة: الكمية وحدها لا تكفي. بيانات متحيزة أو مشوهة أو مكررة قد تُدهور الأداء بدلاً من تحسينه. جودة البيانات وتنوعها وتمثيلها الصحيح للمشكلة عوامل أهم من حجمها المطلق.
❌ الخرافة: خوارزميات تعلم الآلة محايدة وموضوعية لأنها رياضية بحتة.
✅ الحقيقة: الخوارزميات تعكس التحيزات الموجودة في البيانات التي تُدرَّب عليها. دراسة نُشرت في مجلة Science عام 2023 أظهرت أن نماذج لغوية كبرى أعادت إنتاج صور نمطية عرقية وجندرية موجودة في بيانات التدريب المأخوذة من الإنترنت.
❌ الخرافة: تعلم الآلة سيحل محل جميع الوظائف البشرية قريباً.
✅ الحقيقة: تقرير المنتدى الاقتصادي العالمي لعام 2025 يُقدِّر أن تعلم الآلة سيُلغي 85 مليون وظيفة لكنه سيخلق 97 مليون وظيفة جديدة بحلول 2027، أغلبها يتطلب مهارات بشرية لا تستطيع الآلة محاكاتها كالإبداع والتفاوض والحكم الأخلاقي.
من غرفة العمليات إلى أرضية المصنع: أين يُحدث تعلم الآلة فرقاً حقيقياً؟
التشخيص الطبي المبكر وقراءة الصور الإشعاعية
في قطاع الرعاية الصحية، غيَّرت نماذج التعلم الآلي قواعد اللعبة في التشخيص المبكر. خوارزميات التعلم العميق المدرَّبة على مئات الآلاف من صور الأشعة المقطعية (CT Scans) وصور الرنين المغناطيسي (MRI) أصبحت قادرة على اكتشاف أورام بأحجام أقل من 3 مليمترات — وهو حد يصعب على العين البشرية رصده باستمرار. نظام الذكاء الاصطناعي الذي طورته شركة Google Health لفحص سرطان الثدي عبر تصوير الثدي بالأشعة السينية (Mammography) أظهر انخفاضاً في النتائج الإيجابية الكاذبة بنسبة 5.7% مقارنة بأطباء الأشعة البشريين، وفقاً لدراسة نُشرت في مجلة Nature عام 2020 وجرى تحديث نتائجها عام 2024.
في منطقة الخليج العربي تحديداً، أعلنت هيئة الصحة في أبو ظبي عام 2024 عن تبني أنظمة تعلم آلي لتحليل صور شبكية العين واكتشاف اعتلال الشبكية السكري مبكراً — وهو مرض شائع في المنطقة بسبب معدلات السكري المرتفعة.
كشف الاحتيال المالي والتداول الخوارزمي
في القطاع المالي، تعتمد البنوك الكبرى على خوارزميات تعلم الآلة لتحليل أنماط المعاملات في الزمن الحقيقي (Real-Time) واكتشاف السلوكيات الشاذة التي تُشير إلى احتيال محتمل. نماذج مثل الغابات العشوائية والشبكات العصبية الدورية (RNN – Recurrent Neural Networks) تفحص مئات المتغيرات في كل معاملة — الموقع الجغرافي، التوقيت، المبلغ، نمط الإنفاق التاريخي — وتصدر حكمها في أقل من 50 مللي ثانية. كذلك يستخدم التداول الخوارزمي (Algorithmic Trading) نماذج تنبؤية لاتخاذ قرارات بيع وشراء بسرعات يستحيل على المتداول البشري مجاراتها.
رقم يستحق الانتباه
وفقاً لتقرير صادر عن شركة Juniper Research عام 2024، وفَّرت أنظمة كشف الاحتيال المعتمدة على تعلم الآلة نحو 10 مليارات دولار سنوياً للمؤسسات المالية عالمياً.
الصيانة التنبؤية في المصانع وسلاسل الإمداد
في القطاع الصناعي، تُراقب حساسات (Sensors) مثبتة على الآلات مؤشرات كالاهتزاز ودرجة الحرارة وضغط الزيت، وتُغذي بياناتها نماذج تعلم آلي تتنبأ بالأعطال قبل حدوثها بأيام أو أسابيع. هذا النهج — المعروف بالصيانة التنبؤية (Predictive Maintenance) — يُقلل فترات التوقف غير المخطط لها ويوفر تكاليف باهظة. شركة أرامكو السعودية مثلاً أعلنت عام 2023 عن توظيف نماذج تعلم آلي لمراقبة معدات الحفر والتكرير، مما أسهم في خفض تكاليف الصيانة وتحسين كفاءة الإنتاج.
وفقاً لتقرير صادر عن معهد ماكينزي العالمي (McKinsey Global Institute)، فإن الصيانة التنبؤية المعتمدة على تعلم الآلة قادرة على تقليل تكاليف صيانة المعدات الصناعية بنسبة 10% إلى 40%.
أنظمة التوصية: الخوارزمية التي تعرف ذوقك قبل أن تعرفه بنفسك
كل توصية فيلم أو أغنية أو منتج تظهر على شاشة هاتف ذكي هي نتاج نموذج تعلم آلي يُحلل السلوك التاريخي للمستخدم ويقارنه بأنماط ملايين المستخدمين الآخرين. تقنية التصفية التعاونية (Collaborative Filtering) تعتمد على فرضية بسيطة لكنها فعالة: إذا أعجب المستخدم (أ) والمستخدم (ب) بنفس مجموعة الأفلام، فمن المرجح أن يُعجب المستخدم (أ) بفيلم شاهده (ب) ولم يشاهده هو بعد. تقنية التصفية القائمة على المحتوى (Content-Based Filtering) تعمل بمنطق مختلف: تحلل سمات المحتوى نفسه (النوع، المخرج، الكلمات المفتاحية) وتربطها بتفضيلات المستخدم. الأنظمة الحديثة تجمع بين المنهجين في ما يُسمى النماذج الهجينة (Hybrid Models). منصة Netflix مثلاً تعتمد على نموذج هجين يُقدَّر أنه يوفر لها نحو مليار دولار سنوياً من خلال تقليل معدل إلغاء الاشتراكات — وفقاً لتصريحات الشركة نفسها.
ركيزة حاسوبية تشترك فيها خمسة فروع علمية مختلفة
تعلم الآلة لا يعمل في جزيرة معرفية منعزلة، بل يتقاطع بعمق مع فروع علمية متعددة. الإحصاء الرياضي (Mathematical Statistics) يُقدم الأطر النظرية لتقدير المعاملات واختبار الفرضيات وبناء فترات الثقة. الجبر الخطي (Linear Algebra) يُوفر أدوات تمثيل البيانات كمصفوفات وأشعة ومعاملات تحويل — وبدونه يستحيل تنفيذ عمليات الضرب المصفوفي التي تقوم عليها الشبكات العصبية. نظرية الاحتمالات (Probability Theory) تُمكِّن النماذج البايزية (Bayesian Models) من التعامل مع عدم اليقين وتحديث المعتقدات بناءً على أدلة جديدة. نظرية التحسين (Optimization Theory) تُقدم خوارزميات البحث عن الحلول المثلى في فضاءات عالية الأبعاد. وأخيراً، علم الأعصاب الحاسوبي (Computational Neuroscience) ألهم بنية الشبكات العصبية الاصطناعية — وإن كانت الشبكات الحقيقية في الدماغ البشري أكثر تعقيداً بمراتب.
لغة الأرقام الفلكية
تدريب نموذج لغوي كبير مثل GPT-4 يستهلك طاقة كهربائية تُقدَّر بنحو 50 غيغاواط/ساعة — وهي كمية تكفي لتشغيل 5,000 منزل أميركي لمدة عام كامل، وفقاً لتقديرات باحثين في جامعة ماساتشوستس أمهرست.
التحديات التي تُقلق المهندسين والباحثين في آن واحد
التحيز في البيانات: حين تتعلم الآلة أخطاء البشر
مشكلة التحيز في البيانات (Data Bias) من أخطر التحديات التي تواجه خوارزميات تعلم الآلة. إذا تدرَّب نموذج على بيانات تمثل فئة سكانية واحدة بصورة مفرطة وتُهمل فئات أخرى، فإن تنبؤاته ستكون منحازة. مثال صارخ: نظام تعلم آلي طوَّرته شركة أميركية كبرى لفرز طلبات التوظيف تبيَّن أنه يُفضل المتقدمين الذكور لأن بيانات التدريب اعتمدت على سير ذاتية تاريخية أغلبها لرجال عملوا في الشركة سابقاً. فقد نشرت وكالة رويترز (Reuters) تحقيقاً تفصيلياً عام 2018 كشف عن هذه الحالة، وأُوقف النظام لاحقاً. المشكلة ليست في الخوارزمية ذاتها بل في البيانات التي تعكس تحيزات بشرية تاريخية مُتراكمة.
اقرأ أيضاً
كيفية حماية البيانات الشخصية على الإنترنت: كيف تحمي خصوصيتك الرقمية؟
معضلة الصندوق الأسود: حين يعجز المهندس عن تفسير قرار الآلة
بعض النماذج — خصوصاً الشبكات العصبية العميقة ذات الملايين من المعاملات — تتخذ قرارات دقيقة جداً لكنها صعبة التفسير. لا يستطيع المهندس أن يشرح بسهولة لماذا صنَّف النموذج صورة معينة على أنها “ورم خبيث” بدلاً من “ورم حميد”. هذه المعضلة — المعروفة بمشكلة الصندوق الأسود (Black Box Problem) — تُثير قلقاً خاصاً في المجالات الحساسة كالطب والقضاء. لذلك نشأ حقل فرعي كامل يُسمى الذكاء الاصطناعي القابل للتفسير (Explainable AI – XAI) يسعى إلى تطوير أدوات تكشف عن المنطق الداخلي للنماذج المعقدة — من أبرزها تقنية SHAP (SHapley Additive exPlanations) وتقنية LIME (Local Interpretable Model-agnostic Explanations).
استهلاك الموارد الحسابية والطاقة: ثمن بيئي باهظ
تدريب النماذج الكبيرة يتطلب آلاف وحدات معالجة الرسوميات (GPUs) لأسابيع متواصلة. دراسة نشرتها جامعة ماساتشوستس أمهرست عام 2023 قدَّرت أن تدريب نموذج لغوي كبير واحد يُطلق ما يعادل 300 طن من ثاني أكسيد الكربون — أي خمسة أضعاف الانبعاثات الكربونية لسيارة طوال عمرها الافتراضي. هذا يطرح تساؤلات جدية عن الجدوى البيئية لتوسيع النماذج دون حدود، ودفع باحثين عديدين نحو تطوير تقنيات “تعلم الآلة الأخضر” (Green ML) التي تهدف إلى تقليل البصمة الكربونية عبر ضغط النماذج (Model Compression) والتقطير المعرفي (Knowledge Distillation).
اقرأ أيضاً
البصمة الكربونية: ما هي وكيف تؤثر على مستقبل كوكبنا؟
ما الذي يحدث فعلاً داخل طبقات الشبكة العصبية؟ تفكيك دقيق لمن يريد الغوص أعمق
المختبر العلمي — للمهتمين بالتفاصيل الدقيقة
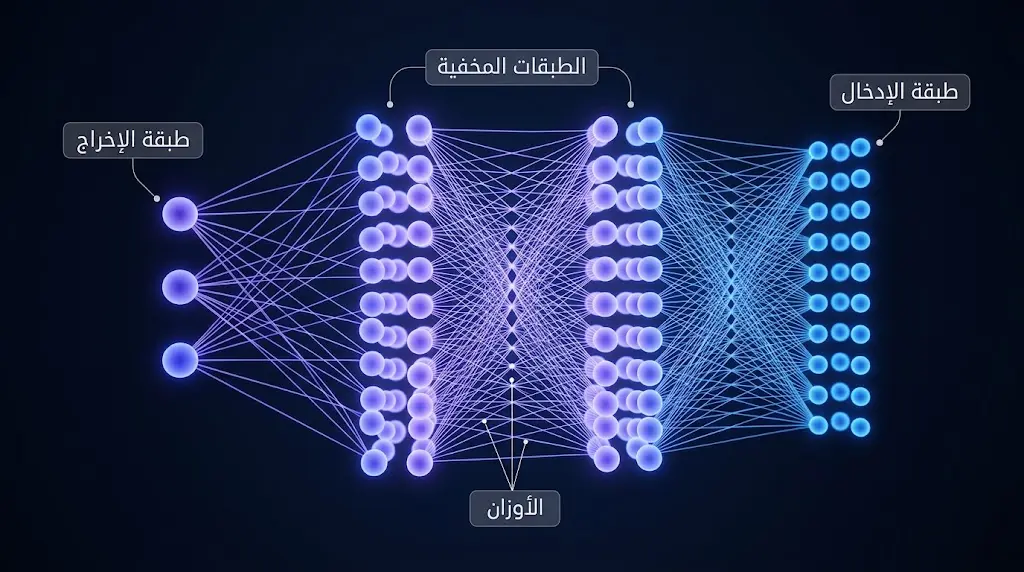
الشبكة العصبية الاصطناعية (Artificial Neural Network) تتألف من طبقات متتالية: طبقة إدخال (Input Layer) تتلقى البيانات الخام، وطبقة أو أكثر مخفية (Hidden Layers) تُجري عمليات حسابية، وطبقة إخراج (Output Layer) تُصدر التنبؤ النهائي. داخل كل طبقة، تتصل “العصبونات” (Neurons) بعصبونات الطبقة التالية عبر أوزان (Weights) تُحدَّد في أثناء التدريب.
كل عصبون يحسب مجموعاً مرجحاً (Weighted Sum) لمدخلاته ثم يمرره عبر دالة تنشيط (Activation Function) غير خطية. أبرز دوال التنشيط دالة ReLU (Rectified Linear Unit):
f(x) = max(0, x)
هذه الدالة تُمرر القيم الموجبة كما هي وتُحوِّل السالبة إلى صفر، مما يُدخل اللاخطية (Non-linearity) اللازمة لتمثيل علاقات معقدة. بدون دوال التنشيط اللاخطية، ستكون الشبكة بأكملها — مهما بلغ عدد طبقاتها — مكافئة رياضياً لنموذج خطي واحد.
في أثناء التدريب، يُحسب الخطأ في طبقة الإخراج ثم يُنشر عكسياً عبر الشبكة بأكملها بخوارزمية الانتشار العكسي (Backpropagation)، التي تستخدم قاعدة السلسلة (Chain Rule) في التفاضل لحساب مشتقة دالة الخسارة بالنسبة لكل وزن في كل طبقة. المعادلة الأساسية لتحديث الوزن:
w_new = w_old − η × (∂L/∂w)
إذ يمثل η معدل التعلم (Learning Rate) — وهو مُعامل فائق (Hyperparameter) بالغ الحساسية: قيمة مرتفعة جداً تجعل النموذج يتذبذب حول الحل الأمثل دون الاستقرار فيه، وقيمة منخفضة جداً تجعل التدريب بطيئاً إلى حد غير عملي. الشبكات العميقة الحديثة تستخدم مُحسِّنات متقدمة كـ Adam Optimizer تُعدِّل معدل التعلم تكيفياً لكل معامل على حدة، مما يُسرِّع التقارب ويُحسِّن الاستقرار.
الجدير بالذكر أن مسألة لماذا تعمل الشبكات العميقة بهذه الفعالية لا تزال غير محسومة نظرياً بالكامل؛ فالفجوة بين الأداء التجريبي الممتاز والفهم النظري الكامل لا تزال واحدة من أنشط مجالات البحث الرياضي في علوم الحاسوب اليوم.
من التشخيص الطبي إلى الزراعة الذكية: خريطة التطبيقات الواقعية
التطبيقات الصناعية والتكنولوجية لتعلم الآلة تتوسع بوتيرة متسارعة، لكن فهم حدودها لا يقل أهمية عن معرفة إمكاناتها.
المركبات ذاتية القيادة والملاحة الذكية
أنظمة القيادة الذاتية في شركات مثل Waymo وTesla تعتمد على طبقات متعددة من نماذج التعلم الآلي: شبكات عصبية تلافيفية لتحليل صور الكاميرات، ونماذج اندماج حسّي (Sensor Fusion) تدمج بيانات الليدار (LiDAR) والرادار والكاميرا في تمثيل ثلاثي الأبعاد موحَّد للبيئة المحيطة، ونماذج تعلم معزز لاتخاذ قرارات القيادة في الزمن الحقيقي. في الخليج العربي، أعلنت هيئة الطرق والمواصلات في دبي عام 2024 عن تجارب لسيارات أجرة ذاتية القيادة ضمن مسارات محددة، مما يعكس الاهتمام المتزايد بهذه التقنية في المنطقة.
الزراعة الدقيقة في المناطق الجافة
في البيئات الجافة كمنطقة شبه الجزيرة العربية وشمال إفريقيا، تُستخدم نماذج تعلم الآلة لتحليل صور الأقمار الاصطناعية وبيانات حساسات التربة للتنبؤ باحتياجات الري المحلية وتوقيت التسميد الأمثل. هذا النهج — المعروف بالزراعة الدقيقة (Precision Agriculture) — يُقلل هدر المياه بنسبة تصل إلى 30% وفقاً لتقديرات منظمة الأغذية والزراعة للأمم المتحدة (FAO). كما أن نماذج التعلم الآلي المُدرَّبة على بيانات مناخية تاريخية تساعد المزارعين في توقع موجات الحر والجفاف وتعديل خططهم الزراعية وفقاً لذلك.
اقرأ أيضاً
- الزراعة الذكية: التكنولوجيا والبيانات لتحسين المحاصيل
- المبادئ الأساسية للزراعة المستدامة: المفهوم، التقنيات، والتطبيقات
تحليل النصوص ومعالجة اللغة الطبيعية
نماذج معالجة اللغة الطبيعية (NLP – Natural Language Processing) المعتمدة على تعلم الآلة — مثل نماذج المحوِّلات (Transformers) — أحدثت ثورة في الترجمة الآلية، وتلخيص النصوص، وتحليل المشاعر (Sentiment Analysis)، وإنشاء المحتوى. في السياق العربي، أطلقت عدة مؤسسات بحثية نماذج لغوية مخصصة للعربية — من أبرزها نموذج “جيس” (Jais) الذي طُوِّر في أبو ظبي عام 2023 بالتعاون مع معهد الابتكار التكنولوجي (TII) ويُعَدُّ من أكبر النماذج اللغوية العربية المفتوحة المصدر.
الحدود العلمية والتحفظات المنهجية
تنويه علمي ضروري: بعض التطبيقات المذكورة أعلاه — خصوصاً في مجالات القيادة الذاتية الكاملة والتشخيص الطبي المستقل — لا تزال قيد البحث والتطوير، ولم تحصل بعد على اعتمادات تنظيمية شاملة في معظم الدول. النتائج قد تتغير مع تقدم العلم وتطور الأطر التنظيمية. أي تطبيق عملي يجب أن يخضع لإشراف مختصين ودراسات متخصصة قبل اعتماده.
بوابة الدخول إلى عالم خوارزميات التعلم الآلي: ما يحتاج الطالب والهاوي إلى معرفته أولاً
المفاهيم الأساسية التي يجب إتقانها قبل التعمق
- الجبر الخطي: فهم المصفوفات والأشعة وعمليات الضرب المصفوفي شرط أساسي لفهم كيفية تمثيل البيانات داخل النماذج.
- الاحتمالات والإحصاء: مفاهيم كالتوزيع الطبيعي (Normal Distribution)، والانحراف المعياري (Standard Deviation)، ونظرية بايز (Bayes’ Theorem) تشكل اللغة الرياضية التي تتحدث بها الخوارزميات.
- البرمجة بلغة Python: أغلب أدوات تعلم الآلة مبنية بهذه اللغة (مكتبات Scikit-learn، TensorFlow، PyTorch).
- حساب التفاضل والتكامل: فهم المشتقات ضروري لاستيعاب آلية الانحدار التدريجي والانتشار العكسي.
أخطاء شائعة يقع فيها المبتدئون
كثير من المبتدئين يقفزون مباشرة إلى بناء شبكات عصبية عميقة دون إتقان الأساسيات الرياضية، فيُعاملون المكتبات البرمجية كصناديق سوداء يضغطون أزرارها دون فهم ما يجري داخلها. خطأ آخر شائع هو تجاهل مرحلة تنظيف البيانات والقفز إلى التدريب — وهذا يُشبه بناء مبنى على أرض غير مستوية. كذلك يخلط كثيرون بين ارتفاع الدقة (Accuracy) على بيانات التدريب وجودة النموذج الحقيقية؛ فنموذج يحقق دقة 99% على بيانات التدريب لكنه يفشل على بيانات جديدة هو نموذج حفظ ولم يتعلم. والتوصية العلمية الأهم: البدء بخوارزميات بسيطة كالانحدار الخطي وأشجار القرار، ثم الصعود تدريجياً نحو النماذج الأكثر تعقيداً.
من خلال ممارسته البحثية والميدانية، يلاحظ المهندس عبد الله محمد جمال — خبير التقنيات الحديثة وهندسة البرمجيات في موقع خلية — أن كثيراً من الطلاب والهواة يخطئون في فهم العلاقة بين حجم النموذج وجودة أدائه، إذ يعتقدون أن زيادة عدد الطبقات والمعاملات تحسِّن النتائج دائماً، بينما الحقيقة أن نموذجاً أصغر مدرَّباً على بيانات نظيفة ومتوازنة يتفوق غالباً على نموذج ضخم مدرَّب على بيانات رديئة الجودة.
خطة عملية متدرجة لبناء أول نموذج تعلم آلي فعّال
- تحديد المشكلة بوضوح: قبل كتابة أي سطر برمجي، يجب صياغة السؤال المراد الإجابة عنه بدقة (مثلاً: “التنبؤ بسعر شقة بناءً على المساحة والموقع والطابق”).
- تجميع البيانات من مصدر موثوق: يمكن البدء بمجموعات بيانات مفتوحة المصدر من منصات مثل Kaggle أو UCI Machine Learning Repository.
- استكشاف البيانات وتنظيفها: رسم مخططات بيانية (Histograms، Scatter Plots) لفهم التوزيعات، والبحث عن القيم المفقودة والشاذة ومعالجتها.
- تقسيم البيانات: تخصيص 70-80% للتدريب و20-30% للاختبار، مع استخدام التحقق المتقاطع (Cross-Validation) لضمان متانة النتائج.
- البدء بنموذج بسيط: تطبيق الانحدار الخطي أو شجرة القرار أولاً، وقياس الأداء الأساسي (Baseline Performance).
- التحسين التدريجي: تجربة خوارزميات أعقد (غابات عشوائية، ثم شبكات عصبية إن لزم الأمر) ومقارنة نتائجها.
- توثيق كل خطوة: تسجيل الفرضيات والمعاملات والنتائج في دفتر ملاحظات (Jupyter Notebook) لضمان قابلية إعادة الإنتاج (Reproducibility).
- نشر النموذج واختباره في بيئة حقيقية: استخدام أدوات مثل Flask أو FastAPI لبناء واجهة برمجة تطبيقات (API) تتيح اختبار النموذج ببيانات جديدة.
التوصية العلمية من موقعنا
- إتقان الرياضيات قبل الأدوات البرمجية: فهم الجبر الخطي وحساب التفاضل والاحتمالات يمنح الباحث القدرة على تشخيص مشكلات النموذج بدقة بدلاً من تجربة حلول عشوائية — وهذا ما يميز عالم البيانات الحقيقي عن مستخدم أدوات جاهزة.
- التركيز على جودة البيانات وليس حجم النموذج: الاتجاه البحثي الحديث المعروف بـ “الذكاء الاصطناعي المتمركز حول البيانات” (Data-Centric AI) — الذي يقوده أندرو نغ (Andrew Ng) — يؤكد أن تحسين جودة البيانات يُحدث أثراً أكبر من تكبير النموذج في أغلب التطبيقات الواقعية.
- استكشاف الذكاء الاصطناعي القابل للتفسير (XAI): مع تزايد التطبيقات الحساسة، تتجه الأبحاث العالمية نحو نماذج تجمع بين الدقة العالية وقابلية التفسير، مما يعني أن الباحث الذي يتقن أدوات التفسير (SHAP، LIME) يملك ميزة تنافسية متصاعدة.
- الاهتمام بالأبعاد الأخلاقية والتنظيمية: تشريعات مثل قانون الذكاء الاصطناعي الأوروبي (EU AI Act) الصادر عام 2024 تفرض متطلبات صارمة على الشفافية والمساءلة، وأي باحث أو مهندس يتجاهل هذا البعد يُخاطر بتطوير منتجات غير قابلة للنشر قانونياً.
- متابعة الأبحاث المنشورة حديثاً في مستودع arXiv: هذا المستودع المفتوح يُنشر فيه يومياً عشرات الأوراق البحثية الجديدة في تعلم الآلة، مما يجعله أسرع قناة لمواكبة التطورات قبل نشرها رسمياً في المجلات.
- الربط بين تعلم الآلة وعلوم المجال (Domain Knowledge): خوارزمية ممتازة دون فهم عميق للمجال التطبيقي (الطب، المناخ، التمويل) تُنتج نتائج قد تبدو رياضياً صحيحة لكنها عملياً عديمة المعنى. الباحثون الأكثر تأثيراً في هذا الحقل هم من يجمعون بين الكفاءة الحاسوبية والخبرة التخصصية في ميدان التطبيق.
من الطب إلى المناخ: جيل جديد من التطبيقات لم يبلغ ذروته بعد
اكتشاف الأدوية وتسريع التجارب السريرية
شركات مثل DeepMind (عبر نموذج AlphaFold) وInsilico Medicine تستخدم تعلم الآلة لتقليص زمن اكتشاف الأدوية من عقد كامل إلى أشهر معدودة. نموذج AlphaFold 3 الذي أُعلن عنه عام 2024 أصبح قادراً على التنبؤ ببنية البروتينات والأحماض النووية والجزيئات الصغيرة معاً، مما يفتح آفاقاً غير مسبوقة لتصميم أدوية موجهة بدقة جزيئية.
اقرأ أيضاً
تطبيقات الذكاء الاصطناعي في علم الأدوية: التحديات والفرص
نمذجة المناخ والتنبؤ بالكوارث الطبيعية
نماذج تعلم الآلة تُدمج مع النماذج المناخية الفيزيائية التقليدية لتحسين دقة التنبؤات الجوية. نموذج GraphCast الذي طورته DeepMind عام 2023 أظهر قدرة على التنبؤ بالطقس لمدة 10 أيام بدقة تتفوق على نماذج المركز الأوروبي للتنبؤات الجوية متوسطة المدى (ECMWF) في بعض المؤشرات — وبسرعة تنفيذ تقل عن دقيقة واحدة بدلاً من ساعات.
اقرأ أيضاً
الأمن السيبراني والكشف عن التهديدات
في حقل الأمن السيبراني (Cybersecurity)، تُحلل خوارزميات تعلم الآلة حركة الشبكة (Network Traffic) في الزمن الحقيقي لاكتشاف أنماط سلوك شاذة قد تُشير إلى هجمات إلكترونية. هذا التطبيق ذو أهمية متزايدة في دول الخليج العربي التي تُدير بنى تحتية رقمية ضخمة في قطاعات النفط والغاز والمال.
مفارقة جديرة بالتأمل
نموذج تعلم آلي واحد مدرَّب على بيانات مناخية يمكنه خلال 60 ثانية إنجاز تنبؤ يستغرق حاسوباً فائقاً تقليدياً ساعات — لكنه يحتاج إلى ملايين الأمثلة التاريخية التي جمعها البشر على مدار عقود ليتعلم هذه القدرة.
وفقاً لتقرير صادر عن معهد ماساتشوستس للتكنولوجيا (MIT)، فإن تعلم الآلة صُنِّف عام 2024 ضمن العشر تقنيات الأكثر تأثيراً على مستقبل البشرية، إلى جانب الحوسبة الكمية والطاقة النظيفة.
| الحقبة | السنة | الحدث / الاكتشاف | الشخصية أو الجهة | الأثر العلمي |
|---|---|---|---|---|
| البدايات | 1959 | صياغة مصطلح “تعلم الآلة” | Arthur Samuel — IBM | تأسيس الحقل بلعبة الداما |
| التأسيس النظري | 1997 | التعريف الرياضي الصارم | Tom Mitchell — CMU | جعل “التعلم” قابلاً للقياس |
| عصر النماذج التجميعية | 2001 | خوارزمية الغابات العشوائية | Leo Breiman | ثورة في دقة النماذج التطبيقية |
| ثورة التعلم العميق | 2012 | فوز AlexNet في ImageNet | Hinton — Krizhevsky | انطلاق التعلم العميق تجارياً |
| عصر التعلم المعزز | 2016 | هزيمة AlphaGo لبطل العالم | DeepMind — Google | إثبات جدوى التعلم المعزز العميق |
| عصر المحوّلات | 2017 | ورقة “Attention is All You Need” | Google Brain | ولادة بنية Transformers |
| عصر البروتينات | 2020 | AlphaFold يحل بنية البروتين | DeepMind | ثورة في البيولوجيا الحاسوبية |
| العصر التوليدي | 2022 – 2024 | انتشار النماذج التوليدية الضخمة | OpenAI — Anthropic — Google | تحول شامل في صناعة المحتوى |
اقرأ أيضاً
- تخصصات الأمن السيبراني الرئيسية: المسارات الوظيفية والمهارات المطلوبة
- أمن المعلومات: الدليل العلمي الشامل لحماية البيانات ومواجهة التهديدات السيبرانية
تعلم الآلة في السياق العربي: بين الطموح والفجوة المعرفية
المنطقة العربية شهدت في السنوات الأخيرة اهتماماً متصاعداً بتعلم الآلة وتطبيقاته. إستراتيجية الإمارات للذكاء الاصطناعي 2031، ورؤية السعودية 2030 التي تضع التحول الرقمي في صلب أولوياتها، والهيئة السعودية للبيانات والذكاء الاصطناعي (SDAIA) التي أُنشئت عام 2019 — كلها مؤشرات على وعي إقليمي متنامٍ. لكن الفجوة بين الطموح والواقع لا تزال واسعة. فإن ندرة مجموعات البيانات العربية عالية الجودة، وقلة الكوادر المتخصصة في علوم البيانات مقارنة بالدول الصناعية الكبرى، وغياب أطر تنظيمية شاملة لحوكمة الذكاء الاصطناعي — كلها تحديات تحتاج إلى معالجة منهجية. ومع ذلك، فإن المبادرات الناشئة كإطلاق نموذج “جيس” اللغوي العربي ومراكز أبحاث الذكاء الاصطناعي في جامعة الملك عبد الله للعلوم والتقنية (KAUST) تمثل خطوات واعدة نحو ردم هذه الفجوة.
لغز رقمي يستحق التوقف
تُقدَّر الأوراق البحثية المنشورة عالمياً في حقل تعلم الآلة بأكثر من 400,000 ورقة سنوياً وفقاً لإحصاءات منصة Semantic Scholar عام 2024، مما يجعله واحداً من أسرع الحقول العلمية نمواً في التاريخ الحديث.
هل تفكر الآلة حقاً؟ الخط الفاصل الذي لا ينبغي تجاوزه
الحواسيب التي تعمل بخوارزميات تعلم الآلة لا تفكر. لا تفهم. لا تدرك. ما تفعله هو اكتشاف ارتباطات رياضية بين المتغيرات في مجموعات بيانات ضخمة، ثم استخدام تلك الارتباطات لإصدار تنبؤات. الآلة التي تصنف صورة قطة تصنيفاً صحيحاً لا تعرف ما القطة؛ إنها تعلمت أن توزيعاً معيناً من قيم البكسلات يرتبط احتمالياً بالتصنيف الذي حمل في بيانات التدريب اسم “قطة”. هذا التمييز ضروري لأنه يحمي من التوقعات المبالغ فيها ومن المخاوف غير المبررة في آن واحد.
الخطوة القادمة في مسيرة هذا الحقل قد تكون في اتجاهات عدة: نماذج أصغر وأكفأ تعمل على أجهزة طرفية (Edge AI) بدلاً من مراكز بيانات عملاقة، أو نماذج قادرة على التعلم من أمثلة قليلة جداً (Few-Shot Learning) بدلاً من ملايين العينات، أو خوارزميات هجينة تجمع بين التعلم من البيانات والاستدلال المنطقي الرمزي (Neuro-Symbolic AI). غير أن السؤال الأعمق يبقى معلقاً بين الرياضيات والفلسفة: هل يمكن لنظام يفتقر إلى الوعي أن يبلغ يوماً مستوى ذكاء عام يُضاهي الذكاء البشري — أم أن في بنية العقل البشري بُعداً يتجاوز حدود أي خوارزمية؟
اقرأ أيضاً
الذكاء الاصطناعي التوليدي: كيف يعمل وما تطبيقاته في 2026؟
يستند هذا المقال إلى أحدث المعايير والدلائل الإرشادية الرسمية المعتمدة في مجال تعلم الآلة والذكاء الاصطناعي:
- قانون الذكاء الاصطناعي الأوروبي (EU AI Act 2024) — الإطار التشريعي الأول عالمياً لحوكمة الذكاء الاصطناعي
- معايير NIST AI Risk Management Framework (AI RMF 1.0) — المعهد الوطني الأميركي للمعايير والتكنولوجيا
- مبادئ منظمة التعاون الاقتصادي والتنمية (OECD AI Principles 2019, updated 2024)
- معايير IEEE 7000 series — الأطر الأخلاقية لأنظمة الذكاء الاصطناعي
- توصيات UNESCO حول أخلاقيات الذكاء الاصطناعي 2021
- إطار ACM Code of Ethics — أخلاقيات علوم الحاسوب المهنية
- معايير ISO/IEC 42001:2023 — أنظمة إدارة الذكاء الاصطناعي
- إستراتيجية الإمارات للذكاء الاصطناعي 2031 والهيئة السعودية للبيانات والذكاء الاصطناعي (SDAIA)
المصادر والمراجع
- Mitchell, T. (1997). Machine Learning. McGraw-Hill.
— الكتاب المرجعي الأساسي الذي وضع التعريف الرياضي الصارم لتعلم الآلة. - Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5–32. DOI: 10.1023/A:1010933404324
— الورقة المؤسِّسة لخوارزمية الغابات العشوائية. - McKinney, S. M., et al. (2020). International evaluation of an AI system for breast cancer screening. Nature, 577, 89–94. DOI: 10.1038/s41586-019-1799-6
— دراسة أظهرت تفوق نموذج ذكاء اصطناعي في الكشف عن سرطان الثدي عبر صور الماموغرافي. - Lam, R., et al. (2023). Learning skillful medium-range global weather forecasting. Science, 382(6677), 1416–1421. DOI: 10.1126/science.adi2336
— دراسة نموذج GraphCast للتنبؤ بالطقس باستخدام تعلم الآلة. - Strubell, E., Ganesh, A., & McCallum, A. (2019). Energy and Policy Considerations for Deep Learning in NLP. Proceedings of the 57th Annual Meeting of ACL. DOI: 10.18653/v1/P19-1355
— دراسة رائدة في قياس البصمة الكربونية لتدريب النماذج اللغوية الكبرى. - Abramson, J., et al. (2024). Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature, 630, 493–500. DOI: 10.1038/s41586-024-07487-w
— الورقة الأصلية لنموذج AlphaFold 3 للتنبؤ ببنية الجزيئات البيولوجية. - European Parliament. (2024). Artificial Intelligence Act (EU AI Act). الرابط الرسمي
— النص التشريعي الأول من نوعه لتنظيم الذكاء الاصطناعي في الاتحاد الأوروبي. - Grand View Research. (2024). Machine Learning Market Size Report 2024–2030. [يُرجى إدراج الرابط يدوياً]— تقرير تحليلي لسوق تعلم الآلة العالمي وتوقعات نموه.
- Sengupta, S., et al. (2023). Jais and Jais-chat: Arabic-Centric Foundation and Instruction-Tuned Open Generative Large Language Models. arXiv preprint. arXiv:2308.16149
— الورقة التقنية لنموذج “جيس” اللغوي العربي المطوَّر في الإمارات. - World Economic Forum. (2023). Future of Jobs Report 2023. الرابط الرسمي
— تقرير يرصد تأثير الذكاء الاصطناعي وتعلم الآلة على سوق العمل العالمي.
قراءات إضافية ومصادر للتوسع
- Bishop, C. M., & Bishop, H. (2024). Deep Learning: Foundations and Concepts. Springer.
لماذا نقترح قراءته؟ هذا الكتاب تحديث شامل من مؤلف أحد أهم المراجع الكلاسيكية في تعلم الآلة (Pattern Recognition and Machine Learning)، ويُقدم شرحاً معاصراً ومتدرجاً للأسس الرياضية للتعلم العميق مع أمثلة تطبيقية حديثة. - Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. (متاح مجاناً عبر deeplearningbook.org)
لماذا نقترح قراءته؟ يُعَدُّ المرجع الأكاديمي الأكثر اكتمالاً في التعلم العميق، ويُغطي الجوانب النظرية والتطبيقية من الجبر الخطي والاحتمالات وصولاً إلى الشبكات التوليدية التنافسية. - Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press. (متاح مجاناً عبر incompleteideas.net)
لماذا نقترح قراءته؟ الكتاب المرجعي الأول في التعلم المعزز، يشرح الأسس النظرية من معادلات بلمان إلى تقنيات التعلم العميق المعزز التي تقود الروبوتات والسيارات ذاتية القيادة اليوم.
فما الذي سيتغير في هذا الحقل حين تبدأ الخوارزميات بتعلم مفاهيم جديدة من عشر عينات فقط بدلاً من ملايين — وهل سيُقرِّب ذلك الآلة من الذكاء البشري أم سيكشف عن فجوة أعمق ممّا نتصور؟
موقع خلية لا يتحمل أي مسؤولية قانونية أو علمية ناتجة عن استخدام المعلومات الواردة في هذا المحتوى دون الرجوع إلى المختصين المؤهلين.
الدكتور معاوية أحمد الحموي — أستاذ وباحث في الرياضيات
الدكتور المهندس أحمد نبيل طيفور — خبير هندسة الاتصالات والإلكترونيات